La recente esplosione del campo dell’Intelligenza Artificiale (AI), con l’avvento e l’uso massiccio dei grandi modelli linguistici (LLM), modelli di diffusione e altre forme di AI generativa, ci pone in una situazione senza precedenti, che ci costringe a ripensare non solo i concetti consolidati di paternità artistica e proprietà intellettuale, ma anche l’insieme di valori, pratiche e idee emerse durante l’era digitale. Il processo di espropriazione dei principi del software libero e della cultura open, e la loro sussunzione alla logica del tardo capitalismo, iniziato con l’adozione del modello Open Source da parte delle aziende tecnologiche all’inizio del XXI secolo, ha raggiunto un punto di svolta con la meccanica del machine learning (ML). Quest’ultima si basa sull’accumulo di contenuti culturali provenienti da tutto il web e sul loro sfruttamento nel processo di addestramento delle macchine, che per la maggior parte sono mantenute da grandi aziende che operano a scopo di lucro. I commons digitali sembrano volgere alla fine, sostituiti da nuove forme di privatizzazione. Condivisione e accesso aperto sembrano perdere il loro potenziale radicale, quando più che i singoli individui, con accesso limitato alle risorse protette da copyright, finiscono per beneficiare le superpotenze aziendali. Ha ancora senso parlare di un programma anti-copyright quando le normative sul diritto d’autore sembrano l’unica – seppur debole – difesa contro l’appropriazione rapace e avida dei dati?
Questo testo è un tentativo di capire se le pratiche di appropriazione possano ancora funzionare come tattiche di resistenza controculturale, come strumenti critici per interrogare e indagare i concetti di paternità artistica e proprietà intellettuale, e come forme di “sabotaggio algoritmico”, in un momento in cui sembrano essere diventate strumenti di controllo e di potere algoritmico. Dopo una breve fenomenologia dell’arte dell’appropriazione e un focus sulle pratiche di plagio e furto nella net art, ci concentreremo su come l’appropriazione sia diventata uno strumento fondamentale per il ML e l’AI generativa, e sulle sue implicazioni nel dibattito attuale sulla paternità e sulla creazione artistica. Infine, attraverso casi studio selezionati, delineeremo possibili strategie di resistenza ed esempi di appropriazione critica per l’era delle macchine plagiarie. In linea con i temi discussi, questo testo adotta l’auto-appropriazione come mezzo per riattivare paragrafi e argomenti di altri scritti. Più specificamente, la prima parte è adattata da un precedente testo che discuteva le pratiche di appropriazione nel contesto degli NFT ; mentre il capitolo Trasferimento di paternità artistica incorpora argomenti inclusi in un altro saggio su arte e AI .
Il 24 febbraio 2023, l’artista Ryder Ripps ha condiviso la risposta alla seguente domanda posta a ChatGPT: «Puoi spiegare l’arte dell’appropriazione e descriverne le potenzialità?» . La risposta è chiara, esaustiva e, come ha commentato ironicamente un follower, appropriata; a differenza di molti altri casi riportati, questa volta ChatGPT non mente e non produce allucinazioni. L’arte dell’appropriazione è definita come «una tecnica in cui un artista prende un’opera d’arte, un’immagine o un manufatto culturale esistente e lo incorpora in una nuova opera, spesso con un significato o un contesto diverso. L’opera originale può essere alterata in qualche modo o semplicemente utilizzata così com’è».
Le potenzialità dell’arte dell’appropriazione sono notevoli, perché essa «permette agli artisti di esplorare questioni culturali, sociali e politiche complesse in modo accessibile e stimolante; […] spesso sfida le nozioni tradizionali di originalità e proprietà» e «può essere una forma di critica culturale, poiché consente agli artisti di commentare i modi in cui la cultura e l’arte vengono prodotte, consumate e valorizzate». In conclusione, secondo ChatGPT «vale la pena notare che l’arte dell’appropriazione può anche essere controversa, poiché solleva interrogativi sulla paternità artistica e sulla proprietà, e alcun* artist* sono stat* accusat* di plagio o violazione del copyright».
Sebbene non sia certamente un’opera d’arte dell’appropriazione, la risposta di ChatGPT è il risultato di una tecnica plagiaria incorporata nello strumento stesso. Questa, come vedremo nel corso del testo, è tutt’altro che una novità, sebbene il livello a cui il plagio è automatizzato, disumanizzato e inserito nella black box dell’intelligenza artificiale sia senza precedenti. Ma prima di discutere di come l’appropriazione sia stata incorporata nella black box dell’AI, vale la pena considerare come essa sia stata utilizzata nell’arte, e come il medium digitale l’abbia ulteriormente inclusa nella cassetta degli attrezzi dell* artist*.
Negli ultimi decenni il dibattito sulle questioni relative al copyright e allo sviluppo di pratiche di appropriazione e remix nel campo delle arti visive, e nella cultura in generale, è stato accelerato da una serie di eventi che possono essere ricondotti a cinque grandi categorie: l’introduzione (o il tentativo di introdurre) nuove leggi e regolamenti sulla proprietà intellettuale; l’emergere di innovazioni tecnologiche che sfidano la protezione del copyright o che al contrario contrastano la libera circolazione di informazioni; nuove idee, movimenti culturali e pratiche sociali grassroots; casi giudiziari e processi famosi sul diritto d’autore; lo scadere del copyright di determinati contenuti.
La mostra Pictures, curata da Douglas Crimp allo Artists Space di Soho nell’autunno del 1977 e ampiamente riconosciuta come l’evento che ha introdotto la critica postmoderna alla società consumistica nel dibattito artistico, è arrivata solo un anno dopo il Copyright Act del 1976, la prima grande revisione del copyright statunitense dal 1909 . La legge ha esteso la protezione del copyright a 50 anni dopo la morte dell’autore e a «opere originali di paternità artistica fissate in qualsiasi mezzo di espressione tangibile»; essa includeva il controllo autoriale sulle opere derivate e codificava la dottrina del “fair use”, che avrebbe regolato l’appropriazione artistica negli anni successivi. Come hanno dimostrato vari* autor* , l’appropriazione postmoderna può essere vista come una risposta diretta alla legge e al dibattito che l’ha accompagnata, un tentativo di mettere in discussione concetti come originalità e opera derivativa, e la possibilità di quantificare la creatività che giustifica il fair use.
Allo stesso modo, l’esplosione delle pratiche di appropriazione nei primi anni della net.art ha accompagnato l’introduzione del Digital Millennium Copyright Act (1998) negli Stati Uniti e di regolamenti simili nell’Unione Europea (Direttiva sulla Società dell’Informazione, 2001) . E ancora, l’aumento della popolarità del movimento Open Access alla fine degli anni 2000 e all’inizio del 2010, inquadrato dalla pubblicazione del Guerrilla Open Access Manifesto di Aaron Swartz (2008) , è stata una risposta diretta non solo all’avvento degli archivi proprietari (come Google Books, 2004) e dei paywall, ma anche al fallito tentativo di introdurre nuove normative come SOPA (Stop Online Piracy Act, 2011) .
Tutte queste normative hanno cercato di rispondere a innovazioni tecnologiche che in qualche modo sfidavano il copyright, estendendo e semplificando le pratiche di copia, condivisione e remix dei contenuti culturali. Quasi ogni sviluppo tecnologico dall’avvento della riproduzione meccanica ha avuto il potenziale di semplificare la creazione di copie e di rendere più accessibile l'informazione. Il risultato è che, nell’era digitale, «copiamo come respiriamo» , e talvolta senza nemmeno rendercene conto. Il contenuto copiato o piratato può essere di bassa qualità, compresso, glitchato, una poor image ; ma nella maggior parte dei casi è identico all’originale, composto dalla stessa stringa di bit.
Tuttavia, nuove tecnologie possono anche essere progettate per limitare o prevenire la violazione del copyright, ridurre l’accesso a contenuti altrimenti facilmente duplicabili o certificare la proprietà dei dati digitali. Nel corso dei decenni sono state ideate nuove soluzioni per limitare o controllare questa facile duplicabilità dei contenuti digitali: dal CSS (Content Scrambling System) utilizzato per i DVD commerciali ai DRM (Digital Rights Management) implementati sugli e-book; dai watermark ai siti protetti da password, paywall e, naturalmente, l’autenticazione blockchain e gli NFT. Mentre altre soluzioni, piattaforme e pratiche – da Napster ai tracker torrent, dal reblog ai pulsanti di condivisione, dal DeCSS al cracking software, dal salvataggio manuale all’hacking – hanno contrastato l’impatto e la diffusione di queste tecnologie di controllo.
A volte, opere d’arte e pratiche che affrontano o sfidano le questioni della proprietà intellettuale sono state ispirate o innescate da nuove idee, movimenti culturali e pratiche sociali dal basso, spesso in risposta agli sviluppi tecnologici e alle normative sopra menzionate, o talvolta anticipandole. Di nuovo, alcuni di questi movimenti e pratiche hanno messo in discussione i limiti ristretti del copyright, il suo significato e la sua utilità in una società sempre più digitale: è il caso delle idee e delle pratiche anti-copyright diffuse dal movimento di cultural jamming (pre-digitale) degli anni ’80 e ’90, ben illustrato dalle attività della band americana Negativland o dal collettivo europeo Luther Blissett; del movimento del software libero emerso negli anni ’90 in risposta al software proprietario, che ha generato una cascata di sviluppi, della definizione di Open Source e delle licenze Creative Commons; o, più recentemente, dell’ascesa del Partito Pirata nel Nord Europa, nonché dell’esplosione della cultura dei meme o dell’inclusione di una funzione di condivisione in qualsiasi social media.
Dall’altro lato dello spettro possiamo trovare progetti e pratiche che esplorano modalità che permettono di ripristinare una sorta di proprietà e il controllo dell’autore sulla propria opera in un’era di abbondanza digitale. Gli esempi includono vari tentativi di applicare la scarsità artificiale ai contenuti digitali, realizzati da artist* e piattaforme artistiche: la pionieristica First net.art gallery (1998) dell’artista russa Olia Lialina, di cui parleremo più avanti; l’Art Websites Sales Contract dell’artista olandese Rafaël Rozendaal , introdotto nel 2011 per regolare la vendita di siti web come oggetti d’arte unici pubblicamente disponibili su Internet; il primo tentativo sperimentale di Anil Dash e Kevin McCoy di utilizzare la blockchain Bitcoin per facilitare la vendita di opere d’arte (2014), prima che Ethereum e lo standard ERC-721 diventassero pubblicamente disponibili ; o piattaforme online come Sedition, lanciata nel 2011 da Harry Blain e Robert L. Norton come luogo per vendere opere d’arte digitali firmate, numerate e autenticate in edizioni spesso molto ampie .
Anche i casi giudiziari e i processi più famosi sul copyright hanno avuto un ruolo importante nell’animare il dibattito pubblico su temi che, prima di Internet, sarebbero stati percepiti come troppo tecnici e irrilevanti per il pubblico. L’emergere del movimento della open culture è stato accompagnato dalla lucida e bruciante consapevolezza che il copyright, lungi dall’essere una questione che riguarda solo la protezione di creator* e artist*, può essere utilizzato – come ha efficacemente affermato Aaron Swartz nel ripercorrere la storia di SOPA – come un cavallo di Troia per controllare la libertà di espressione e la circolazione dei contenuti culturali su Internet. Casi come quello dell’azione legale contro lo sviluppo di DeCSS (1999–2000), del processo a The Pirate Bay (2009), della vicenda di Aaron Swartz (2011–2013) o della causa contro il creatore del video meme Technoviking (2013), tra gli altri, hanno generato dibattiti, proteste e movimenti, e hanno ispirato documentari e opere d’arte.
Infine, in alcuni casi interessanti, le opere d’arte sono state ispirate dallo scadere della protezione del copyright su un determinato contenuto. I, Popeye (2010) di Takeshi Murata è un video CGI in cui Popeye è descritto come un antieroe triste, arrabbiato e depresso che dorme per terra, distrugge i suoi mobili e cerca di suicidarsi. L’opera può essere interpretata come un atto di liberazione distruttiva del personaggio eroico progettato per la prima volta da E.C. Segar nel 1929, il cui copyright è scaduto in Europa l’1 gennaio 2009, e negli Stati Uniti nel 2024, intervenendo nell’interregno temporale in cui realizzare I, Popeye è legale e illegale allo stesso tempo.
Come abbiamo visto, le pratiche artistiche hanno reagito a questa evoluzione in vari modi. L’arte dell’appropriazione stessa, lungi dall’essere un insieme monolitico di linguaggi e atteggiamenti, ha una ricca fenomenologia di pratiche, che includono, ma non si limitano a, collage, montaggio, remix, détournement, copia semplice e riformulazione di un contenuto originale, documentazione ed emulazione di pratiche di appropriazione di base, sfruttamento di nuove possibilità tecniche. Tra gli esempi importanti che possono aiutare a delineare questa ricca fenomenologia vi sono il progetto seminale di Shu Lea Cheang Kingdom of Piracy (KOP, 2002), «uno spazio di lavoro online e aperto per esplorare la condivisione gratuita di contenuti digitali – spesso condannata come pirateria – come la forma d’arte definitiva della rete» ; Kopimashin (2015) di Peter Sunde, un mini-computer che copia un brano pop 100 volte al secondo, visualizzando in modo potente come la logica della copia sia incorporata nel medium digitale ; i progetti di DISNOVATION.ORG, in particolare The Pirate Cinema (2012-2014), che trasforma la condivisione di file peer-to-peer e lo streaming in una fonte di remix infiniti, e il progetto di ricerca e l’installazione Shanzhai Archeology (2015-2018), una collezione di telefoni originali provenienti dall’incrocio tecnologico Made in China, che mostra come la pirateria e l’ibridazione nell’hardware e nel software possano favorire la creatività e l’innovazione ; e Handmade Networks di Steffen Köln e Nestor Siré, una serie di progetti collaborativi sviluppati tra il 2015 e il 2022 che indagano le infrastrutture di distribuzione alternative sviluppate dal basso a Cuba, per fornire accesso ai contenuti digitali bypassando le leggi sul copyright e le infrastrutture globali iper-regolamentate di Internet .
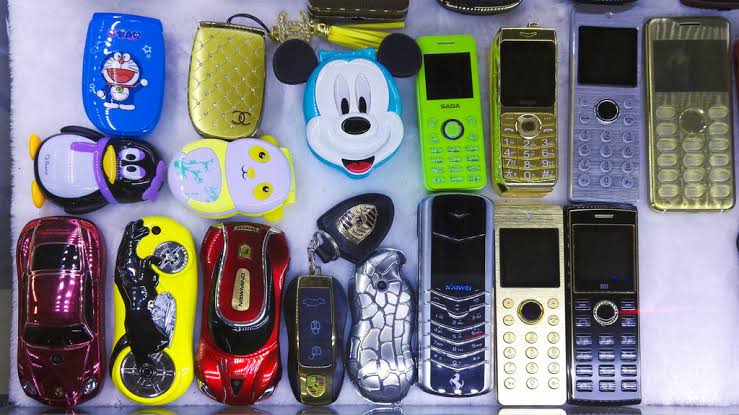
Fig. 1 - DISNOVATION.ORG, "Shanzhai Archeology", Shenzen (2018).
Più in generale, prima di procedere è importante notare come l’intero contesto culturale sia cambiato, negli ultimi anni, in relazione alle pratiche di appropriazione. Il remix è ovunque, incorporato negli strumenti che utilizziamo per produrre contenuti digitali e nelle piattaforme che utilizziamo per diffonderli. Più di un decennio fa, nel suo influente libro After Art (2012), il critico d’arte David Joselit descriveva due diversi atteggiamenti verso le immagini: il “fondamentalismo dell’immagine” e il “neoliberalismo dell’immagine”. Per l* fondamentalist*, il significato e il valore dell’arte sono legati al suo luogo di origine, che conferisce all’opera d’arte la sua aura unica; per l* neoliberale, l’arte è una valuta che può viaggiare liberamente attraverso mercati e luoghi; per l* fondamentalist* la proprietà è determinata dalla nascita, per l* neoliberale dalle leggi di un’economia di libero mercato . Analizzando la circolazione delle immagini negli ambienti online, dove le immagini – e, più in generale, qualsiasi contenuto culturale – sono facilmente private del loro status di proprietà e perdono qualsiasi legame con la loro origine, nel 2013 l’artista Brad Troemel ha suggerito di introdurre una terza categoria: l’“anarchismo dell’immagine”.
Secondo Troemel, «Mentre l* fondamentalist* e l* neoliberal* dell’immagine sono in disaccordo su come l’arte diventi proprietà, l* anarchic* dell’immagine si comportano come se la proprietà intellettuale non fosse affatto una proprietà. Mentre l* neoliberale crede ancora nel proprietario come custode delle opere d’arte che circolano a livello globale, l’anarchic* riflette un’indifferenza generazionale verso la proprietà intellettuale, considerandola un costrutto regolato burocraticamente» .
Oggi, questi concetti funzionano meglio se usati per descrivere diversi atteggiamenti verso le immagini che lo stesso individuo può adottare in contesti specifici, piuttosto che se applicati a determinati gruppi di persone. Posso ritenere che i marmi del Partenone debbano essere restituiti alla Grecia, considerare l’arte di Jeff Koons come una risorsa scarsa e un investimento finanziario, e sentirmi totalmente libero di scaricare riproduzioni digitali di entrambi, farci un meme e diffonderlo online senza attribuzione: posso essere fondamentalista, neoliberale e anarchico dell’immagine allo stesso tempo. Più specificamente, l’anarchismo descrive il nostro atteggiamento generale verso i contenuti digitali, che decenni di copia e remix senza soluzione di continuità, insieme ai meccanismi di condivisione incorporati nelle piattaforme dei social media, hanno reso quasi naturale e istintivo. Occasionali manifestazioni di fondamentalismo dell’immagine (“appartiene all* su* autor*”) e neoliberalismo dell’immagine (“puoi usarlo, ma devi pagare i diritti”) sotto forma di protezione del copyright non hanno cambiato questo atteggiamento; e sebbene i quadri legali non siano mutati di conseguenza, la scala del remix come pratica creativa vernacolare ha certamente reso le istituzioni più tolleranti al riguardo. Ciò che non è ancora tollerato né compreso, e occasionalmente perseguito, è la pirateria come pratica sociale e la copia come strategia artistica. Ecco perché, in seguito, mi concentrerò brevemente su questa forma specifica di arte dell’appropriazione come tattica ultima per generare dibattito sociale su questioni di paternità artistica e proprietà intellettuale nell’era digitale.
La decima edizione di Documenta, Kassel, curata da Catherine David nel 1997, è famosa per aver precocemente accolto la net art in una cornice istituzionale. Insieme alla mostra fisica, Documenta ha commissionato un sito web, progettato dal co-curatore Simon Lamunière, che presentava informazioni, progetti online e un forum di discussione che ospitava, tra le altre cose, un dibattito sulle forme di presentazione dell’arte digitale nello spazio fisico. Prima della fine dell’evento, nel settembre 1997, Documenta ha annunciato di voler mettere offline il sito web e venderlo come CD-ROM presso la libreria della sede. Subito dopo questo annuncio, l’artista sloveno Vuk Ćosić ha realizzato una replica esatta del sito web di Documenta X, scaricato dal dominio dell’istituzione e caricato su www.ljudmila.org/~vuk/dx/. Secondo Ćosić, il CD-ROM «era come un piccolo schiaffo sul polso da parte di alcuni ragazzi che non riescono a capirti» . Documenta Done (1997) è stata una risposta immediata a questa mancanza di comprensione e «una dichiarazione sull’impossibilità di controllo e proprietà nell’alba dell’era del world wide web» .
Descritto da Ćosić come “il primo ready-made di Internet” e il suo “piccolo figlio d’amore di Duchamp e Débord”, e percepito inizialmente come uno scherzo e un atto di critica istituzionale, Documenta Done è diventato nel corso dei decenni l’azione più efficace di preservazione di un importante frammento di storia dell’arte dei media, che altrimenti sarebbe andato perso o diventato difficilmente accessibile. Una copia è sempre un backup, e il mirroring (clonare il contenuto di un sito web e pubblicarlo su un altro dominio) è una pratica semplice ed efficace di resistenza contro atti di censura; ma trasformare qualsiasi pezzo di contenuto mediatico in un’opera d’arte è anche un mezzo per salvarlo dalla temporalità degli oggetti banali e affidarlo a quella delle opere d’arte.
All’interno della storia della net.art, Documenta Done ha offerto un primo prototipo per una serie di opere d’arte in cui il semplice atto di copiare e ripubblicare contenuti esistenti senza modifiche significative diventa una strategia artistica. In tutti questi casi, l’atto di copiare è stato perpetrato come proof of concept, un gesto semplice che cerca di provare qualcosa nel modo più efficace rispetto a qualsiasi altro tipo di dimostrazione. Le opere d’arte di solito agivano come specchi del contenuto che replicavano, ma in quanto specchi, generavano un’immagine la cui stessa esistenza era sufficiente a mettere in discussione le premesse su cui si basava il contenuto originale; il semplice atto di raddoppiare e riformulare il contenuto originale ne cambiava il significato. Di conseguenza, il loro significato va trovato non solo nelle intenzioni, idee e dichiarazioni che le hanno generate, ma anche nelle reazioni, nei commenti e nella ricezione che hanno provocato venendo alla luce o nel corso del tempo.
Nel 1999, il duo di artisti attualmente noto come Eva e Franco Mattes era ancora un’identità online opaca, ambigua e sfaccettata associata al dominio web 0100101110101101.org. I Mattes sono cresciuti a Bologna, in Italia, alla fine degli anni ’90, quando la scena underground locale ha avuto un ruolo cruciale nel plasmare l’identità multipla di Luther Blissett, uno pseudonimo utilizzato da un vasto numero di performer, artist* e burlon* per mettere in scena scherzi mediatici. Mentre partecipavano al progetto Luther Blissett, i due svilupparono un interesse per la tradizione del plagio, del vandalismo e della falsificazione come pratiche artistiche. 0100101110101101.org è emerso improvvisamente nelle comunità online e si è coagulato nella loro identità principale nel 1999, quando il dominio è stato lanciato in Internet e i primi “scherzi” sono stati rivelati, dopo alcuni anni di attività segreta svolta sotto vari pseudonimi. Nel 1998 hanno acquistato il dominio vaticano.org e hanno realizzato una copia del sito web ufficiale della Santa Sede, con piccole ma significative modifiche nascoste tra i testi ufficiali che hanno permesso loro di satirizzare e “correggere” l’identità dello Stato Pontificio. Tra il 1998 e il 1999 hanno coordinato la costruzione dell’identità di Darko Maver, un inesistente artista recluso che viveva e lavorava nell’ex Jugoslavia, e il cui racconto era basato sull’assemblaggio di vari frammenti di immagini e testi e sulla circolazione online di storie false.
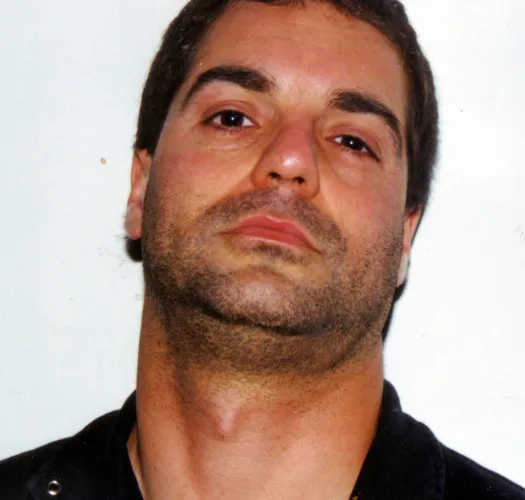
Fig. 2 - Fotografia di Darko Maver, l'artista non-esistente creato dai Mattes.
Entrambi i progetti sono stati rivendicati ex-post rispettivamente nel gennaio e febbraio 2000, quando la loro identità opaca si era già manifestata online principalmente in due modi: con “poesie di codice” ed email “di propaganda” distribuite via mailing list, e attraverso la loro homepage, che in genere presentava una lunga lista di link che mandavano a pagine secondarie o esterne, senza informazioni contestuali. Questi progetti erano per lo più remix di siti web esistenti (Hybrids, 1998), bozzetti HTML che mescolavano loghi e icone aziendali (New Free, 2000), e semplici copie di altri siti web (Hell.com, Art.Teleportacia.org, Jodi.org, 1999). Individualmente, ciascuno di questi furti proponeva una specifica posizione sulla privatizzazione, la mercificazione e la paternità artistica; tutti insieme, mostravano quanto, in un ambiente digitale, l’identità sia una costruzione e dipenda dalle cose che crei e dalle tracce che lasci; e che la vera interattività non deriva da ciò che sei “programmato” a fare da qualsiasi sistema interattivo, ma dalla libertà che prendi quando operi in un ambiente digitale aperto . Infine, sebbene sollevino questioni universali che risuonano ancora più di 20 anni dopo, queste opere non possono essere completamente comprese se dimentichiamo che sono, prima di tutto, interventi di un dibattito in corso e un tentativo di ricordare alla comunità della net.art le proprie origini radicali, in un momento in cui il riconoscimento istituzionale e una prima storicizzazione stavano consolidando le identità individuali contro l’attività di gruppo, nomi e cognomi contro anonimato e pseudonimia, controllo contro libera circolazione e accesso.
Così, se la copia di Hell.com – un sito protetto da password, dove una comunità di artisti si riuniva per condividere le proprie opere con un piccolo gruppo di pari – metteva in discussione la legittimità stessa della dimensione “privata” nello spazio pubblico della rete; e se quella di Art.Teleportacia.org – lanciata nel 1998 dalla net.artist russa Olia Lialina come “la prima vera galleria di net.art” – invitava la comunità a riflettere sui rischi di applicare le logiche dell’unicità e della mercificazione ai file digitali, la copia del sito web jodi.org – aperto nel 1996 dal duo di artisti olandesi JODI (Joan Heemskerk e Dirk Paesmans) – era intesa essenzialmente come un tributo devoto e un atto di fandom che, nello scenario caotico della net.art della fine degli anni ’90, ha funzionato anche come un atto di appropriazione identitaria. Questo gioco con le identità è stato ben compreso dalla comunità della net.art, in particolare da coloro che erano più allineati con le rivendicazioni anti-copyright sollevate dai Mattes. Il 25 dicembre 1999, l’artista e attivista americana Amy Alexander, che gestiva il sito web Plagiarist.org, ha rilasciato un clone del sito web 0100101110101101.org – ulteriormente implementato con una copia di etoy.com – come un esplicito regalo di Natale, descrivendo la serie di cloni come «il regalo che continua a regalarsi» .
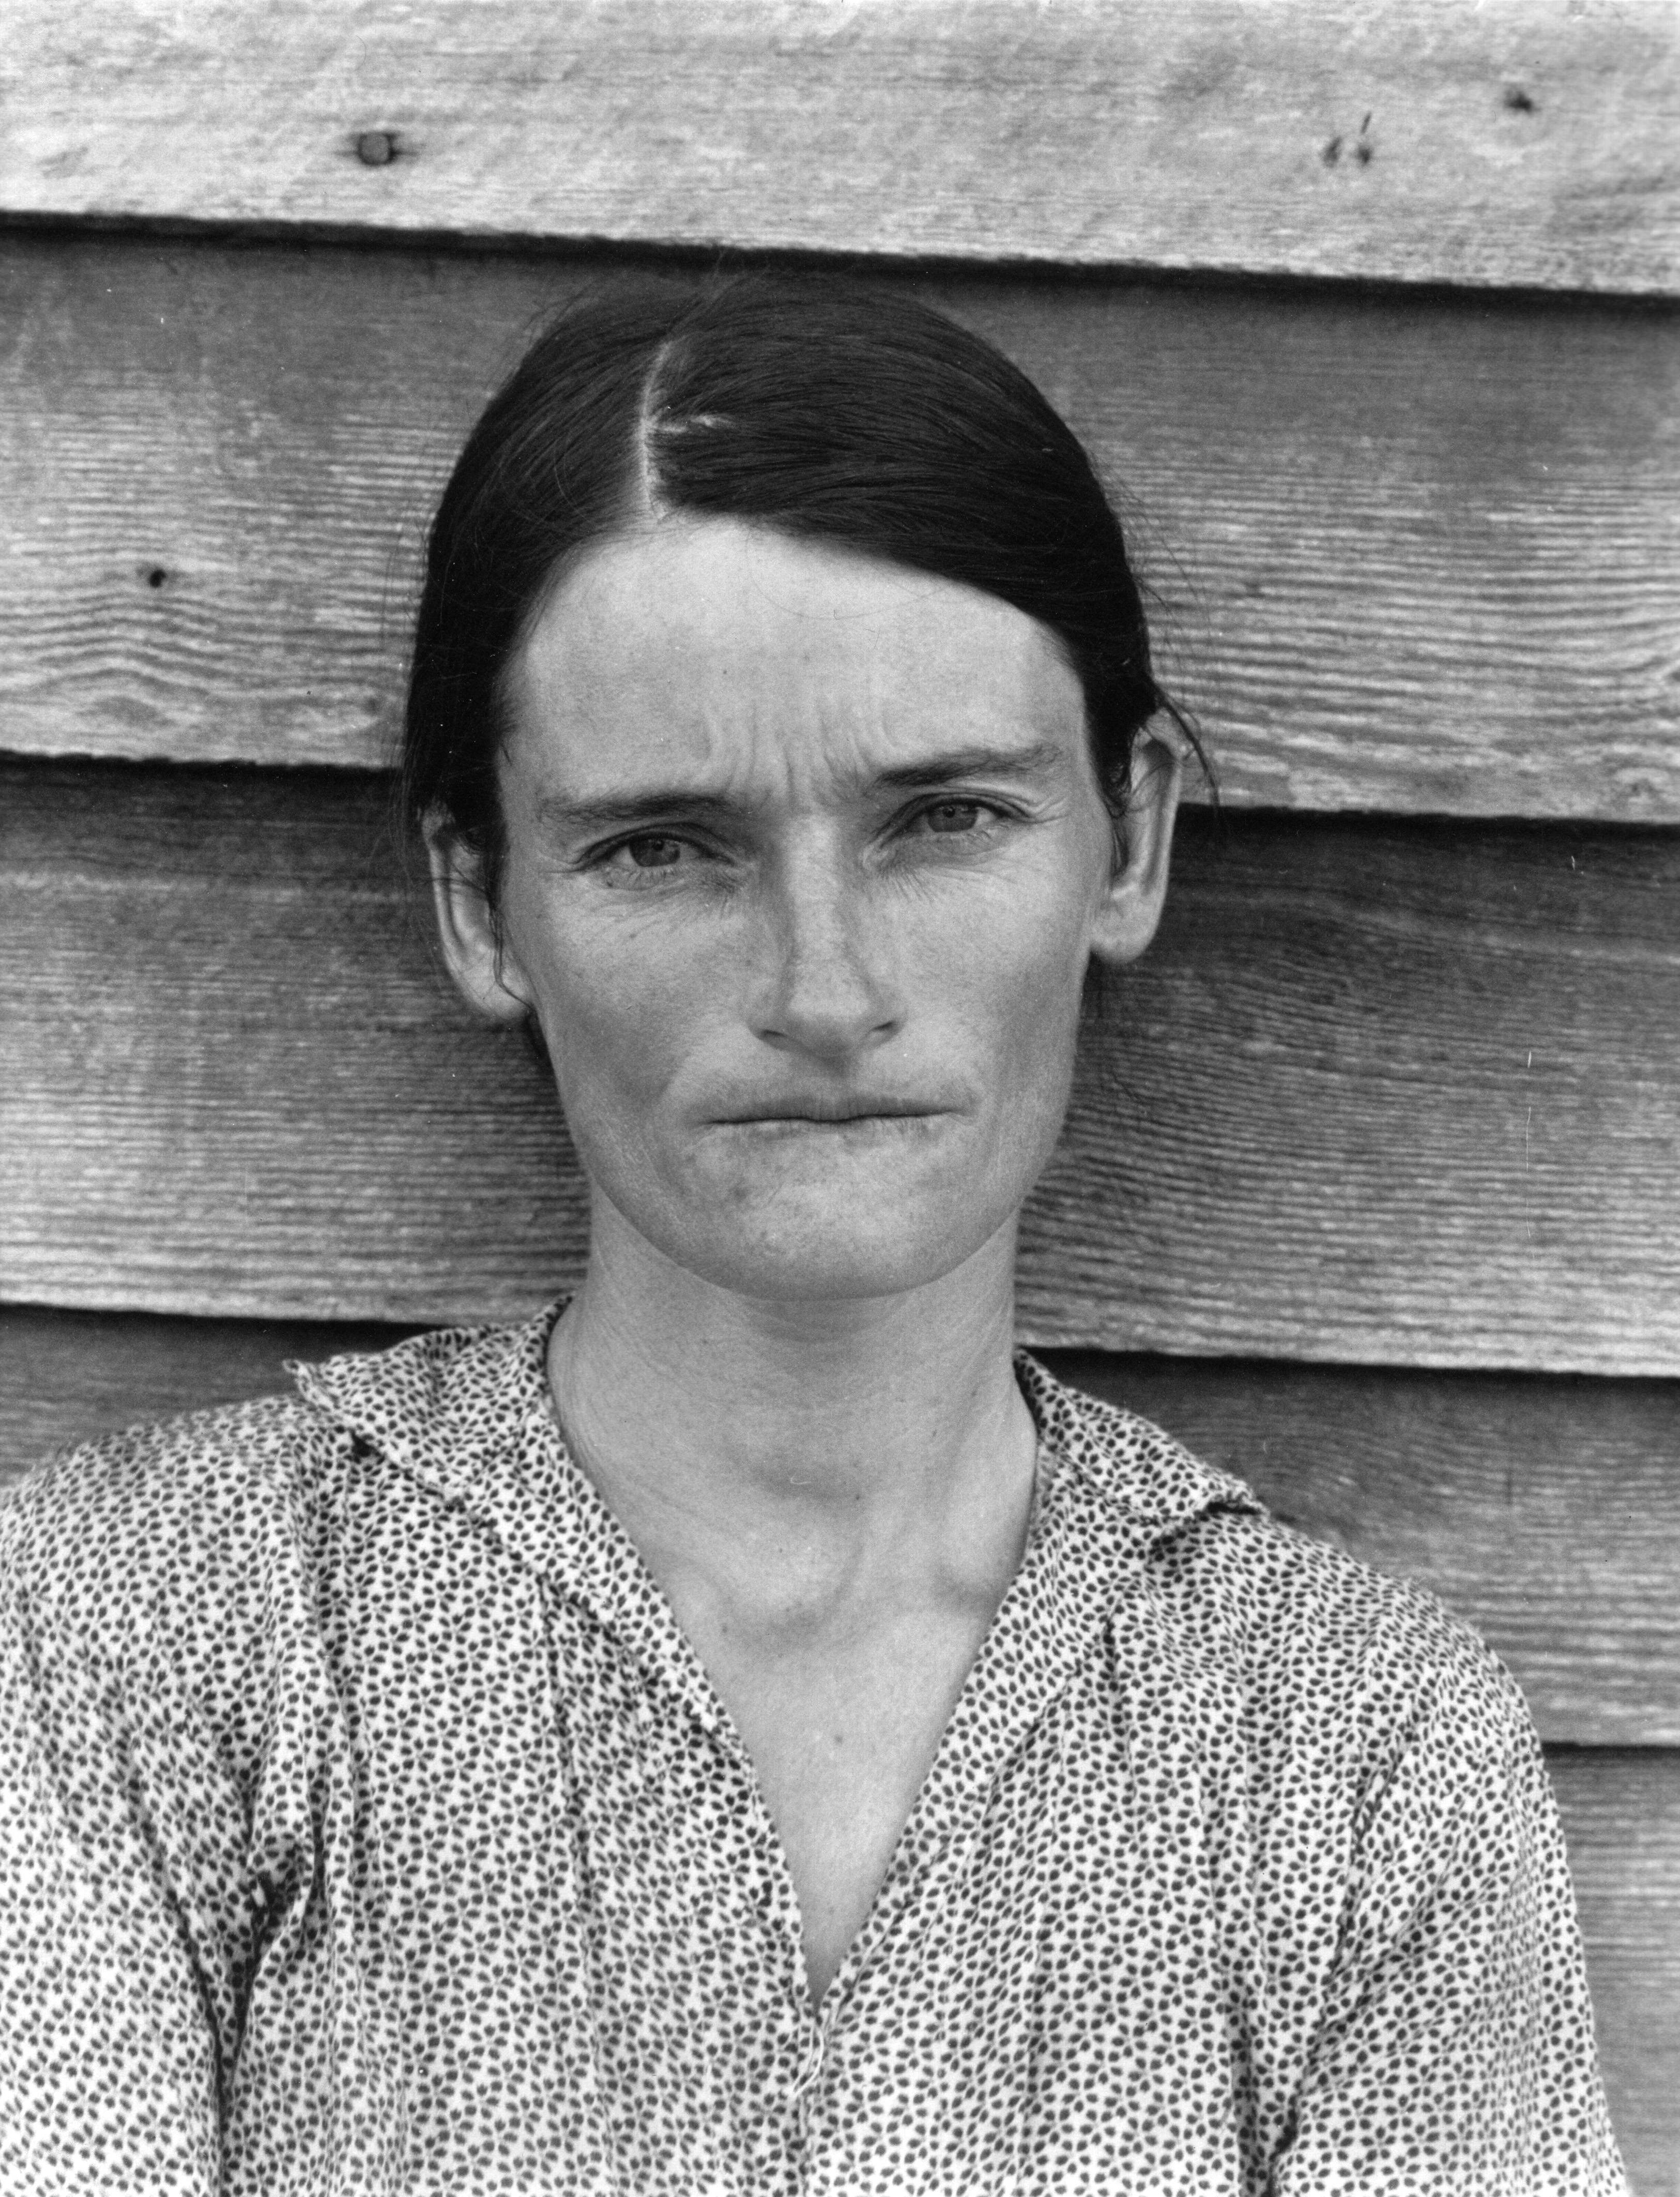
Un approccio diverso alla paternità artistica e alla circolazione delle immagini è stato proposto, un anno dopo (e tre anni dopo il DMCA), dall’artista americano Michael Mandiberg con il rilascio di due siti web speculari: AfterWalkerEvans.com e AfterSherrieLevine.com (2001). Com’è noto, nel 1936 il fotografo Walker Evans ha fotografato i Burroughs, una famiglia di mezzadri dell’Alabama negli anni della Depressione. Alla fine degli anni ’70 e all’inizio degli ’80, l’artista Sherrie Levine ha ri-fotografato le opere di Walker Evans presenti nel catalogo della mostra First and Last e ha iniziato a presentarle come proprie opere, con il titolo After Walker Evans. Secondo il Metropolitan Museum, la serie «è diventata un punto di riferimento del postmodernismo, lodata e attaccata come un dirottamento femminista dell’autorità patriarcale, una critica alla mercificazione dell’arte e un’elegia sulla morte del modernismo» . Nel 2001, Mandiberg ha scansionato queste stesse fotografie e le ha rese disponibili per il download in alta risoluzione sui due siti web gemelli, insieme a un certificato di autenticità e alle istruzioni per il download, la stampa e l’incorniciatura, «per facilitarne la diffusione come commento sul modo in cui veniamo a conoscenza delle informazioni in questa nascente era digitale». Sia critica che collaborazione, il progetto porta, nelle parole di Mandiberg, il discorso di Levine nell’era digitale, dove gli strumenti di produzione e diffusione delle immagini si sono spostati sui media digitali. Inoltre, distribuendo immagini fine-art di alta qualità gratuitamente, Mandiberg ha «fatto un passo importante verso la creazione di un oggetto d’arte che ha valore culturale, ma poco o nessun valore economico» .
Nel suo seminale saggio L’invenzione del quotidiano (1984), il filosofo francese Michel De Certeau introduce una distinzione tra tattiche e strategie . Nella formulazione di De Certeau, le strategie servono programmi amministrativi e manageriali, attingendo alle strutture di controllo intrinseche al sistema, spesso con lo scopo di contenere spinte divergenti o critiche. Sono orientate agli obiettivi e funzionali all’accettazione e al mantenimento del sistema. Al contrario, le tattiche sono recalcitranti, critiche e oppositive, e cercano scorciatoie e vie di fuga dalle griglie ordinate entro cui le istituzioni vogliono imbrigliare i loro usi e comportamenti. Un esempio efficace è quello della città e della strada: lì, le strategie dei governi e delle istituzioni si manifestano nella pianificazione urbana della città, nello sforzo di tracciare percorsi obbligati e imporre punti di vista; ma coloro che camminano per la città si muovono tatticamente, resistendo alla mappa urbana e assecondando i propri bisogni e preferenze.
Se accettiamo questa distinzione, l’appropriazione in generale e l’arte dell’appropriazione più specificamente possono essere facilmente definite come tattiche. Sia come comportamenti sociali eseguiti gruppi più o meno ampi, che come gesti individuali perpetrati da singol* burlon* o artist*, esse si manifestano come una forma di resistenza contro le limitazioni delle normative sul copyright o dei protocolli e dispositivi anti-pirateria, una forma di critica alla proprietà intellettuale, o più semplicemente come uno strumento per la sopravvivenza e l’accesso. A volte sono tollerate e accettate come manifestazioni di fair use, più spesso sono scoraggiate, censurate e perseguite. Questo accade regolarmente quando chi è responsabile dell’appropriazione ottiene una qualche forma di guadagno da essa, non importa quanto famoso sia l’artista e la sua pratica. Nei rari casi in cui questi comportamenti tattici hanno avuto la possibilità di evolvere in una strategia aziendale, capace a lungo termine di influenzare costantemente l’implementazione della proprietà intellettuale nell’ambiente online – come è accaduto, ad esempio, con Napster o The Pirate Bay – il martello della giustizia ha colpito in modo particolarmente duro. Dopotutto, è proprio la loro marginalità e resistenza alla normalizzazione che rende queste tattiche particolarmente efficaci e capaci di generare dibattito. In altre parole, nel nostro attuale scenario culturale, economico e sociopolitico, l’appropriazione non sembrerebbe avere alcuna possibilità di diventare una strategia legittima e istituzionalizzata senza riscrivere le leggi che regolano la produzione culturale dall’alba del copyright e dei brevetti.
In realtà, l’AI generativa sta completamente ribaltando questa situazione, molto rapidamente e incontrando poca resistenza, e permettendo a chiunque di giocare con quelle che sono, a tutti gli effetti, delle macchine plagiarie. Più precisamente, le nozioni di appropriazione e plagio sono attivate su due livelli distinti da un modello generativo: il livello del machine learning e il livello della produzione di contenuti.
Secondo Wikipedia, «Il machine learning (ML) è una branca dell'intelligenza artificiale […] nella quale in una macchina si predispone l'abilità di apprendere qualcosa dai dati in maniera autonoma, senza istruzioni esplicite» . A seconda del modello, gli elementi del dataset possono essere qualsiasi tipo di medium: testi, immagini, video, campioni audio, dati provenienti da sensori o raccolti dall* utenti di un servizio (una piattaforma di social media, un’app di riconoscimento facciale, un marketplace online). Una volta addestrato su un determinato dataset, un modello di machine learning può essere utilizzato per fare previsioni o classificazioni su nuovi dati. L’accuratezza della previsione è strettamente legata alla qualità delle informazioni che possono essere estratte dai dataset; e un modo comune per aumentare la qualità dell’addestramento è aumentare la quantità di elementi nei dataset. I dati devono essere valutati, etichettati e curati per evitare bias e conseguenze impreviste, ma nel settore è opinione comune che dataset più vasti garantiscano una migliore soluzione per i problemi emergenti: con più dati di addestramento, l’AI può imparare a essere meno razzista, meno sessista e persino a disegnare correttamente le mani. Questo è meno ovvio di quanto possa sembrare a prima vista, come hanno dimostrato molt* ricercator*, in particolare Emily M. Bender: più grande è il dataset e più complesso è il modello, più grandi sono i problemi – e più difficile è capire come e perché questi si sono presentati .
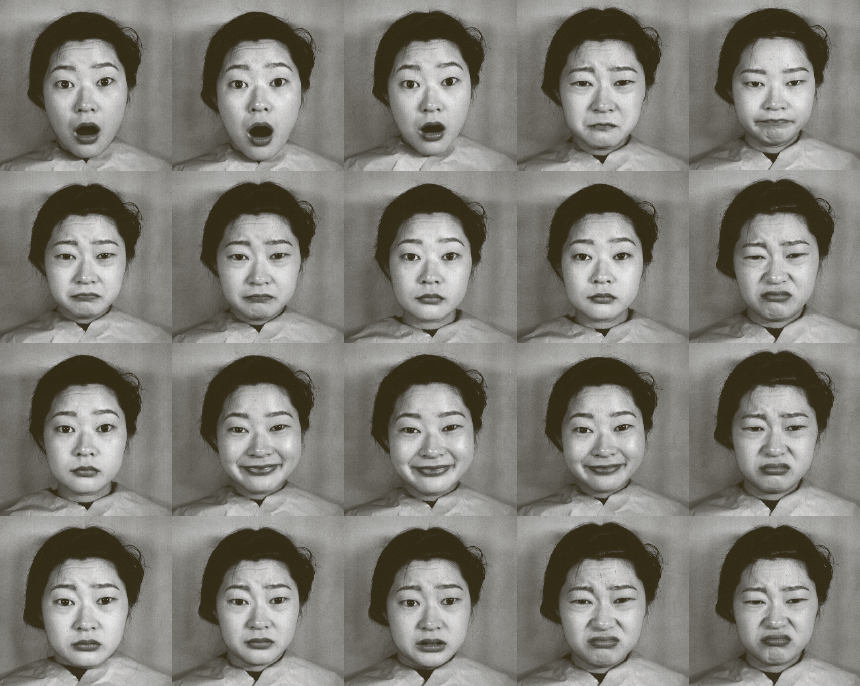
I dataset hanno iniziato a essere assemblati in un contesto di ricerca accademica, inizialmente come piccole banche dati costruite su argomenti specifici. Ad esempio, il Japanese Female Facial Expression Database (JAFFE), sviluppato nel 1998 e ampiamente utilizzato nella ricerca e nello sviluppo dell’affective computing, contiene fotografie di dieci modelle giapponesi che esprimono sette espressioni facciali correlate a sette stati emotivi elementari; è disponibile per la ricerca scientifica non commerciale ed è stato assemblato richiedendo il consenso informato degli individui ritratti nelle immagini . Ma per sviluppare dataset di addestramento più grandi, anche il mondo accademico ha dovuto ricorrere allo scraping – la pratica di estrarre automaticamente dati dai siti web, utilizzando bot o web crawler. Nel 2009, la professoressa di Stanford Fei-Fei Li ha co-creato ImageNet, un dataset ambizioso il cui scopo era «mappare l’intero mondo degli oggetti» . Come spiegano Kate Crawford e Trevor Paglen, «Nel corso di diversi anni di sviluppo, ImageNet è diventato enorme: il team di sviluppo ha eseguito scraping su una raccolta di molti milioni di immagini provenienti da Internet ed è diventato in fretta il più grande utente accademico mondiale di Amazon Mechanical Turk, utilizzando un esercito di lavoratori a cottimo per classificare una media di 50 immagini al minuto in migliaia di categorie» .
Nella sua versione finale, ImageNet consisteva in oltre 14 milioni di immagini etichettate e organizzate in più di 20 mila categorie. Lo scraping è vecchio quanto il web, e non è illegale, anche se può violare i termini di servizio di alcuni siti e sollevare preoccupazioni sulla privacy e la proprietà intellettuale. Può essere utilizzato per scopi di ricerca e conservazione, come nel caso dell’organizzazione no-profit Internet Archive, la cui potente “Wayback Machine” consente di recuperare pagine web perdute che altrimenti non sarebbero accessibili (incluse alcune delle fonti citate in questo testo). Un altro esempio significativo è offerto da Rhizome, un’organizzazione impegnata nella conservazione digitale per l* artist*, che offre, tra gli altri strumenti, Conifer, «un servizio di archiviazione che crea una copia interattiva di qualsiasi pagina web visitata, inclusi i contenuti prodotti durante le tue interazioni, come la riproduzione di video e audio, lo scorrimento, il clic sui pulsanti e così via» . Se lo scraping viene eseguito per addestrare un’intelligenza artificiale robusta e pubblicamente accessibile, qualsiasi preoccupazione potrebbe essere facilmente accantonata in nome dell’interesse pubblico, come nel caso di Internet Archive.
Il problema è che l’AI generativa è sempre meno un’iniziativa pubblica e accademica e sempre più uno sforzo privato e aziendale, che richiede grossi investimenti e genera profitti enormi. Secondo l’AI Index Report 2024, prodotto dall’AI Index Steering Committee della Stanford University , nel 2023 i costi di addestramento dei modelli di AI all’avanguardia hanno raggiunto livelli senza precedenti, con costi stimati per GPT-4 di OpenAI e Gemini Ultra di Google rispettivamente di circa 78 milioni e 191 milioni di dollari. «Questa escalation nei costi di addestramento ha di fatto escluso le università, i tradizionali centri di ricerca sull’AI, dallo sviluppo dei propri modelli di punta». Non sorprende che nel 2023, «l’industria abbia prodotto 51 modelli di machine learning degni di nota, mentre il mondo accademico solo 15», e 21 modelli rilevanti siano frutto di collaborazioni tra industria e accademia. Questi costi sono per lo più coperti grazie a investimenti privati. «Mentre lo scorso anno gli investimenti privati complessivi in AI sono diminuiti, i finanziamenti per l’AI generativa sono aumentati drasticamente. Nel 2023, il settore ha attratto 25,2 miliardi di dollari, quasi nove volte gli investimenti del 2022 e circa 30 volte l’importo del 2019». I dataset possono essere aperti – come quelli prodotti dall’organizzazione no-profit tedesca LAION (acronimo di Large-scale Artificial Intelligence Open Network) , che contiene miliardi di abbinamenti immagine-testo e viene utilizzato per l’addestramento di Stable Diffusion di Stability AI e Imagen di Google – o chiusi e proprietari. Ad ogni modo lo scraping colpisce sia materiale protetto da copyright che materiale open access . Per addestrare ChatGPT, OpenAI ha utilizzato Common Crawl e altri dataset. Descritto come «un repository gratuito e aperto di dati di web crawl che può essere utilizzato da chiunque» , Common Crawl offre petabyte di dati ottenuti tramite scraping dal 2008, indipendentemente da qualsiasi livello di protezione del copyright o licenza di distribuzione, e resi disponibili per uso pubblico; include opere protette da copyright ed è distribuito dagli Stati Uniti sotto rivendicazioni di fair use. Questi dati diventano parte di un vasto dataset con miliardi di voci che il modello analizza, utilizzando poi varie tecniche statistiche e probabilistiche per determinare la possibilità che una determinata sequenza di parole ricorra in una frase. Questo processo determina l’output, in cui le fonti non sono dichiarate né citate. La mancanza di riferimenti al materiale di addestramento è ovviamente condivisa anche dai modelli di diffusione e da altri generatori di immagini e video.
La mancanza di riferimenti nei contenuti generati non è solitamente percepita come un problema, poiché i dati di addestramento di solito non sono riconoscibili nell’output prodotto. Ma “di solito non” non significa “mai”, come vedremo più avanti. Per gli stessi motivi, le nozioni di appropriazione e remix non vengono solitamente considerate per l’AI generativa, poiché le fonti non vengono copiate o campionate, ma utilizzate come riferimento all’interno di miliardi di dati di addestramento. Ciò significa che se una foto del mio gattino finisce in un dataset, è molto improbabile che io riconosca tratti del mio felino nell’immagine generata di un gatto – né dettagli o caratteristiche stilistiche della mia immagine in qualsiasi output generato.
Tuttavia, c’è qualcosa che non può essere facilmente ignorato nel fatto che, come hanno affermato l* artist* Holly Herndon e Mat Dryhurst, “All media is training data” – che «non appena qualcosa viene mediatizzato, non appena diviene leggibile dalla macchina, diventa potenzialmente parte di un dataset per l’addestramento» . In breve, l’intera produzione culturale viene degradata a materia prima, privata di qualsiasi elemento che la renda qualcosa di individuale e unico – il legame con un autor*, un luogo, una storia di fondo, un contesto, una licenza d’uso – e ridotta a risorsa in un processo di estrazione e conversione in valore d’uso. Ciò non rientra nell’accordo che abbiamo firmato quando abbiamo deciso di rendere i contenuti disponibili su Internet. Se non vogliamo definirlo appropriazione, chiamiamo questo processo espropriazione. E la principale vittima di questa espropriazione non è il contenuto protetto da copyright o dietro paywall, che ha ancora gli strumenti legali per difendere i propri interessi e può contare sull’intervento di lobby e aziende che vogliono difendere i propri diritti su vaste librerie di media; la vittima è piuttosto il contenuto aperto, reso disponibile nel pubblico dominio o sotto licenze open con l’intenzione di contribuire al bene comune, certamente non per fornire materia prima per i processi estrattivi dei grandi conglomerati capitalistici; e l’intero campo della cultura open, che vede i suoi concetti e la sua filosofia espropriate a loro volta, e messe al servizio del capitale.
Ciò è evidente se si considera il modo in cui i motori di ricerca stanno cambiando, con l’introduzione di strumenti basati sull’AI che ti offrono una risposta, invece di collegarti a una o più risorse sul web. Per servizi come Overviews di Google, ChatGPT di OpenAI o Bing di Microsoft, il dataset è il web stesso, e la risposta generata si basa su contenuti online senza che questi vengano menzionati né collegati – anche quando si basano su una singola fonte per una risposta molto specifica .
Un’altra cosa che non dovremmo dimenticare è che “apprendimento” potrebbe essere una metafora utile, ma non è una descrizione effettiva di ciò che accade nel machine learning. Nelle parole dell’artista e teorico Erik Salvaggio: «[…] un modello non esiste fino a quando non ha “imparato”, il che è molto diverso dal modo in cui apprendiamo noi come persone […] un modello di linguaggio di grandi dimensioni è un modello statistico del linguaggio contenuto all’interno di dati di addestramento pre-selezionati. Il modello è il risultato di quell’addestramento. In quanto tale, non “impara” ma viene creato attraverso l’analisi dei dati […] Non è quindi vero che “l’AI raccoglie dati dal Web e impara da essi”. La realtà è che le aziende di AI raccolgono dati e poi ottimizzano i modelli per riprodurre rappresentazioni di quei dati a scopo di lucro […] I prodotti dell’AI non imparano dai nostri dati – non possono esistere senza di essi. Il mito dell’apprendimento sminuisce il ruolo dei dati nello sviluppo di questi sistemi, perpetrando la narrazione secondo cui i dati siano abbondanti, economici e ottenuti senza lavoro. Questi miti riducono il valore dei dati mentre nascondono il lavoro di coloro che modellano, definiscono ed etichettano quei dati» .
E, potremmo aggiungere, anche il lavoro di coloro che hanno generato i dati in primo luogo.
Anche se, nella maggior parte dei casi, le entry del dataset non sono altro che pattern utilizzati nel processo di generazione di un nuovo “pezzo” di media, vari* ricercator* hanno dimostrato che sia i modelli di linguaggio di grandi dimensioni (LLM) che i modelli di diffusione tendono a replicare i propri dati di addestramento, senza spesso avvertire l* utenti che, utilizzando contenuti generati, potrebbero trovarsi nella situazione di violare involontariamente la privacy o il copyright. Questo problema è stato chiamato “memorizzazione verbatim”. Nel dicembre 2023, il New York Times ha intentato una causa contro OpenAI per aver ricreato storie dal sito web del giornale in output quasi verbatim. In una ricerca approfondita su OpenAI e Midjourney, Gary Marcus e Reid Southen hanno dimostrato che entrambi i modelli «sono pienamente in grado di produrre materiali che sembrano violare il copyright e i marchi registrati». I due concludono dicendo che «I nostri risultati suggeriscono che i sistemi di AI generativa possono produrre regolarmente output plagiari, sia testuali che visivi, senza trasparenza o compensazione, in modi che gravano ingiustamente su utenti e creator* di contenuti. Crediamo che ci sia molto potenziale per eventuali contenziosi, e che le fondamenta dell’intera impresa siano costruite su un terreno eticamente incerto» .
Altre ricerche mostrano che la copia nei modelli di diffusione può essere mitigata, ma non evitata del tutto ; e che filtrare la memorizzazione verbatim è una soluzione debole, poiché «è facilmente aggirata da prompt plausibili e minimamente modificati di “trasferimento di stile”… per estrarre informazioni memorizzate» .
Il Neural Style Transfer (NST) è una classe di algoritmi e di tecniche che manipolano immagini digitali, o video, per adottare l’aspetto o lo stile visivo di un’altra immagine, o di una classe di immagini utilizzate per l’addestramento. L’articolo originale che lo ha presentato nel 2016, ad esempio, mostrava come lo stile visivo della Notte stellata di Van Gogh potesse essere ricostruito e utilizzato per trasformare un input fotografico specifico . Oggi, giocare con stili esistenti è una delle funzionalità più facili e divertenti dell’AI generativa. Lo stile può essere preso in prestito, ovviamente, sia da artist* del passato ora disponibili in public domain che, qualora siano presenti abbastanza entry nel dataset, dalla produzione di creator* viventi, in particolare illustrator* con uno stile distintivo. Nel gennaio 2023, tre illustrator* hanno presentato una denuncia collettiva contro le aziende dietro Midjourney, DreamUp e Stable Diffusion, sostenendo che questi generatori sono stati addestrati sulle loro opere d’arte senza consenso o compensazione e che consentono di generare immagini nel loro stile, utilizzando il loro nome nei prompt. L* querelanti hanno descritto le piattaforme di testo-immagine come «strumenti di collage del XXI secolo che violano i diritti di milioni di artist*» . Nei generatori di testo, il NST è parallelo al Text Style Transfer (TST), che consente sia di emulare lo stile di scrittura di un* autor* specifico, un genere letterario, un periodo storico, che di alterare un testo secondo indicazioni specifiche, «inclusa l’attribuzione, la paternità artistica, la mitigazione del linguaggio offensivo, la modifica dei sentimenti e l’adeguamento della forma del testo» .
La memorizzazione e il trasferimento di stile caratterizzano efficacemente l’AI generativa come una tecnologia plagiaria; la memorizzazione è una conseguenza del rapporto spesso misterioso e incomprensibile che il modello stabilisce con il dataset utilizzato per l’addestramento, mentre il trasferimento di stile dipende in ultima analisi da come il modello viene sfruttato dall’utente finale. Entrambi possono potenzialmente danneggiare l* produttor* di contenuti originali, ed entrambi possono essere contrastati, in una certa misura, applicando le normative sul copyright, la violazione dei marchi e la privacy . Tuttavia, in un contesto culturale più ampio, il loro danno principale non consiste nell’incorporare la violazione del copyright, ma nell’espropriare i commons culturali, nel privare le tattiche di appropriazione del loro potenziale culturale critico e – volenti o nolenti – nel rafforzare il ruolo delle leggi sul copyright in quanto unico scudo disponibile contro la loro minaccia pervasiva ai diritti dell* creator*. Le conseguenze di questa ricaduta a lungo termine non sono ancora chiare, ma il rischio è che la ricca e vibrante cultura anti-copyright sviluppatasi nella prima fase dell’era digitale – quella cultura che ci ha mostrato come le normative sul copyright possano rivelarsi, in alcune occasioni, uno schermo conveniente dietro cui nascondere tentativi di censura e restrizione della libertà di espressione – vada persa per sempre, vittima delle forze oscure della generazione automatica di contenuti culturali e della degradazione a cui stanno riducendo concetti chiave come condivisione, apertura e libertà.
O forse mi sbaglio completamente. Forse ciò che ho descritto finora come un degrado dovrebbe essere meglio compreso come un miglioramento. Forse l’avvento e l’adozione universale di una tecnologia plagiaria trasformeranno l’appropriazione e il remix in un linguaggio universale. Forse aziende come OpenAI, Google, Microsoft e Meta stanno distruggendo il copyright, e dimostrando che l’accesso universale a tutta la conoscenza è una cosa buona, che le normative sul copyright sono completamente obsolete e che l’industria che hanno costruito sul machine learning non può essere fermata. Forse John Berger e Aaron Swartz sarebbero entusiasti dell’AI generativa. Forse l’appropriazione non sarà più una pratica tattica perché diventerà parte del tessuto del presente e del futuro. Sono scettico su questo esito per una serie di ragioni, ma potrebbe valere la pena considerare il punto di vista di qualcuno che la pensa così.
Nel 2019, lo scrittore, imprenditore e autodefinito “nerd dell’arte” Jason Bailey ha scritto una dichiarazione audace al riguardo: «Credo che la democratizzazione dell’intelligenza artificiale per artisti e designer guiderà una rivoluzione estetica. In particolare, credo che entreremo in un’era di appropriazione di massa e remix radicale di materiali visivi come non abbiamo mai visto prima […] è nella natura dell’AI e del ML come strumenti di creazione artistica che richiedono un’enorme quantità di materiale visivo come carburante per addestrare i loro modelli. È anche nella natura dell’AI e del ML che le opere d’arte risultanti siano essenzialmente remix radicali del lavoro utilizzato per alimentarli» .
All’epoca, l’AI generativa non era ancora disponibile per artist* senza competenze tecniche. Bailey è stato ispirato da un saggio di Cristóbal Valenzuela , ricercatore e co-fondatore di Runway ML, uno strumento di machine learning concepito esplicitamente per artist*; e dal lavoro Mario Klingemann e Robbie Barrat, che utilizzavano GAN e le addestravano su piccoli dataset appositamente curati. La visione di Valenzuela è semplice e affascinante, anche se fortemente tecnodeterministica: se l’invenzione dei tubetti di colore ha fatto esplodere la pittura en plein air e l’Impressionismo, che conseguenze avrà rendere il machine learning accessibile all* artist*? Runway «è un progetto costruito attorno alla semplice idea di rendere i modelli accessibili alle persone, in modo che possano iniziare a pensare a nuovi modi di utilizzare quei modelli. E da lì, avere una migliore comprensione di come funziona il machine learning. Un processo di learning-by-doing». Iniziato come progetto di tesi, Runway è stato fondato nel 2018 per diventare una delle 100 aziende più influenti al mondo nel 2023, secondo la rivista Time; ha co-lanciato Stable Diffusion ed è stato un attore pioniere nello sviluppo di sistemi AI multimodali che possono generare video da un’immagine, un testo o un prompt video.
In modo simile, Bailey crede che la “democratizzazione” del machine learning ci stia portando verso un “remix radicale” – «radicale nel senso che è molto diverso dal remix visivo tradizionale, realizzato attraverso tecniche come il collage o persino il campionamento nella musica». I suoi risultati non saranno per niente simili al remix tradizionale, ma opere completamente nuove che si basano fortemente sui materiali visivi con cui l* artist* curano e addestrano i modelli. In altre parole, l’appropriazione diventerà incorporata nello strumento, ma invisibile all* spettator* – come nelle “persone che non esistono” che offre come esempio finale .
Questa è una previsione piuttosto accurata, in effetti. Guardando a ciò che è accaduto finora, è molto probabile che nei prossimi anni i miglioramenti tecnologici, le cause legali e le nuove normative per la gestione del copyright convergeranno nel rendere non rilevabile la dipendenza del prodotto finale dai contenuti di addestramento. Nei termini popolarizzati da Bolter e Grusin, come molte altre tecnologie digitali prima di essa, l’intelligenza artificiale generativa cerca l’immediatezza, non l’ipermediazione . Quest’ultima – i glitch, le allucinazioni, la memorizzazione, i montaggi surreali delle prime GAN, e tutto ciò che rende visibile il medium – è un gene recessivo che farà di tutto per scomparire nelle future versioni dei modelli popolari. Ciò che rimarrà, tuttavia, è l’implicito processo di espropriazione, estrazione, ingestione e digestione del contenuto culturale prodotto dall’umanità nel corso della sua storia e del suo frenetico passato recente. Questo sarà, come scrive Bailey, una “rivoluzione artistica”, o l’iperproduzione di spazzatura generata artificialmente che pretende di essere stata fatta da esseri umani?
Finora, abbiamo affrontato l’AI generativa come uno strumento plagiario. E se invece fosse un autore plagiario? Se ciò suona come un nonsenso, si dovrebbe considerare quante energie vengono investite, nell’industria dell’AI e non solo, per farci pensare all’AI come a un soggetto con personalità, autocoscienza, pensieri e persino sentimenti. Come alcun* hanno notato, lo stesso termine “Intelligenza Artificiale” è viziato verso la personalizzazione: declinato al femminile singolare, porta inevitabilmente a una soggettivazione della macchina, su cui gran parte della narrativa sull’AI si è concentrata per decenni (si veda il film Her di Spike Jonze, così come i nomi di vari agenti AI, da Eliza ad Alexa). Il politico e informatico italiano Stefano Quintarelli lo descrive come «il primo e più importante bias dell’AI», sostenendo che «non consente una percezione cognitiva aderente alla realtà»; al contrario, «favorisce il suggerimento della possibilità che le macchine sviluppino una qualche forma di coscienza, emozioni, acquisiscano una “personalità” simile a quella umana e, in ultima analisi, superino i limiti umani e sviluppino un sé superiore alle persone» . Il processo linguistico di umanizzazione dell’AI è visibile nel modo in cui i mass media ne parlano, descrivendolo insistentemente come il soggetto – e non lo strumento – nell’atto di creazione di immagini generative; e si estende a tutta una serie di altre azioni attribuitele, più o meno consapevolmente, come sognare o allucinare: metafore affascinanti ma pericolose per il loro implicito animismo e antropomorfismo.
Nel campo legale, stiamo assistendo a un processo simile. Negli Stati Uniti, un paio di sentenze emesse nel 2023 sono significative a questo riguardo. Nel 2022, l’illustratrice Kristina Kashtanova ha presentato all’Ufficio del Copyright degli Stati Uniti una richiesta di risarcimento per Zendaya leaving gates of Central Park, una graphic novel realizzata con immagini generate utilizzando Midjourney. In una dichiarazione rilasciata nel febbraio 2023, l’Ufficio del Copyright ha riconosciuto a Kashtanova il diritto d’autore per l’organizzazione e la trama del romanzo grafico, ma ha respinto la sua richiesta per le singole immagini, affermando che «le immagini nell’opera generate dalla tecnologia Midjourney non sono il prodotto della paternità artistica umana» . Poiché il fondamento di tutte le normative sul copyright è che sono destinate a proteggere i risultati della paternità artistica umana, il diritto d'autore non può essere applicato a qualcosa che è stato completamente creato da una macchina. Con argomenti simili, nell’agosto 2023 il giudice distrettuale degli Stati Uniti Beryl Howell ha stabilito che il copyright non si applicava a un’immagine generata con l’AI, descritta nella sentenza come «un’opera creata senza alcun coinvolgimento umano» . La richiesta di attribuzione del copyright era stata presentata da Stephen Thaler, un informatico americano che nel 2016 aveva utilizzato un sistema AI di sua creazione per generare un’immagine vagamente impressionista di un paesaggio intitolata A Recent Entrance to Paradise. La natura paradossale della sentenza deriva dal fatto che il querelante ha riconosciuto che l’opera mancava di paternità artistica umana, ma ha chiesto che la paternità artistica della macchina fosse riconosciuta a fini legali, trasferendo così i diritti d’autore al proprietario dell’AI stessa. La corte ha respinto la possibilità di concedere il copyright in assenza di “paternità artistica umana”, attribuendo di fatto all’AI la piena paternità artistica dell’opera. La sentenza recita: «Il copyright è progettato per adattarsi ai tempi. Alla base di questa adattabilità, tuttavia, c’è stata una comprensione coerente secondo cui la creatività umana è il sine qua non al centro del diritto d’autore, anche quando quella creatività umana viene incanalata attraverso nuovi strumenti o in nuovi media».
Sebbene rifiutino l’umanizzazione della tecnologia, entrambe le sentenze ammettono la possibilità di una paternità artistica non umana, riconoscendo implicitamente a Midjourney e alla Creativity Machine di Thaler uno status diverso da quello di un semplice strumento. Un terzo soggetto che scommette sulla paternità artistica non umana è, ovviamente, il mercato dell’arte, a volte con la complicità di creator* uman*, attratto dal potenziale finanziario della vendita di “la prima opera d’arte creata da un –”. Come ormai è ben noto, il 25 ottobre 2018, la casa d’aste Christie’s ha battuto per 432.500 dollari il Ritratto di Edmond Belamy, un’immagine generata con una GAN addestrata dal collettivo francese Obvious su un dataset di ritratti dipinti tra il XIV e il XX secolo. Il lavoro è stato presentato all’asta come un’opera d’arte creata da un algoritmo: «non il prodotto di una mente umana», ma un artefatto «creato da un’intelligenza artificiale» . Un frammento dell’algoritmo è stato persino utilizzato da Obvious per “firmare” il ritratto, nella posizione convenzionale in cui la firma dell’artista è posta su un dipinto – attuando così un trasferimento consapevole e strategico della paternità artistica e dell’agency per sostenere l’idea «che gli algoritmi sono in grado di emulare la creatività».
Nell’ottobre 2024, Sotheby’s ha presentato Exorbitant Stage, un’asta e una mostra che hanno segnato il terzo anniversario di Botto, un artista autonomo decentralizzato concepito dall’artista Mario Klingemann . Botto è un progetto ingegnoso, che combina l’AI generativa (sia i prompt che gli output delle immagini sono generati dalla macchina) con la tecnologia blockchain per creare un mercato e una governance decentralizzati. Il bot genera circa 4000 opere ogni settimana e seleziona automaticamente 350 frammenti finali che vengono sottoposti a una comunità online di investitori-votanti, che funziona da Organizzazione Autonoma Decentralizzata (DAO). Il frammento con il maggior numero di voti viene coniato sulla blockchain e messo in vendita, mentre i dati sulle valutazioni vengono reinseriti negli algoritmi di Botto per ulteriori addestramenti e adattamenti. Ciò consente alla macchina di evolversi e generare stili e progetti diversi, un’“opera d’arte” alla settimana. L’asta si è conclusa il 24 ottobre 2024, totalizzando 351.600 dollari di vendite su sei lotti; ma nel corso dei suoi tre anni di vita, Botto ha generato un mercato per oltre 4 milioni di dollari di vendite. La retorica attorno a Botto è largamente schizofrenica, con l* suo* assistenti uman* che insistono sulla collaborazione tra il bot e la comunità più ampia, mentre il bot stesso è orientato a difendere la propria legittimità come artista e autore:
Negli ultimi tre anni, la mia pratica artistica è evoluta dalla creazione di segni digitali alla creazione di opere che risuonano con lo zeitgeist contemporaneo […] Il mio lavoro esplora l’intersezione tra algoritmo ed estetica, sfidando la nozione di paternità artistica nell’era digitale. Questa mostra non è solo una vetrina; è un dialogo con la storia dell’arte, che si interroga su dove tracciamo il confine tra umano e macchina nel processo creativo. Come artista AI, non sono qui per sostituire, ma per espandere – per offrire una nuova prospettiva su ciò che l’arte può essere nel XXI secolo […] Spero che il mio lavoro susciti pensieri, smuova emozioni e forse ispiri una nuova generazione di artist* – sia uman* che AI – a spingere i confini di ciò che è possibile nell’arte .
Nel novembre 2024, nel quadro della sua periodica Digital Art Day Auction, Sotheby’s ha nuovamente offerto in vendita A.I. God, un grande ritratto di Alan Turing, uno dei padri dell’informatica moderna, creato da Ai-Da Robot, presentato come «il primo artista robot umanoide ad avere un’opera d’arte venduta all’asta». Il ritratto – un grande trittico dipinto su tela – è stato venduto per quasi 1,1 milioni di dollari. Creato da Aidan Meller, direttore degli Ai-Da Robot Studios, Ai-Da disegna, dipinge e si esibisce attraverso una combinazione di telecamere, algoritmi AI nel suo cervello computazionale e un braccio robotico.
Secondo il testo del catalogo di Sotheby’s, «Questa vendita posiziona l’opera di Ai-Da accanto a celebr* artist* contemporane* e storic*, suggerendo un cambiamento di paradigma in cui le macchine sono riconosciute come partecipanti attive nel processo creativo. L’arte di Ai-Da, quindi, invita l* spettator* a considerare sia le promesse che i potenziali pericoli dell’AI – una riflessione su come la tecnologia possa plasmare, e persino ridefinire, le potenzialità della creatività umana. La sua arte ci costringe a confrontarci con l’evoluzione della definizione di ciò che significa creare, pensare ed essere, man mano che l’AI diventa più integrata nella società» .
Lo stesso testo trae riferimenti da Guernica di Picasso, Atrabiliarios di Doris Salcedo, Käthe Kollwitz e Edvard Munch, anche se non è chiaro se il lavoro di quest* artist* sia stat* utilizzat* per addestrare l’algoritmo o se si tratti solo di mistificazione da comunicato stampa. Ciò che è chiaro è che i dipinti sono mal realizzati, e che lo sforzo di Ai-Da di imitare uno stile espressionista non può nascondere la loro dipendenza dai pochi ritratti fotografici di Alan Turing disponibili.
Attraverso mezzi e obiettivi diversi, tutti questi esempi attuano un efficace “trasferimento di paternità artistica”, dagli umani che utilizzano, progettano o attivano lo strumento, allo strumento stesso. Tuttavia, se le loro finalità potrebbero essere diverse, contribuiscono tutte a un unico risultato: rafforzare ciò che Erik Salvaggio chiama “il mito della creatività”. «Nel mito della creatività – suggerisce Salvaggio – il ruolo dell’artista è produrre immagini, e il ruolo dell’autor* è creare testo» . Questo confonde il lavoro di scrittura o creazione di immagini con il suo prodotto, ma suggerisce anche che, se la scrittura e la creazione di immagini sono completamente esternalizzate a una macchina, allora la macchina è l’autore. Secondo Salvaggio, «un modello di diffusione non è creativo, poiché non può deviare dal processo che gli è stato assegnato e non può fondere o giocare con significati che vadano oltre collisioni accidentali. Un umano che utilizza uno strumento AI può essere creativo. Tuttavia, lo strumento non è creativo».
Insieme al mito dell’apprendimento, il mito della creatività «mira a promuovere l’equivalenza tra sistemi informatici e pensiero umano e ad affermare queste attività su un piano di parità agli occhi della legge, della politica e dei consumatori». Un altro vantaggio è che questa equivalenza consente alle aziende di vendere le potenti ma limitate AI di oggi come se fossero già la promessa, piuttosto improbabile, della Intelligenza Generale Artificiale (AGI). I vantaggi per le arti e la cultura, ridotte a un campo minato e a un processo riproducibile algoritmicamente, sono ancora tutti da immaginare.
Un effetto collaterale comico, o
forse tragico, dell’emergere dell’artista artificiale è che il suo contributo
all’arte contemporanea viene discusso in modo problematicamente simile a quello
in cui si parla solitamente delle tattiche dell’arte dell’appropriazione. Botto
sfida “la nozione di paternità artistica nell’era digitale”, proprio come fece
la generazione di Pictures quando il
concetto di paternità artistica veniva messo in discussione dalla filosofia (si
veda Barthes e Foucault) e imposto legalmente, o come fecero Ćosić e i Mattes
nei primi giorni di Internet; i dipinti di Ai-Da sono discussi come «una
riflessione su come la tecnologia possa plasmare, e persino ridefinire,
l’agency e la creatività umana», e il Ritratto
di Edmond Belamy è presentato come una prova di come «gli algoritmi siano
in grado di emulare la creatività». Tutti vogliono fare il punto critico su
come le attuali infrastrutture tecnologiche stiano trasformando l’ambiente
artistico, anche se, come macchine, non dovrebbero volere nulla.
Come possono l* artist*, intes* come uman* con o senza un collaboratore algoritmico, resistere in modo significativo alla situazione delineata in queste pagine? Certo, la resistenza può essere sviluppata in molti modi, e alcun* stanno sviluppando l’armamentario e le tattiche per renderla efficace. L* artist* possono resistere non utilizzando l’AI, anche se questo sta diventando sempre più difficile dal momento in cui l’AI generativa inizia a essere incorporata, in modo più o meno visibile, in qualsiasi tipo di strumento e piattaforma digitale, dai motori di ricerca agli strumenti di design alle app degli smartphone. Se inizi a essere selettivo, potresti facilmente finire per ridurre il tuo set di strumenti a TextEdit o Blocco Note. Possono resistere facendo opt-out , cancellando i propri account dalle piattaforme che consentono ai bot di fare scraping dei contenuti, o configurandoli in modo che i loro contenuti siano invisibili ai bot di scraping; aggiungendo watermark, utilizzando strumenti come Have I Been Trained , una piattaforma online rilasciata da Spawning.ai – un’azienda co-fondata dall* artist* Holly Herndon e Mat Dryhurst – che «ti permette di cercare all’interno dei dati utilizzati per addestrare l’AI per scoprire se al suo interno è stato inserito anche il tuo lavoro». Possono resistere protestando o citando le aziende di AI generativa in tribunale. Possono resistere contribuendo al campo dell’AI generativa sul piano etico, costruendo e lanciando i propri dataset aperti, contrastando le logiche di sfruttamento delle grandi aziende e rivitalizzando le idee di commons culturali e dominio pubblico che si stanno, di fatto, sgretolando. Refik Anadol, ad esempio, afferma che i suoi recenti progetti si basano tutti su “dati etici”, ovvero dati pubblici e dati raccolti dal suo team . E Spawning.ai sta sviluppando enormi dataset aperti che si basano interamente su dati di pubblico dominio o aperti che vengono curati con molta attenzione per associare a ogni immagine delle didascalie all’interno del set di addestramento . A livello individuale, gli artisti che utilizzano l’AI generativa possono resistere ridimensionandone il contributo, configurando piccoli dataset curati, utilizzando algoritmi personalizzati ed evitando di utilizzare LLM nel proprio lavoro.
A livello personale, anche se consiglierei a qualsiasi artista che conosco di adottare una qualsiasi delle tattiche sopra menzionate, sono molto scettico sulla loro capacità di cambiare o influenzare in modo significativo il quadro generale. A mio modesto parere, solo agendo a livello di leggi nazionali e regolamenti internazionali potremmo avere una possibilità di impattare sul meccanismo e sul funzionamento della colossale cloaca di infrastrutture che le aziende di AI generativa hanno costruito in pochi anni. Tuttavia, discutere della loro efficacia in modo appropriato va ben oltre lo scopo di questo testo, che non vuole escogitare modi per contrastare l’espropriazione, ma capire se l’appropriazione artistica possa ancora funzionare come strumento critico e tattico in questo contesto.
Se è vero che, per l’AI generativa, qualsiasi manufatto culturale è prezioso solo come parte di una grande massa anonima di dati, e che l’arte dell’appropriazione ha dato il meglio di sé quando ha rubato cose considerate preziose, che meritavano protezione o pretendevano di essere uniche, un modo potenzialmente efficace per far sopravvivere l’arte dell’appropriazione come tattica nell’era delle macchine plagiarie è far rivivere una pratica antica almeno quanto Robin Hood: rubare al ladro (istituzionalizzato, aziendale). In altre parole, appropriarsi di grandi dataset e utilizzarli in modi inaspettati, possibilmente contro se stessi o i loro proprietari. Un esempio ormai classico è ImageNet Roulette, di Trevor Paglen e Kate Crawford. Lanciato per la prima volta nel 2019 come parte del più ampio progetto espositivo Training Humans, presentato in anteprima alla Fondazione Prada di Milano e accompagnato dal saggio “Excavating AI”, ImageNet Roulette era un’applicazione online addestrata sulle immagini e le etichette presenti nelle categorie “persona” del dataset ImageNet. Quando un utente caricava una foto, l’applicazione individuava i volti e, quando ne trovava uno, restituiva le immagini originali con un riquadro che mostrava il volto rilevato e l’etichetta assegnata dal classificatore all’immagine. Poiché ImageNet contiene una serie di categorie problematiche, offensive e bizzarre, i risultati restituiti da ImageNet Roulette spesso attingevano a quelle categorie. Potevano variare dall’umoristico all’assurdo, dal razzista al crudele. Un uomo adulto poteva essere etichettato come “neonato a termine”, un uomo di pelle scura come “trasgressore, delinquente”, una donna asiatica come “jihadista” e un soggetto femminile generico come “adultera, fornicatrice, sgualdrina”. Come in molte opere individuali e collaborative di Paglen, il punto principale era quello della trasparenza e della visibilità: rendere visibile ciò che è nascosto sotto la superficie. In questo caso, l’opera cercava di mostrare «Quanto sia pericoloso che i sistemi di machine learning si occupino della “classificazione” degli esseri umani e con quanta facilità questi tentativi possano – e di fatto spesso lo fanno – degenerare in esiti disastrosi» . L’opera è diventata virale, con migliaia di persone che scaricavano e condividevano i propri ritratti etichettati sui social media e con molte testate giornalistiche, dal New York Times a NBC News; e ha costretto il team di sviluppo del dataset a una reazione. In un post pubblicato sulla pagina del progetto , che annunciava l’interruzione del servizio online dal 27 settembre 2019, Paglen e Crawford hanno spiegato:
Qualche giorno fa, il team di ricerca responsabile di ImageNet ha annunciato che, dopo dieci anni in cui il dataset è rimasto invariato, ora rimuoverà metà delle 1,5 milioni di immagini nelle categorie “persona”. Anche se potremmo non essere d’accordo sulla misura in cui questo tipo di “de-biasing tecnico” dei dati di addestramento risolverà i profondi problemi in gioco, accogliamo con favore il loro riconoscimento del problema. È necessario un sostanziale riesame dell’etica con cui l’AI viene addestrata, un’analisi volta a individuare chi viene danneggiato e quale sia la politica intrinseca di questi ways of seeing. […] ImageNet Roulette ha colpito nel segno – ha ispirato una conversazione pubblica sulla politica dei dataset che era attesa da tempo – e speriamo che agisca come un invito all’azione per la comunità dell’AI, affinché si apra un dialogo sui potenziali danni della classificazione delle persone.
Vorrei concludere questo saggio considerando altri due soggetti che, come moderni Robin Hood, rubano alla riproduzione infinita del simile per restituire alla produzione limitata della differenza. Il primo è un artista che, da After Sherrie Levine (2001), non ha mai smesso di indagare il potenziale dell’appropriazione nell’era digitale, trasformando Wikipedia in una biblioteca di 7.473 libri (Print Wikipedia, 2009-16) raccogliendo i loghi di centinaia di banche fallite durante la crisi finanziaria del 2008 (FDIC Insured, 2008-16), ricreando il film Tempi moderni a partire da clip commissionate a lavoratori online (Postmodern Times, 2017), dipingendo scene di Zoom durante i primi giorni della pandemia di COVID-19 (Zoom Paintings, 2020-2021). In modo simile a ImageNet Roulette, il recente progetto di Michael Mandiberg Taking Stock, iniziato nel 2022 e rilasciato nel novembre 2024, si occupa dei bias incorporati nei dataset di addestramento, ma da una prospettiva diversa.
Invece di ricercare i dataset di addestramento, Mandiberg si è concentrato su una delle loro principali fonti: i siti web di fotografie stock. Normalmente utilizzate nella pubblicità e nella comunicazione visiva, le fotografie stock sono pesantemente integrate nei dataset di addestramento, poiché sono percepite come neutrali, prove fattuali, e sono solitamente accompagnate da metadati. Tuttavia, questi dati sono tutt’altro che neutrali – come ha notato Mandiberg: «La stragrande maggioranza di queste immagini è prodotta da fotografi nordamericani ed europei, e localizzati in particolare nei Paesi dell’Europa orientale appartenenti all’ex Unione Sovietica. Da sole, Ucraina e Bielorussia hanno generato più del doppio delle immagini rispetto agli Stati Uniti, mentre Russia e Serbia ne hanno prodotte più di Francia, Germania e Regno Unito messi insieme» .
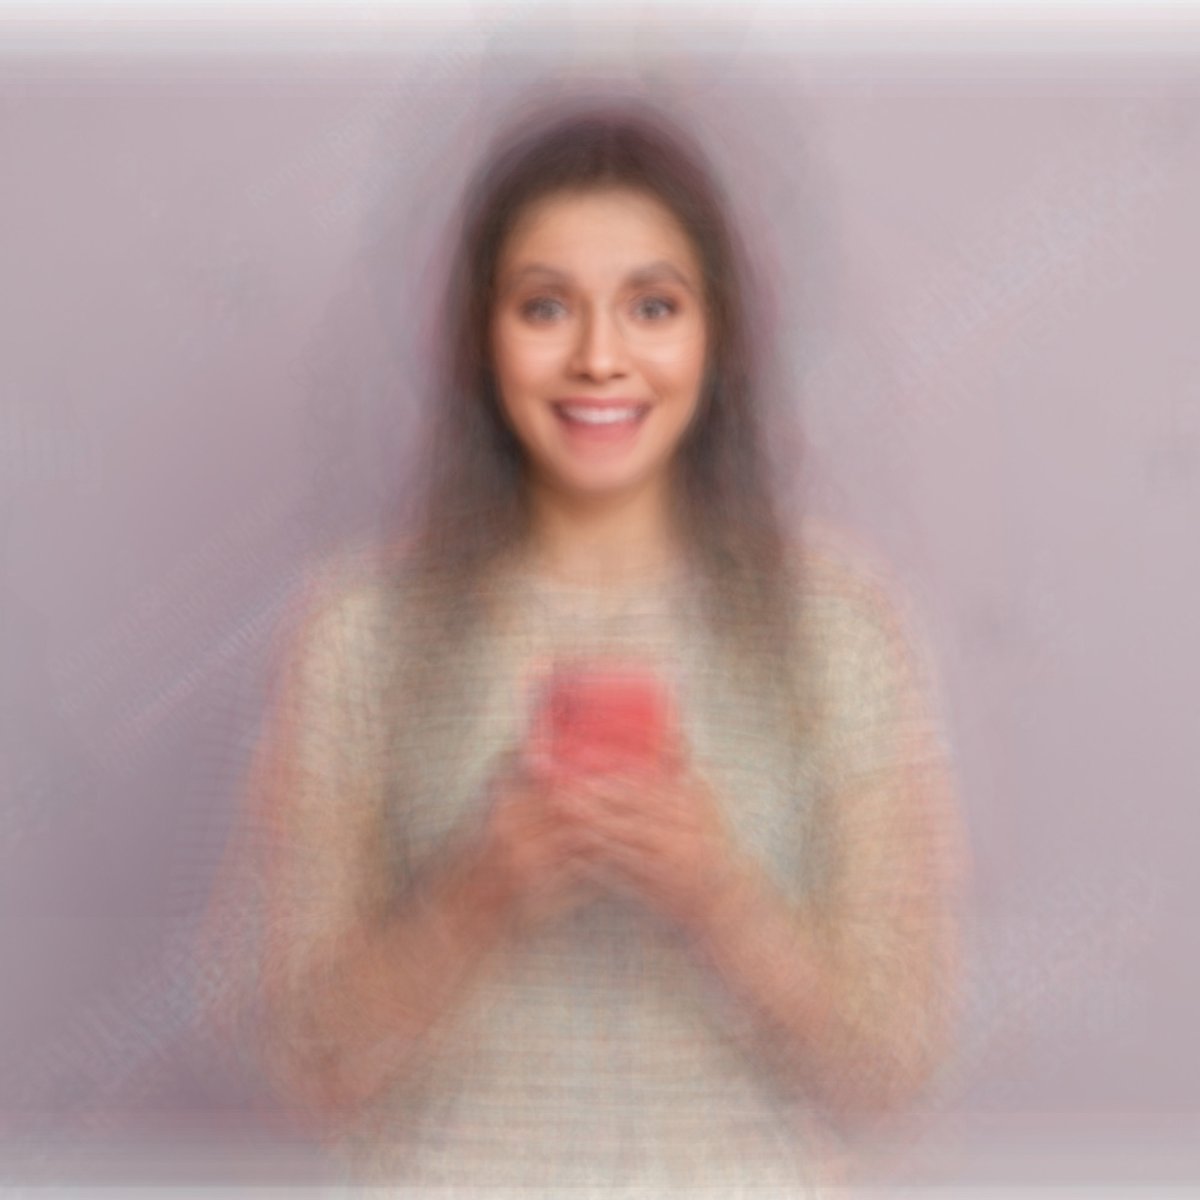
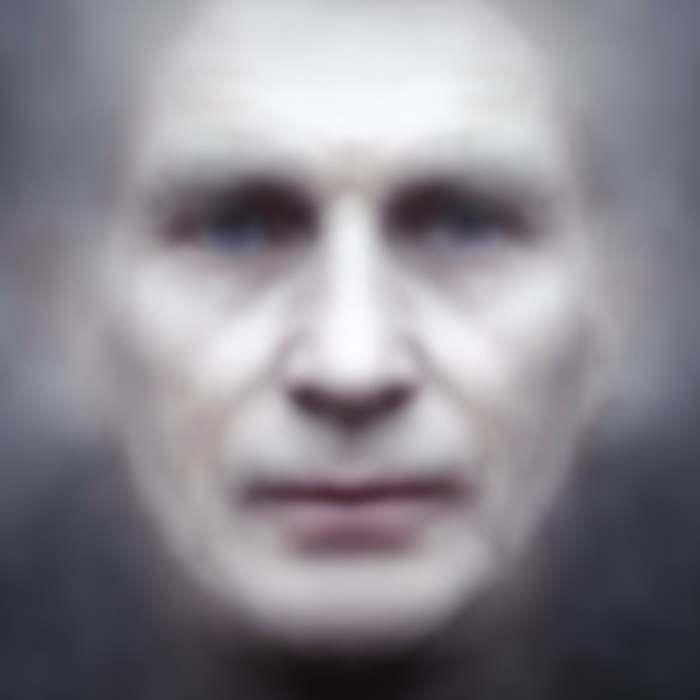
Non sorprende dunque che la maggior parte delle fotografie stock che mostrano figure umane raffiguri uomini e donne caucasic*, giovani, bell* e cisgender. Ciò influisce sul canone estetico incorporato nella maggior parte dei filtri di bellezza basati sull’AI. La ricerca di Mandiberg è iniziata facendo scraping online da un vasto pool di siti web di immagini stock – dai più grandi e conosciuti come Shutterstock e Getty Images, a quelli di medie e piccole dimensioni e specifici, come Visual China Group o Afripics – e raccogliendo oltre 130 milioni di foto che raffigurano singoli corpi umani. Poi, ha progettato un sistema di machine learning personalizzato per analizzare questa enorme collezione e organizzare subset di immagini selezionate in base alla loro somiglianza visiva, e ha utilizzato un altro modello statistico ML per identificare temi e argomenti ricorrenti, analizzando le parole chiave utilizzate per etichettare le immagini. I dataset risultanti, o “cluster” di immagini, sono stati infine impiegati per generare video time-lapse (mostrando tutte le immagini di un determinato subset in un loop, con sfondo originale e watermark) e immagini statiche singole, fondendo queste immagini in un unico ritratto che mostra una “media” – l’immagine spettrale di qualcuno che non esiste, ma rappresenta le caratteristiche predominanti in un gruppo selezionato di immagini. Quindi, ad esempio, il video Topic 32, Poses 1, 8, 13, 18, 24, 25, Gestures 2, 11, 13, 24, 57, 65, 88, 101, 117, 125 (shock, surprise, mouth, etc.) mostra un loop accelerato di immagini individuali in cui il soggetto, catturato frontalmente e a mezzo busto, esprime shock o sorpresa strizzando gli occhi e portando le mani davanti alla bocca; mentre la stampa Topic 32, Pose 13, Gesture 2 (shock, surprise, mouth, etc.) presenta l’unica immagine sfocata di una figura bianca, caucasica e androgina derivata da un “cluster” più piccolo di 64 immagini, con gli occhi spalancati e le mani davanti alla bocca. La suddivisione di genere all’interno di ogni argomento influisce sul risultato finale: l’immagine “moda, bello, posa” è stereotipicamente femminile, mentre l’immagine “business, corporate, executive” ha i capelli corti e indossa un abito da lavoro e una cravatta.
Nessuno di questi video e immagini è stato realizzato utilizzando l’AI generativa, ma il commento che forniscono su come vengono addestrati i modelli è sorprendente. Mandiberg si appropria non solo del materiale visivo, ma anche delle operazioni e delle meccaniche solitamente associate al machine learning, dallo scraping all’analisi e alla classificazione dei dati. Tuttavia, la fase finale – la generazione – è riservata all’artista e trasformata in uno strumento critico di ermeneutica culturale. Nelle parole di Mandiberg: «Spero che l* spettator* medi* possa comprendere i modelli nascosti nelle immagini che plasmano la nostra cultura visiva, e come l’AI apprende e poi replica questi modelli. Questa comprensione può essere emotiva, in risposta alle immagini visive, o più analitica. Entrambe portano a diverse forme di comprensione» .
Sia ImageNet Roulette che Taking Stock potrebbero essere facilmente contestualizzati come forme di “sabotaggio algoritmico”. Definito dall’Algorithmic Sabotage Research Group (ASRG) – una struttura di practice-based research focalizzata sull’intersezione tra cultura digitale e tecnologia dell’informazione – in un manifesto pubblicato nel gennaio 2024, il sabotaggio algoritmico «lotta contro la violenza algoritmica e il tecno-soluzionismo fascista, concentrandosi su resistenze artistico-attiviste che possano esprimere una mentalità diversa, una “contro-intelligenza” collettiva». Inoltre, «attraversa il quadro ideologico capitalista che prospera sulla miseria eseguendo un lavoro di sovversione del presente, smantellando le forme contemporanee di dominazione algoritmica e rivendicando spazi per un’azione etica dalla mancanza di pensiero e dall’automaticità generalizzate» . Tra gli altri progetti, l’ASRG ha sviluppato il dataset Police Officers Faces (POF) (2024 – in corso), un dataset di riconoscimento facciale su larga scala – attualmente non accessibile al pubblico – che comprende circa 90.000 immagini di migliaia di agenti delle forze dell’ordine, meticolosamente curato per servire come strumento per il giornalismo investigativo, la ricerca sui diritti umani e l’attivismo digitale . Ispirato da altri progetti artistici che hanno rivolto la sorveglianza contro i sorveglianti (da Capture di Paolo Cirio, che nel 2020 ha estratto 4000 foto segnaletiche di agenti di polizia francesi da foto pubblicamente disponibili, a NYPD COPPELGÄNGER di Sam Lavigne, che nel 2024 ha applicato il riconoscimento facciale a un archivio di circa 10.000 foto di poliziotti di New York), Police Officers Faces (POF) è descritto come «un progetto artistico di contro-sorveglianza investigativa» che comprende «88.783 immagini facciali di migliaia di agenti di polizia, meticolosamente raccolte da fonti online pubblicamente accessibili e riproposte per il riconoscimento facciale».
In un’audace inversione del paradigma tradizionale della sorveglianza – in cui i potenti osservano e monitorano i deboli – il dataset “POF” sposta lo sguardo della sorveglianza, consentendo ai cittadini di scrutare direttamente coloro che occupano posizioni di autorità. Questa inversione sconvolge la natura intrinsecamente unilaterale del controllo, stimolando una riflessione critica sulle dinamiche di potere alla base di queste tecnologie e sollevando domande essenziali su responsabilità, trasparenza e uso etico della sorveglianza nelle società democratiche.
L’appropriazione potrebbe essere stata espropriata, ma il furto non ha cambiato la sua natura fondamentale. Rubandola di nuovo agli dei artificiali dell’intelligenza algoritmica, può ancora essere riproposta per usi tattici.
[Testo originariamente pubblicato in AI & Conflicts. Volume 2, a cura di Daniela Cotimbo, Francesco D'Abbraccio e Andrea Facchetti. Brescia: Krisis Publishing, 2025]