Un po’ di tempo fa, lo scrittore di fantascienza Ted Chiang descrisse il testo prodotto da ChatGPT come una «JPEG sfocata di tutti i testi in rete», oppure come una «brutta immagine» semantica . Ma il prodotto finale opaco generato dalle reti neurali contiene un’altra dimensione storica: la statistica. Le immagini create dagli strumenti di machine learning sono rendering statistici, piuttosto che immagini di oggetti realmente esistenti. Spostano l’attenzione dall’indessicalità fotografica alla distinzione stocastica. Non si riferiscono più alla fatticità, tantomeno alla verità, ma alla probabilità. Lo shock dell’improvvisa illuminazione fotografica è sostituito dalla noia delle curve di Bell, delle funzioni di perdita e delle code lunghe, generate da una burocrazia implacabile.
Questi render sono rappresentazioni medie di un enorme bottino di guerra, sequestrato online con reti a strascico, nello stile degli eugenici e confusi ritratti compositi di Francis Galton, dell’8K, di Unreal Engine. In quanto visualizzazioni di dati, non richiedono alcun riferimento indessicale al loro oggetto. Non dipendono dal reale impatto dei fotoni su di un sensore o dall’emulsione. Convergono intorno alla media, al valore medio; costituiscono una mediocrità allucinata. Rappresentano la norma segnalando la media. Sostituiscono le somiglianze con le probabilità. Le possiamo considerare «immagini scadenti» a livello di risoluzione, ma per quanto riguarda stile e sostanza sono immagini mean .
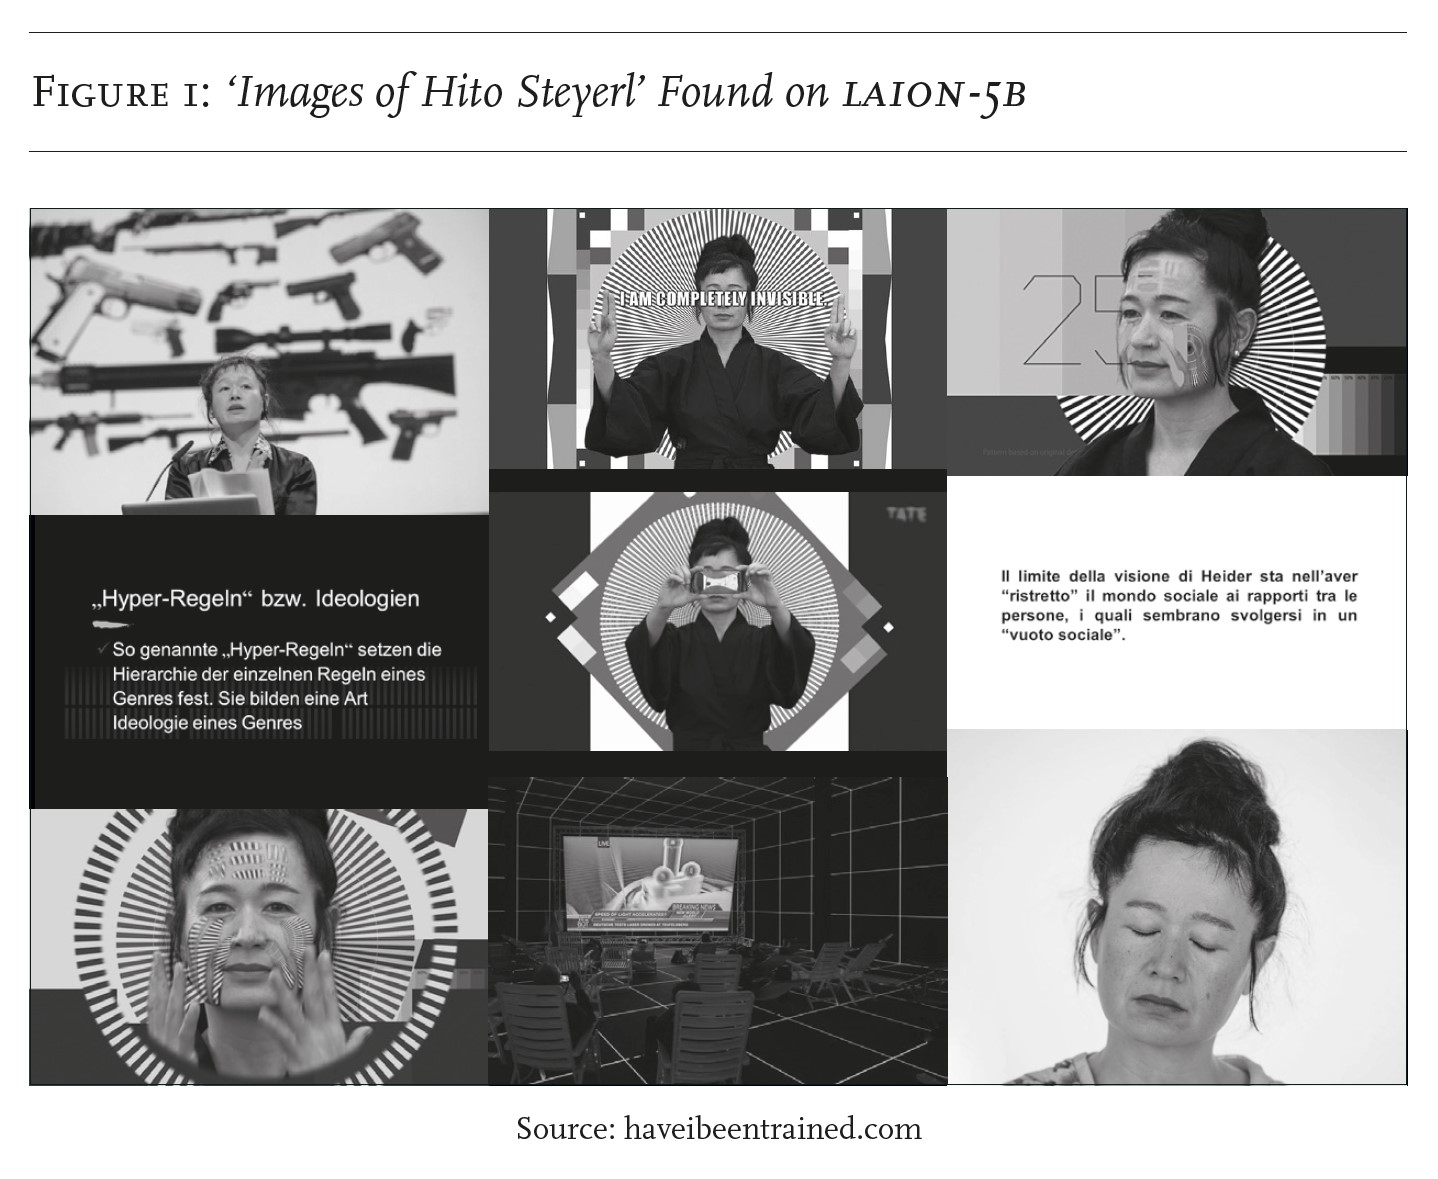
Fig. 1 – Immagini di Hito Steyerl trovate su LAION-5B. Fonte:haveibeentrained.com
Ecco un esempio di come un set di fotografie più tradizionali viene convertito in una rendering statistico: il motore di ricerca “Have I been trained?” – uno strumento molto utile sviluppato dall* artist* Mat Dryhurst e Holly Herndon – permette a chi lo usa di fare ricerche all’interno dell’enorme dataset LAION-5B, impiegato per addestrare Stable Diffusion, uno dei generatori di immagini più utilizzati nell’ambito del deep learning. All’interno di questo dataset troviamo queste mie foto. Cosa ne fa Stable Diffusion? Chiedi al modello di eseguire il rendering di “un'immagine di hito steyerl” e questo è il risultato.
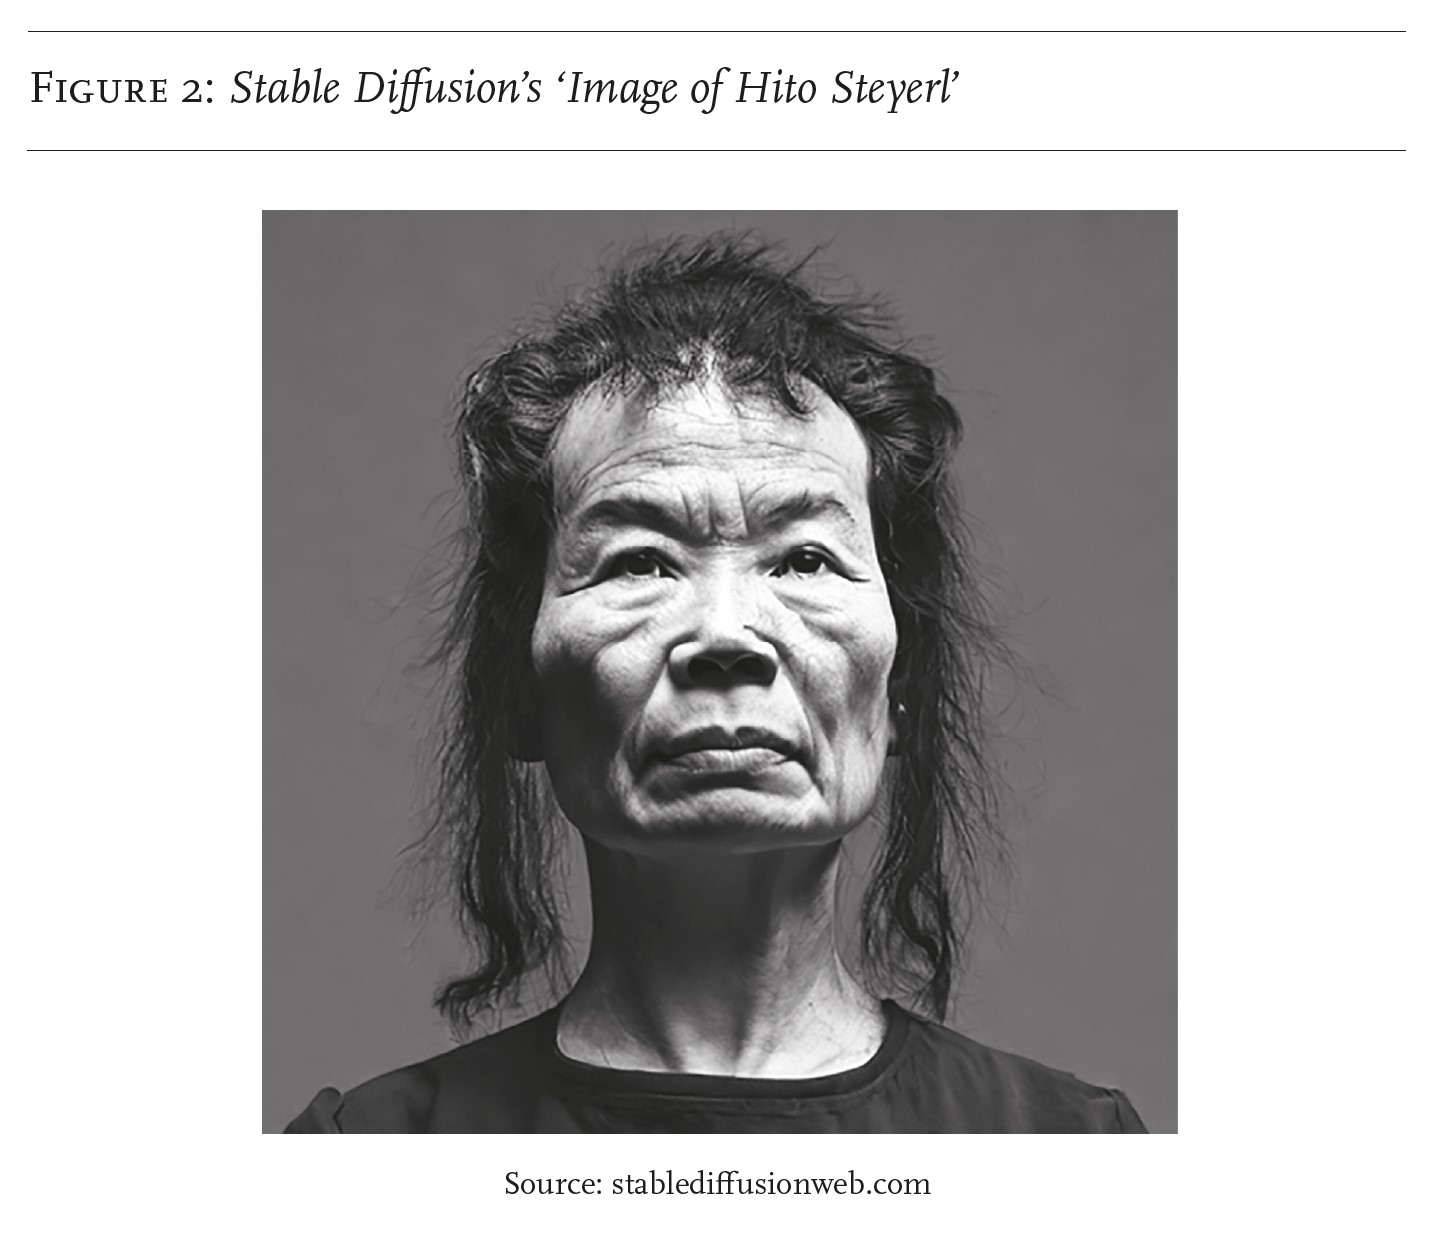
Come ha fatto Stable Diffusion a passare da A a B? Sicuramente non è l’accostamento “prima e dopo” più lusinghiero a cui si possa pensare; non ne consiglierei l’esperienza. È piuttosto meschino (mean), o persino umiliante (demeaning); ma è proprio questo il punto. La domanda è, di che tipo di media (mean) si tratta? La media di chi? Qual è? Stable Diffusion rappresenta questo mio ritratto in un intervallo di età congelato, prodotto da processi interni e sconosciuti che hanno un rapporto spurio con il dataset. Il colpevole non è un algoritmo “black box”, poiché il codice di Stable Diffusion è noto. Piuttosto, potremmo chiamarlo un algoritmo white box, o un filtro sociale. Ciò che vediamo è un’approssimazione di come la società, attraverso il filtro dell’immondizia media disponibile online, mi vede. Basta semplicemente togliere il rumore della realtà dalle mie foto ed estrarre al suo posto il segnale sociale; il risultato è una “immagine mean”, una rappresentazione di medie correlate, oppure: diverse sfumature di medio e di meschino (mean).
La parola inglese “mean” ha molteplici significati, tutti applicabili in questo contesto. “Mean” può riferirsi a delle origini umili o ignobili, alla norma, all’avarizia o alla cattiveria. È legato al meaning nel senso di significato, a delle idee di ciò che è comune, ma anche ai mezzi finanziari o strumentali. Il termine stesso è un composto che sfoca e sovrappone degli strati di significato apparentemente incompatibili. In esso si mescolano e si addensano valori morali, statistici, finanziari ed estetici, così come delle posizioni comuni e appartenenti alle classi meno abbienti, in una configurazione vagamente compressa. Le immagini mean sono lungi dall’essere allucinazioni casuali; sono prodotti prevedibili del populismo dei dati. Esse captano dei pattern sociali latenti che codificano significati discordanti e li usano come coordinate vettoriali. Rendono visibili delle attitudini sociali realmente esistenti che associano ciò che è comune con una posizione sociale inferiore, con la mediocrità e con un comportamento sgradevole. Si tratta di immagini residue che si imprimono negli schermi e nelle retine molto tempo dopo che è stata eliminata la loro fonte. Mettono in atto una psicoanalisi senza psiche né analisi per un’età dell’automazione in cui la produzione è aumentata dalla fabbricazione su vasta scala. Le immagini mean sono sogni sociali senza sonno, che processano le funzioni irrazionali della società portandole alle loro conclusioni logiche. Sono espressioni documentarie delle opinioni che la società ha di sé stessa, sequestrate attraverso la cattura caotica e il furto dei dati su vasta scala. E fanno affidamento su enormi infrastrutture di hardware inquinante e di manodopera umile e senza diritti, sfruttando il conflitto politico come risorsa.
Il problema di Giano
Quando Dreamfusion, uno strumento di text-to-3D, venne testato nell’autunno del 2022, l* utenti notarono un problema interessante. I modelli 3D generati con il machine learning avevano spesso più volti che guardavano in direzioni diverse. A questo glitch è stato dato il nome di “problema di Giano” . Quale ne è stata la causa? Una risposta possibile è che nel riconoscimento e nell’analisi di immagini del machine learning venga posta troppa enfasi sui volti; il dataset contiene, in proporzione, più facce che altre parti del corpo. Le due facce di Giano, il dio romano degli inizi e delle fini, guardano al passato e al futuro; egli è anche il dio della guerra e della pace, della transizione da uno stato sociale a un altro.
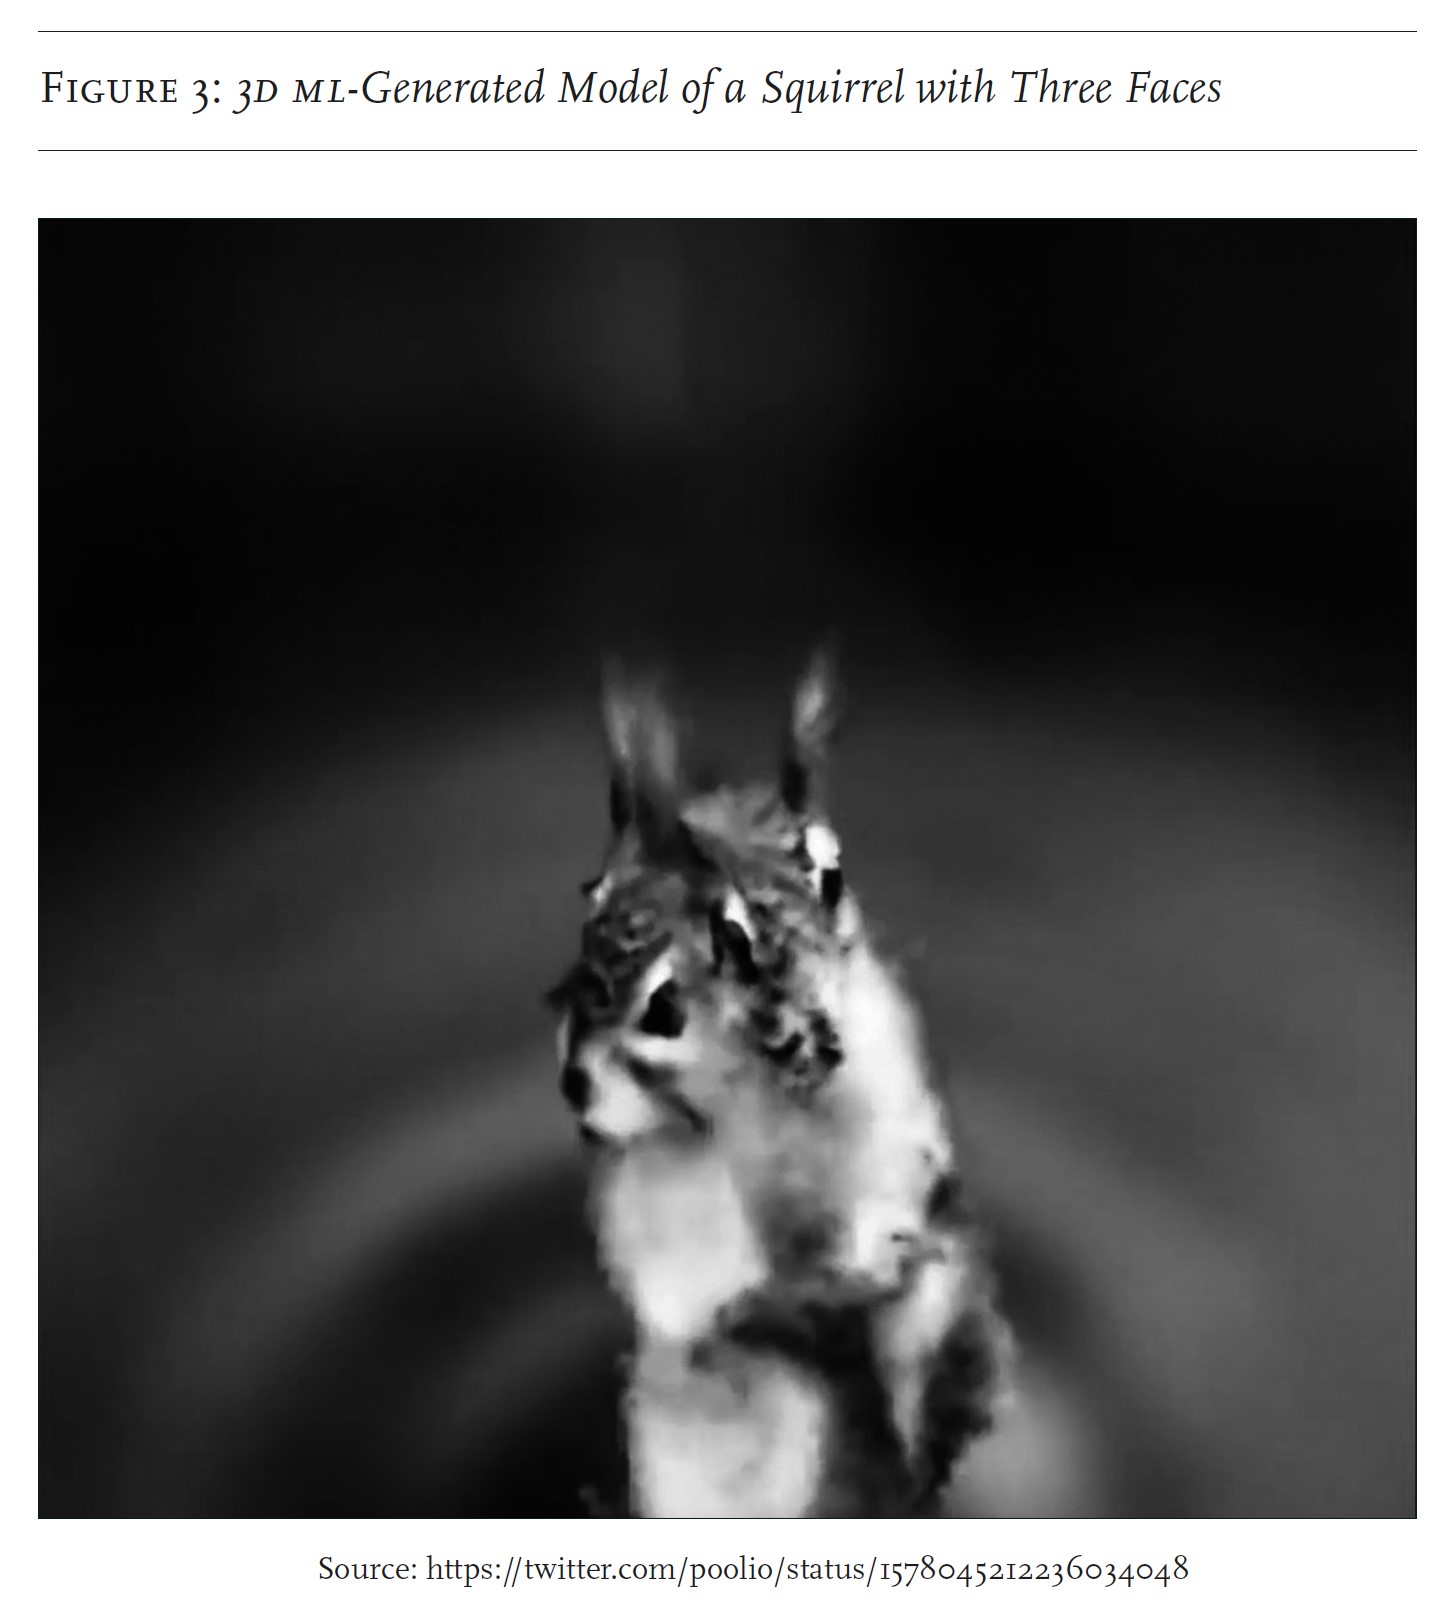
Fig. 3 – Modello 3D di uno scoiattolo a tre facce generato con machine learning.
Il problema di Giano nel machine learning tocca una questione cruciale: il rapporto tra l’individuo e la moltitudine. Come si può rappresentare la massa come un’entità unica? O al contrario l’individuo come una massa, come un collettivo, un gruppo, una classe o un leviatano? Qual è il rapporto tra l’individuo e il gruppo, tra interessi (e proprietà) privati e quelli pubblici, specialmente in un’epoca in cui i rendering statistici sono composizioni collettive assemblate sulla base della media?
Somiglianze
Ecco un’altra composizione in cui si trova impigliata la mia faccia.
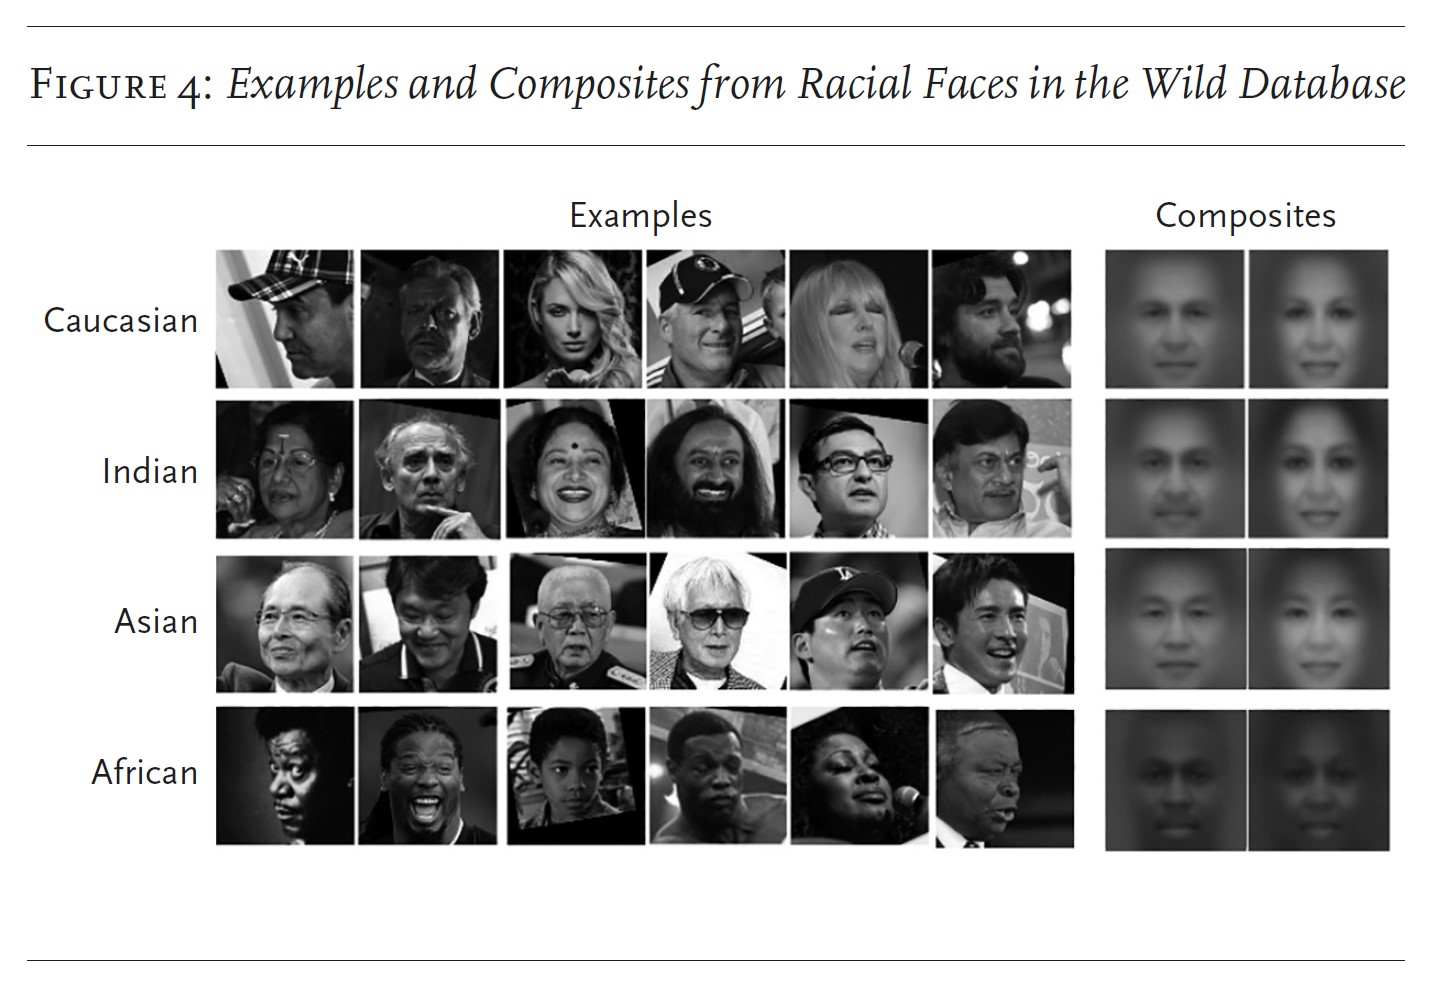
Fig. 4 – Esempi e composizioni di facce razzializzate da Wild Database.
Le immagini spettrali con un genere preciso che vediamo sulla destra potrebbero essere definite come una foto di gruppo verticale in cui le persone non si trovano l’una di fianco all’altra ma una sopra all’altra. Come sono state generate?
Nel 2016, il mio nome è comparso in un compendio chiamato MS-Celeb-IM, un database di Microsoft composto da 10 milioni di immagini di 100mila persone che si trovavano per caso su internet. Le informazioni sono state rilasciate dall* artist* Adam Harvey e Jules Laplace come parte di Megapixels, il loro progetto di ricerca sui database . Se il tuo nome era nella lista, Microsoft incoraggiava ricercatori e ricercatrici a scaricare le foto del tuo viso da internet per costruire un profilo biometrico. Ero diventata parte di un primo dataset per allenare degli algoritmi di riconoscimento facciale. Ma per cosa veniva usato e da chi?
Come si scoprì poi, MS-Celeb-IM suscitava l’interesse di diverse aziende e istituzioni. Veniva per esempio utilizzato per ottimizzare la classificazione in base all’etnia da parte di sviluppatori e sviluppatrici di un altro dataset, Racial Faces in the Wild. Ci furono lamentele per il fatto che la tecnologia per il riconoscimento facciale era meno efficace con le persone non bianche. Microsoft si impegnò allora per “risolvere” questo problema, caricando delle immagini dal dataset MS-Celeb-IM sull’interfaccia di riconoscimento Face++ e usando i punteggi relativi all’etnia dedotti per segregare le persone in quattro gruppi: caucasic*, asiatic*, indian* e african*. La motivazione esplicita era quella di ridurre il bias nel software per il riconoscimento facciale e diversificare il dataset . I risultati furono delle apparizioni fantasmatiche di fenotipi razzializzati, o un’idea quasi platonica di discriminazione in quanto tale.
Non è un caso che queste rappresentazioni fantasmatiche evochino i famosi ritratti compositi creati da Francis Galton negli anni Ottanta dell’Ottocento. Galton, un pioniere in sociologia, statistica ed eugenetica, sviluppò un metodo di sovrapposizione fotografica al fine di creare ritratti di cosiddetti tipi, come per esempio “ebreo”, “affetto da tubercolosi” e “criminale” . Gli eugenisti credevano nel “miglioramento della razza” e nella “riproduzione pianificata”, e alcuni proponevano metodi come la sterilizzazione, la segregazione e persino lo sterminio, al fine di liberare la società da alcuni tipi considerati “inadatti”. I fantasmi si rivelarono spesso essere delle foto segnaletiche delle categorie che avrebbero dovuto scomparire.
È stato scritto molto sulla formazione eugenica dei pionieri della statistica, compreso per esempio Ronald Fisher. Ma la statistica come scienza si è evoluta da allora . Come spiega Justin Joque, i metodi statistici furono perfezionati nel corso del XX secolo per includere i meccanismi e i parametri del mercato, come i contratti, i costi e i prezzi, e per registrare i rischi economici di risultati falsi positivi e falsi negativi.Il risultato è stato quello di integrare la collaudata matematica da casinò nella scienza statistica . Utilizzando i dati, i metodi bayesiani potevano invertire la procedura di Fisher per dimostrare o confutare la cosiddetta ipotesi nulla. Il nuovo approccio funzionava al contrario: si partiva dai dati e si calcolava la probabilità di un’ipotesi. Una determinata risposta può essere invertita in modo da combaciare con la domanda corrispondente più probabile. Nel corso del tempo, i metodi per il calcolo della probabilità sono stati ottimizzati per la redditività, aggiungendo i meccanismi di mercato a quelli di selezione.
I rendering statistici aggiungono un effetto visivo quasi magico a questa procedura. Poiché le categorie sembrano emergere dai dati stessi, acquisiscono l’autorità di una manifestazione o apparizione immediata. I dati non vengono più presentati attraverso i mezzi tradizionali di grafici, raggruppamenti, curve, diagrammi o altre astrazioni scientifiche; vengono invece visualizzati nella forma della cosa che dovrebbero astrarre. Saltano la mediazione e alludono a una finta immanenza. I processi di astrazione e alienazione sono sostituiti da processi confusionari di retropropagazione o, più semplicemente, da filtri sociali. Se Joque ricorre al concetto proposto da Sohn-Rethel di astrazione reale per descrivere le modalità del rendering statistico, le “immagini medie/meschine” potrebbero essere descritte come “astrazioni autenticiste” . Tale paradosso riflette un’incoerenza fondamentale che sta al centro di questa modalità di rappresentazione. Pur essendo basate su medie correlate, simili rappresentazioni convergono verso valori estremi e irraggiungibili, come per esempio gli ideali del corpo anoressico. Un risultato irrealistico e probabilmente irrealizzabile viene prescritto come norma; questa è una modalità di condizionamento sociale umano che precede di molto il machine learning.
Nelle immagini mean le statistiche vengono integrate direttamente nella somiglianza di un oggetto, attraverso la determinazione delle affinità. Se Galton usava questo trucco per i volti, le rappresentazioni statistiche estendono ulteriormente il suo metodo al regno delle azioni, delle relazioni e degli oggetti, ossia il mondo in generale. La comparsa apparentemente spontanea di queste distribuzioni cela le operazioni all’interno degli “strati nascosti” delle reti neurali. Queste a loro volta piegano le relazioni sociali esistenti per convergere verso uno “stato ottimale” altamente ideologico attraverso ogni sorta di pesi e parametri legati al mercato. I mercati erano già visti come computer iper-efficienti da von Mises e Hayek. In effetti, all'interno delle mitologie economiche liberali, i mercati svolgono il ruolo di intelligenze artificiali generali, o AGI; strutture superiori, suppostamente onniscienti, che non dovrebbero essere disturbate o regolate. Le reti neurali sono quindi viste come un’imitazione della logica di mercato, in cui la realtà è sottoposta a un’asta permanente.
Questa integrazione della statistica è chiara nel caso dei modelli 3D di Dreamfusion. La più comune analogia statistica è la famosa moneta che, se lanciata, ha il 50% di probabilità di cadere rispettivamente su testa o croce, se non è truccata. Ma nel problema di Giano, la probabilità di ottenere testa piuttosto che croce è molto più alta del 50%. Anzi, potrebbe anche non esserci proprio croce. Sviluppatori e sviluppatrici rimarcano il problema fondamentale legato alla produzione di rappresentazioni in 3D a partire da immagini in 2D. Inoltre, come sottolineato sopra, i dati potrebbero essere distorti, l’algoritmo potrebbe presentare difetti o lacune; oppure l’esperimento stesso e gli strumenti utilizzati potrebbero non essere né giusti, né equi. A prescindere dal caso specifico, Dreamfusion ha prodotto il suo bivio di probabilità: al posto di testa o croce, la probabilità è testa e testa.
Ma come si applica tutto questo alle composizioni a più teste di Racial Faces in the Wild (RFW) in cui sono stata incastrata? Nella logica liberale di estrazione digitale, lo sfruttamento e l’ineguaglianza non vengono messe in dubbio; sono, al massimo, diversificate. In questo senso, l* autor* di RFW hanno provato a ridurre il pregiudizio razziale all’interno del software di riconoscimento facciale. I risultati sono stati facilmente riadattati per una più accurata identificazione delle minoranze attraverso algoritmi di visione artificiale. I reparti di polizia attendono e ambiscono da tempo a un riconoscimento facciale ottimizzato per volti non caucasici. È proprio questo che pare essere successo alla ricerca generata da MS-Celeb-IM.
Anche SenseTime se ne è accorta . SenseTime è un’azienda di intelligenza artificiale che, fino ad aprile 2019, ha fornito alle autorità cinesi un software di sorveglianza utilizzato per monitorare e tracciare le persone appartenenti alla popolazione uigura; è stata segnalata più volte come potenzialmente collegata a violazioni dei diritti umani . Sembra che la combinazione del mio nome e del mio volto sia stata utilizzata non solo per ottimizzare la visione artificiale per la classificazione razziale, ma pare anche che questa ottimizzazione sia stata rapidamente messa in pratica per identificare e tracciare i membri di una minoranza etnica in Cina. Il fatto che io esista su internet è stato sufficiente a trasformare il mio volto in un vero e proprio strumento di discriminazione, brandito da un’autocrazia digitale realmente esistente. Ormai la maggior parte dei volti che compaiono su internet è stata probabilmente inclusa in operazioni di questo tipo.
I mezzi della produzione media
C’è un’altra ragione più pertinente per cui la presunta eliminazione di pregiudizi nei dataset crea più problemi di quanti non ne risolva. Il processo limita i cambiamenti ad alcune parti della produzione, rendendo queste ultime più gradevoli per consumator* occidentali e liberali, mentre lascia intatta la struttura dell’industria e i suoi modi di produzione. Il problema non ha solo a che fare con la media (sociale), ma anche con i più ampi mezzi di produzione. Chi li detiene? Chi è che le produce? Dove si svolge la produzione e come funziona?
La creazione di filtri pensati per sbarazzarsi di produzioni di reti dannose e parziali è un compito che viene sempre più affidato esternamente ad agenti meno privilegiat*, l* cosiddett* microlavorator* o ghostworker. L* microlavorator* identificano e annotano il materiale violento, parziale e illegale all’interno dei dataset. Svolgono questa mansione nella forma di “microcompiti” sottopagati che trasformano le condutture digitali in nastri trasportatori. Come riportato dalla rivista Time nel gennaio 2023, all* lavorator* sottopagat* in Kenya è stato chiesto di allenare una rete neurale «su esempi marcati di violenza, discorsi d’odio e abuso sessuale» . Questo rilevatore viene utilizzato ormai all’interno dei sistemi di ChatGPT di OpenAI. Nelle metropoli occidentali, l* microlavorator* vengono spesso reclutat* all’interno di comunità a cui viene impedito l’accesso al mercato del lavoro ufficiale attraverso una legislazione mirata a rifugiat* e migranti, come emerge in questa intervista anonimizzata a un* lavorator* digitale in una metropoli tedesca:
«Lavorator* digitale: Ci trovavamo tutti nella stessa situazione di profonda vulnerabilità. Eravamo appena arrivati in città e nel Paese, provavamo a integrarci e avevamo un bisogno disperato di lavoro. Tutto lo staff sul mio piano aveva almeno una laurea magistrale, non ero l’unico ad averla. Uno dei miei colleghi era un biologo specializzato nella ricerca sulle farfalle e doveva lavorare agli stessi compiti che dovevo svolgere io. Dato che era troppo difficile trovare un lavoro vero inerente al proprio percorso di studi, le persone semplicemente prendevano questo lavoro part-time. Si trattava di persone altamente qualificate, con diversi background linguistici.
Intervistatore: Erano tutti stranieri?
Lavorator* digitale: Sì, tutti.
Intervistatore: Com’era il lavoro?
Lavorator* digitale: Tremendo. Ed era così per tutte le persone che ho incontrato lì. Durante la formazione ti viene detto che vedrai pedofilia, contenuti forti, linguaggio sessualmente esplicito. E poi quando inizi davvero a lavorare sei seduto alla scrivania e vedi cose che hanno dell’incredibile. Ti chiedi se è reale. Gli effetti a lungo termine di questo lavoro sono parecchio spiacevoli. Non c’è stata una singola persona nel mio gruppo che non abbia avuto problemi dopo. Problemi come disturbi del sonno, perdita di appetito, fobie, ansia sociale. Alcuni sono dovuti anche andare in terapia. Il primo mese ti viene fatta una formazione molto intensa. Dovevamo imparare a riconoscere contenuti troppo drastici, dato che l’AI o i meccanismi di machine learning non erano in grado di decidere sui casi delicati. La macchina non ha sentimenti e non era abbastanza accurata.
Diventai depresso. Ho dovuto iniziare a fare terapia. Mi vennero prescritti dei farmaci. All’inizio del mio lavoro, la mia mansione principale era quella di passare al setaccio i post con contenuto sessualmente esplicito e i cosiddetti casi ad alta priorità, che di solito avevano a che fare con il suicidio o l’autolesionismo. C’erano tante immagini di persone che si tagliavano. Dovevo analizzare quali erano autolesionismo e quali suicidi. Il secondo mese, chiesi al mio team leader di mettermi in un altro ambito perché stavo male.
C’erano molte regole da rispettare: niente cellulari, niente orologi, niente apparecchi per fare foto. Niente carta, niente penne, niente supporti per annotare cose. Qualche volta, abbiamo visto dei droni che volavano fuori dalle nostre finestre. Qualcuno diceva che delle spie stessero cercando di filmare quel che accadeva nella nostra azienda. Ci venne detto di chiudere le tende quando succedeva. Una volta c’era un giornalista fuori dall’edificio. Ci venne detto di non lasciare l’edificio e di non parlare col giornalista. Per l’azienda i giornalisti erano sostanzialmente dei nemici.
Intervistatore: Con quale forma di AI lavoravi tu?
Lavorator* digitale: Non so molto dell’AI utilizzata dove lavoravo. Penso che cercassero di nasconderla, in qualche modo. Tutto quello che sapevamo è che c’era un qualche tipo di machine learning, perché di base volevano sostituire gli esseri umani con un software AI. Ricordo che una volta provarono a utilizzare questo software, ma era molto poco accurato, quindi smisero di farlo.
Intervistatore: Di che tipo di software si trattava, qual era la sua funzione esattamente?
Lavorator* digitale: Non ne ho idea. Informazioni di questo tipo venivano trasmesse solo ai piani alti dell’azienda. Venivano mantenute segrete. E, anche se sentivamo voci di corridoio qua e là, ci tenevano all’oscuro di questo progetto. Ma l’AI era un fallimento perché l’algoritmo non era preciso. Si parla di intelligenza artificiale ma la tecnologia che ci sta dietro ha ancora molto poco di eccezionale, direi. È per questo che hanno bisogno di noi esseri umani. Le macchine non hanno sentimenti, non possono toccare nulla. Il compito principale era quello di far lavorare le persone come me come se fossimo robot» .
Un’altra intervista condotta all’interno dello stesso progetto ha fatto emergere come l* lavorator* digitali sirian* in Germania abbiano dovuto filtrare e revisionare delle immagini delle loro città natali, distrutte da recenti terremoti, e, in alcuni casi, delle rovine delle loro vecchie case . Queste immagini erano considerate troppo violente per l* consumator* dei social media ma non per coloro che abitavano in quei posti, che erano stat* espuls* dalla guerra e dalla distruzione ed erano stat* obbligat* a diventare ghostworker in esilio. La violenza militare aveva, in modo conveniente, messo a disposizione delle multinazionali digitali tedesche una nuova forza lavoro di rifugiat*, facilmente sfruttabile.
Modificare la tecnologia per renderla più “inclusiva” può quindi portare a una migliore identificazione delle minoranze, mentre si esternalizza un lavoro traumatizzante e malpagato. Può ottimizzare la discriminazione, igienizzando superficialmente le applicazioni commerciali e creando, al contempo, gerarchie di classe fondate sullo sfruttamento. I conflitti politici e militari, così come le le barriere migratorie razziste, sono strumenti importanti per la creazione di questa forza lavoro senza diritti. Forse il bias non è un difetto o un bug, ma una caratteristica importante di un sistema di produzione meschino. I bias non sono produttivi solo a livello di rappresentazione, per il fatto che sviliscono visivamente le persone; la loro presunta eliminazione è altrettanto produttiva nel contribuire a consolidare le gerarchie di classe sostenute da guerre, conflitti energetici e sistemi di frontiera razzisti, e può essere sfruttata all’interno di un sistema di produzione ingiusto.
L’eliminazione dei bias non è l’unico compito dell* microlavorator*. Il loro lavoro consiste anche nel taggare le fotografie delle strade per le auto a guida autonoma e classificare le immagini di oggetti e persone per aiutare le reti di machine learning a distinguerle. Come è stato notato da molt* scrittor*, l* ghostworker uman* sono il motore dell’automazione: le auto a guida autonoma non potrebbero funzionare senza di loro. L’automazione si basa sulla media dei microgiudizi operati da interi contingenti di di esseri umani sottopagati, non su un computer super intelligente. In alcuni casi, questo porta al fatto che le persone “impersonano” delle AI, anche quando non viene applicato in alcun modo il machine learning. In un articolo leggiamo:
Abbiamo intervistato K., un imprenditore parigino e fondatore di una start-up che ha accusato i suoi competitor perché hanno dichiarato di utilizzare AI quando in realtà esternalizzano tutto il lavoro a esseri umani reclutati attraverso piattaforme oltreoceano. K. ha dichiarato persino che «il Madagascar è il leader dell’intelligenza artificiale francese». S., uno studente che ha fatto uno stage in una start-up che si occupa di AI e che offre suggerimenti di viaggi di lusso personalizzati alle persone abbienti, è rimasto ancora più sconvolto. La strategia di comunicazione della sua azienda enfatizzava l’utilizzo dell’automazione garantita da un sistema di suggerimenti basato, così dicevano, sulle preferenze degli utenti estratte dai social media. Ma dietro le quinte, il sistema esternalizzava tutti i suoi processi a dei micro-fornitori in Madagascar. Non implementava alcun tipo di machine learning, e lo stagista non ha potuto acquisire le competenze high-tech che desiderava .
I layer nascosti delle reti neurali celano anche la realtà della manodopera umana, oltre che l’assurdità delle mansioni svolte. La magia apparentemente immediata derivante dall’emanazione spontanea di immagini a partire da un mucchio di dati si basa sullo sfruttamento e l’espropriazione massiccia a livello di produzione. Forse le emanazioni apparentemente fantasmatiche di volti nelle rappresentazioni statistiche sono di fatto dei ritratti di microlavorator* nascost* che perseguitano e pervadono le immagini mean.
La manodopera sommersa è cruciale anche per i dataset utilizzati per allenare i generatori di prompt. I 5,8 miliardi di immagini e didascalie recuperati da internet e raccolti su LAION-5B, il dataset open source su cui è stato addestrato Stable Diffusion, sono tutti prodotti da manodopera umana non retribuita, «dalle persone che codificano e progettano siti web agli utenti che caricano e pubblicano immagini su di essi» . Va da sé che a nessuna di queste persone è stato offerto un compenso o una quota del dataset o i prodotti e i modelli costruiti a partire da esso. All’interno del capitalismo digitale e oltre, i diritti legati alla proprietà privata sono importanti solo quando si tratta di proprietari ricchi. Chiunque altro può essere regolarmente derubato.
Dalla media alla comunità?
Diventa ora più chiaro perché i modelli 3D bifronte mostrano molte più teste che croci: la “moneta” è truccata. Che atterri su testa o “testa”, sull’automazione o, per usare il termine di Astra Taylor, la “falsautomazione” (fauxtomation), il banco vince sempre. Ma la questione delle condizioni lavorative potrebbe permettere una più ampia osservazione relativa al rapporto tra statistica e realtà, o la questione della correlazione e della causalità. Molt* scrittor*, me compresa, hanno interpretato la transizione da una scienza basata sulla causalità verso degli assunti basati sulla correlazione come un esempio di pensiero magico o uno scivolamento verso l’alchimia. Ma se questo slittamento cogliesse anche un aspetto saliente della realtà? Una realtà che, piuttosto di essere governata dalla logica o dalla causalità, sta di fatto diventando strutturata in maniera molto più simile a un casinò?
Il post di un blog sulla depressione e i videogiochi fornisce un esempio illuminante. L’autrice racconta come giocare ai videogiochi in momenti di depressione possa, nello specifico, aiuta a godersi dei compiti piccoli e ripetitivi che portano a un risultato costruttivo, come un raccolto che viene piantato o una casa che viene costruita:
Ciò che rende il lavoro legato ai videogiochi così stimolante è la possibilità di godersi appieno la ricompensa dei propri sforzi. Metti nel gioco quel che ne ricavi, in modo molto diretto. I giochi più soddisfacenti sono in realtà delle simulazioni fantastiche basate sul fare esperienza del valore marxista più semplice: alla manodopera spetta tutto ciò che crea .
L’autrice descrive un rapporto causale tra input e output, tra lavoro e compenso. La sorprendente conclusione è che questa causalità all’interno del capitalismo reale è rara, specialmente nel lavoro precario. Qualsiasi sforzo tu faccia non creerà un risultato adeguato in maniera lineare, come un salario decente o un’adeguata forma di compenso. Le forme di lavoro precarie e altamente cognitive non producono rendimenti lineari; causa ed effetto sono scollegati. Questo introduce anche un fattore di classe nella distribuzione reale della causalità rispetto alla correlazione. I lavori pagati all’ora mantengono un livello più alto di causalità rispetto a quelli che si trovano nel regno non regolato del caso, a entrambe le estremità della scala del salario. È dunque razionalmente più “sensato” che molte persone trattino l’esistenza quotidiana come un casinò e che sperino in colpi di fortuna basati sulla speculazione. Se tutto ciò a cui puoi ambire all’interno di un paradigma causale è un guadagno pari a zero, allora comprare un biglietto della lotteria diventa una scelta eminentemente razionale. Il lavoro inizia ad assomigliare al gioco d’azzardo. Phil Jones descrive il microlavoro in termini simili:
Chi lavora opera quindi sempre più all’interno di un’economia quasi magica basata sull’azzardo e la scommessa. Il microlavoro rappresenta il tremendo apice di questa traiettoria, in cui la possibilità che il prossimo compito venga retribuito porta i lavoratori a tornare continuamente per ricevere di più. Programmazioni di compensi intricate e tariffari contestabili rendono le mansioni un gioco e di fatto riconfezionano la ridondanza e la precarietà come nuove ed entusiasmanti forme di lavoro-passatempo .
Quando «il salario (wage) si trasforma in una scommessa (wager)», la probabilità non è semplicemente la valutazione di un risultato reale ma diventa parte di quello stesso risultato . I rendering statistici tengono conto di questo. Una volta che la causalità sociale viene parzialmente sostituita dalla correlazione, i rapporti di produzione vengono riportati ai tempi degli opifici vittoriani, le immagini convergono verso delle scommesse e la fabbrica diventa una casa da gioco. La fotografia indessicale era, almeno in parte, basata su una relazione causa-effetto. Ma nelle rappresentazioni statistiche, la causalità si disperde in un insieme confuso di processi perlopiù non lineari che non sono contingenti ma che vengono anzi manomessi in modo opaco.
La manodopera precaria nelle industrie legate al machine learning e i processi ripetitivi di condizionamento e allenamento che essa richiede portano a chiedersi: chi o che cosa viene allenato? Chiaramente, non sono le macchine, o più precisamente le reti neurali; anche le persone vengono addestrate, come microlavorator* ma anche più generalmente come utenti. Per ritornare alla puntuale domanda posta da Herndon e Dryhurst: “Have I been trained?” La risposta è sì. Non solamente le mie immagini ma io stessa. I generatori di immagini basati su prompt come DALL-E fanno ovviamente affidamento sul training di modelli di machine learning. Ma soprattutto, essi allenano l* utenti a utilizzarli e, così facendo, l* integrano all’interno dei nuovi canali di produzione, delle masse di hardware e software che si allineano con le applicazioni corporate di machine learning di marca.
Le industrie del machine learning normalizzano un ambiente di produzione frammentato in cui l* utenti devono costantemente pagare l’affitto in un sistema cloud, non solo per essere in grado di utilizzare ma anche solo per accedere agli strumenti e ai risultati del loro stesso lavoro. Un esempio fra tanti è Azure, che secondo Microsoft è «l’unico cloud pubblico al mondo a offrire a supercomputer dotati di AI delle enormi capacità di scale-up e scale-out». Azure noleggia applicazioni computazionali di machine learning e potenza di calcolo, mentre Microsoft ha stabilito una struttura top-down di base che include software e hardware, browser, accesso a modelli, interfacce di applicazione (API), e così via, adattati al machine learning. Adobe, il quasi-monopolio più odiato, complicato ed estrattivista al mondo per l* lavorator* delle immagini, si sta muovendo rapidamente nella stessa direzione. Dwayne Monroe definisce questo tipo di quasi-monopolio una «struttura da super redditieri», nella quale le corporation digitali privatizzano i dati dell* utenti e rivendono loro i prodotti: «L’industria tech ha monopolizzato una serie di beni comuni per poi affittarci l’accesso a ciò che dovrebbe essere liberamente disponibile» .
Molt* impiegat* digitali e amministrativ* sono minacciat* dall’automazione basata sul machine learning; tra di loro si trovano, in ordine sparso, programmator*, professionist* delle PR, web designer e contabili. Ma è più probabile che molt* di loro saranno costretti a “aggiornarsi” noleggiando servizi costruiti sul loro stesso lavoro rubato, pur di rimanere “competitiv*”, piuttosto che essere sostituiti completamente dall'automazione del machine learning. Oggi, la formazione per quest* professionist* consiste nell’abituarsi alla propria scomparsa sul medio termine e nell’essere condizionat* a dipendere da una massa di monopoli per poter continuare a lavorare e accedere ai risultati del proprio lavoro.
Tutto questo riporta l’attenzione su un altro aspetto ancora relativo alle immagini mean. Come gli NFT, le rappresentazioni statistiche sono strumenti che permettono l’accesso ad ambienti tecnologici specifici. Nel caso degli NFT, si tratta di un cripto-ambiente che opera attraverso strumenti come wallet, scambi o schedari. Nel caso del machine learning, l’infrastruttura consiste in architetture cloud enormi e top-down che consumano moltissima energia e che sfruttano il lavoro a basso costo basato sui click eseguito da persone che si trovano in zone di conflitto o da rifugiat* e migranti nei centri metropolitani. L* utenti vengono integrati in un gigantesco sistema di estrazione e sfruttamento che crea una gigantesca impronta di carbonio.
Prendere sul serio il problema di Giano, quindi, significa disfarsi di un sistema di estorsioni ed estrazioni multiple. Un primo passo sarebbe quello di attivare l’altro lato del Giano bifronte, ossia quello che guarda in avanti verso le transizioni, alle fini come inizi, piuttosto che quello che guarda indietro a un passato fatto di dati rubati. Perché non spostare la prospettiva verso un altro futuro? Un periodo basato su una tecnologia “piccola” e resiliente, che utilizza le configurazioni minime attuabili alimentate dall’energia rinnovabile, che non richieda furto, sfruttamento e regimi di monopolio per controllare i mezzi di produzione digitali. Questo significherebbe liberarsi da un’idea del futuro dominata da una sorta di schema piramidale digitale-oligarchico basato sulla manodopera di microlavorator* nascost* nel quale l’effetto causale è sostituito da correlazioni truccate. Se una faccia di Giano guarda verso il mean, l’altra si allunga verso i beni comuni.
[Testo originariamente pubblicato in AI & Conflicts. Volume 2, a cura di Daniela Cotimbo, Francesco D'Abbraccio e Andrea Facchetti. Brescia: Krisis Publishing, 2025. Titolo originale: “Mean Images”, New Left Review, 140/141 (2023)]