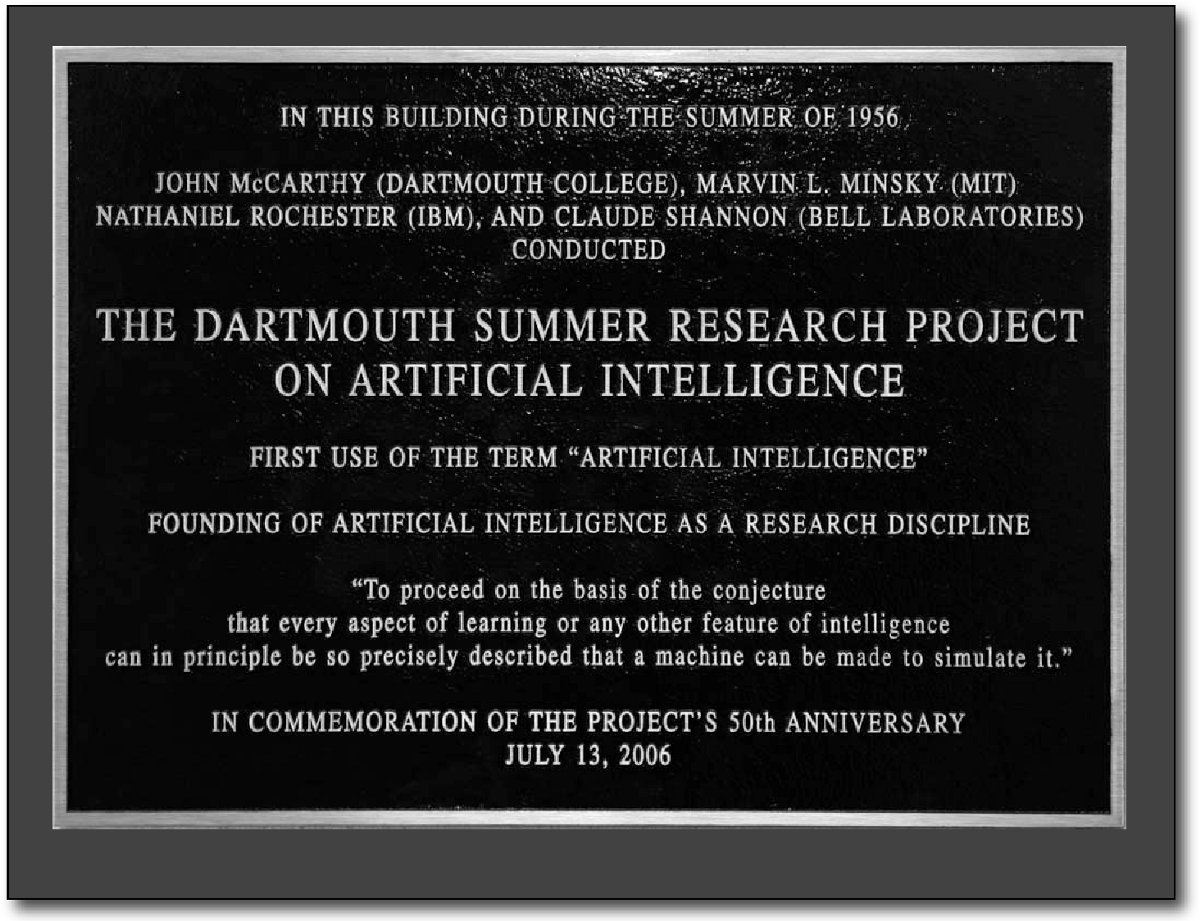
Una volta che i numeri caratteristici saranno stabiliti per la maggior parte dei concetti, l’umanità avrà quindi un nuovo strumento che migliorerà le capacità della mente in misura molto maggiore rispetto a quanto gli strumenti ottici rafforzano gli occhi, superando il microscopio e il telescopio nella stessa misura in cui la ragione è superiore alla vista. – Gottfried Wilhelm Leibniz
L’illuminismo […] non riguardava il consenso, non era orientato all’unità sistematica e all’utilizzo di una ragione strumentale: ciò che si sviluppò durante l’Illuminismo era un’idea moderna di verità definita dall’errore, un’idea moderna di conoscenza definita dal fallimento, dal conflitto, dal rischio, ma anche dalla speranza. – David Bates
Non esiste intelligenza nell’intelligenza artificiale, né questa impara veramente anche se il suo nome tecnico è machine learning; si tratta semplicemente di minimizzazione matematica. – Dan McQuillan
Quando cerchi finanziamenti, è intelligenza artificiale. Quando assumi personale, è machine learning. Quando implementi, è regressione logistica. – Joe Davidson
Cosa significa per l’intelligenza e, in particolare, per l’intelligenza artificiale, sbagliare, fare errori, infrangere una regola? L’epistemologo David Bates, riflettendo su una fase precedente della razionalità moderna, ha sostenuto che l’innovazione più importante dell’Illuminismo inteso come ricerca del sapere risiedesse non tanto nell’affermazione di una ragione strumentale e dogmatica, quanto piuttosto nell’introduzione di una nuova metodologia dell’errore . In maniera opposta, il progetto dell’AI (ovvero, quasi sempre, dell’AI aziendale), a prescindere dai suoi sogni di conoscenza sovrumana – e forse a causa di essi – non è in grado di riconoscere e discutere i limiti, le approssimazioni, le distorsioni, gli errori, le fallacie e le vulnerabilità che sono proprie del suo paradigma. Un paradigma della razionalità che fallisce nel fornire una metodologia dell’errore è destinato probabilmente a diventare una specie di caricatura, come nel caso della fantomatica idea dell’AGI (Artificial General Intelligence) .
Il machine learning si fonda tecnicamente su formule di correzione degli errori, ma raramente la natura, l’entità e le implicazioni di questi errori sono affrontate in modo approfondito all’interno della comunità dell* addett* ai lavori. Pur disponendo di un vasto repertorio di tecniche per correggere gli errori, gli sviluppatori di machine learning sono impegnati in una continua “ottimizzazione del codice”, ignorando l’impatto sociale delle loro approssimazioni logiche. Nel dibattito pubblico sull’AI, la complessità matematica dei calcoli ostacola la comprensione dei limiti logici dell’intelligenza artificiale. Di conseguenza, il discorso rimane polarizzato tra posizioni integrate e apocalittiche, tra tecnofilia e tecnofobia . La posizione integrata, sulla scia di Ray Kurzweil, immagina un sereno cammino verso la singolarità, fiduciosa che la matematica possa risolvere ogni problema e che l’automazione di massa si sviluppi senza sconvolgere l’ordine sociale. Nella posizione apocalittica, al contrario, fraintendendo l’effetto black box del machine learning, autori come Nick Bostrom e altri mettono in guardia rispetto a una futura era oscura della ragione, dominata da macchine fuori controllo . Questa seconda posizione condivide alcuni tratti con le teorie complottiste, per le quali l’AI non può essere studiata, né conosciuta, né controllata. Anche la prospettiva apocalittica, tuttavia, si limita a speculazioni ipotetiche (“E se l’AI…”), senza riuscire a spiegare la logica interna del machine learning (“Cos’è l’AI?”).
Per fortuna sta lentamente emergendo un approccio critico nei confronti dell’AI. Grazie a libri di successo come Armi di distruzione matematica di Cathy O’Neil sta diventando chiaro che il problema dell’AI non ha nulla a che vedere con l’intelligenza in sé, ma con il modo in cui questa viene applicata all’amministrazione della società e del lavoro attraverso modelli statistici, i quali dovrebbero essere trasparenti e visibili al pubblico . Come ha notato Yarden Katz, l’AI non è altro che un’operazione di marketing, un rebrand di ciò che fino a un decennio fa era noto come business dei Big data e dei data center . Scavando a fondo tra gli elementi essenziali dei bias algoritmici, Kate Crawford ha focalizzato l’attenzione sulle grandi implicazioni etiche delle classificazioni e delle tassonomie del machine learning, ricordando come questo sia «il più grande esperimento di classificazione della storia umana» . Il saggio Anatomia di un sistema AI di Kate Crawford e Vladan Joler rappresenta un esempio incisivo di analisi della black box dell’intelligenza artificiale: attraverso la decostruzione di un dispositivo Amazon Echo, l* autor* tracciano una rete di connessioni che legano ciascuno dei suoi componenti all’ecologia e all’economia globale. I tempi sembrano maturi per una critica radicale dell’intelligenza artificiale: Dan McQuillan, per esempio, sostiene l’ascesa di una controcultura che si posizioni contro l’apparato normativo opaco del machine learning .
In generale, l’AI può essere analizzata sia come costruzione tecnica che come fenomeno sociale. La discussione sui limiti dell’AI rischia però di risultare imprecisa se i limiti tecnici vengono isolati da quelli sociali, e viceversa. Le analisi di Deleuze e Guattari sull’orologio possono offrire spunti preziosi per interpretare e comprendere l’AI: possiamo considerare l’orologio sia come uno strumento meccanico che proietta un tempo universale, che come una disciplina astratta che controlla il tempo collettivo . Queste due prospettive ovviamente si intrecciano e si informano a vicenda; è l’assemblaggio sociale, tuttavia, a rivelare la verità del livello tecnico, rendendolo storicamente possibile ed efficace. Parafrasando ciò che Guattari ha affermato sulle macchine in generale, l’intelligenza artificiale è costituita da «forme iper-sviluppate e iper-concentrate di alcuni aspetti della propria soggettività [umana]» .
Lavorando nell’intersezione tra scienze umane e scienze computazionali, questo testo si pone l’obiettivo di abbozzare una grammatica generale del machine learning e di fornire sistematicamente una visione complessiva dei suoi limiti, delle sue approssimazioni, dei suoi bias, dei suoi errori, delle sue vulnerabilità, e delle sue fallacie. Il termine convenzionale Intelligenza Artificiale è utilizzato in questo testo per mostrare la ricezione pubblica e la spettacolarizzazione del machine learning e del business relativo all’analisi dei dati (Big data). Dal punto di vista tecnico, sarebbe più accurato definire l'intelligenza artificiale come machine learning o statistica computazionale. Tuttavia, questi termini risulterebbero meno accattivanti per il marketing aziendale, il mondo accademico e il mercato dell’arte. Dato il livello di mitizzazione e di pregiudizi sociali che circondano i suoi modelli matematici, l’Intelligenza Artificiale ha di fatto inaugurato un’era di vera e propria fantascienza statistica.
Introduzione al nooscopio: un diagramma generale del machine learning
Il padre delle reti neurali convoluzionali, Yann LeCun, sostiene che i sistemi AI contemporanei non siano versioni sofisticate di cognizione, ma di percezione . Il machine learning è nato alla fine degli anni ’50 come tecnica per il riconoscimento di pattern visivi, evolvendosi poi verso l’analisi di dati non visivi. Nelle auto a guida autonoma, per esempio, i pattern da identificare corrispondono agli elementi visivi più comuni in un contesto stradale, mentre nella traduzione automatica riguardano le sequenze di parole più ricorrenti tra due lingue. Tuttavia, ciò che il machine learning calcola non è uno schema preciso, bensì la distribuzione statistica associata a un pattern. Esaminando superficialmente il mercato dell’AI emergono costrutti statistici spesso complessi e difficili da analizzare in profondità. Come vengono costruiti questi modelli statistici? Quanto sono precisi e affidabili? Qual è la relazione tra i modelli statistici e l’intelligenza umana? Sarebbe in effetti giusto riformulare la domanda “Una macchina può pensare?” in una domanda più sensata a livello teorico: “Un modello statistico può pensare?”.
L’intelligenza artificiale non è affatto “intelligente”. È più accurato definirla come uno strumento di conoscenza o di amplificazione logica in grado di percepire schemi che vanno oltre le competenze della mente umana. Leibniz, riferendosi a questa modalità di AI, utilizza il telescopio e il microscopio come metafore per il suo calculus ratiocinator . In modo simile un sistema di machine learning può essere paragonato a un nooscopio, un dispositivo che mappa e percepisce schemi complessi attraverso vasti spazi di dati (ciò che le digital humanities definiscono distant reading) . Ciononostante, ogni strumento di misurazione e percezione porta con sé alcune anomalie intrinseche, legate alla contingenza. Così come le lenti del microscopio e del telescopio non sono mai perfettamente curvilinee e lisce, le lenti logiche delle AI contengono difetti e irregolarità. Studiare l’impatto delle AI significa analizzare in che misura i flussi di informazioni vengono diffratti, distorti e perduti nel processo. Per comprendere la natura di questa perdita, è fondamentale esaminare l’anatomia algoritmica dei modelli statistici alla base del machine learning.
In termini matematici il machine learning si utilizza per predire un output di valore y dato un input di valore x. L’algoritmo disegna una funzione che mette in relazione x a y imparando da dati pregressi in cui sia x e y sono conosciuti: y = f(x). Costruendo una funzione di questo tipo l’algoritmo sarà in grado di predire y basandosi su delle future configurazioni di x. Per esempio: date delle immagini di animali (x), l’algoritmo impara le loro associazioni con le categorie cane o gatto (y) e tenta poi conseguentemente di classificare nuove immagini. In questo caso l’input numero x è un’immagine digitale e l’output numero y è una percentuale relativa a un label semantico (97% gatto, 3% cane). Si tratta di un processo di classificazione che si distingue dalla regressione, nella quale l’output è un numero continuo. Un esempio di quest’ultima potrebbe essere un algoritmo che impara a predire l'affidabilità creditizia (output y) in base all’età di un gruppo di studenti (input x). La classificazione e la regressione sono entrambe forme di apprendimento supervisionato, in cui l’algoritmo utilizza dati nei quali la relazione tra l’input x e l’output y è già conosciuta, e cerca di prevedere l’output y per nuovi input x non conosciuti. In questo contesto, si dice che un algoritmo di machine learning approssimi la funzione che collega y a x.
Un sistema di machine learning si presenta a un* operator* o a un* utente come composto da tre elementi o fasi: dataset, algoritmo di training e applicazione del modello.
1. Dataset: il dataset contiene dati che devono essere analizzati al fine di estrarre conoscenza e intelligenza; ovvero schemi di associazione tra i suoi elementi. Nell’apprendimento supervisionato il dataset è composto da due elementi: l’input x (es. immagini raw, età degli studenti) e l’output y (caption che descrivono queste immagini, affidabilità creditizia). Nel training supervisionato o non supervisionato solo l’input x è dato, e da esso si deve rintracciare uno schema non conosciuto.
2. Algoritmo di training: l’algoritmo estrae pattern dai dataset leggendo le relazioni tra l’input x e l’output y e costruendo una descrizione statistica di questa associazione. Il modello statistico è il cuore del machine learning; deposito di “intelligenza” estratta dai dataset. Tuttavia, non è mai preciso al 100% e non esiste un metodo scientifico per valutarlo: il processo di training finisce quando un operatore umano decide che si è raggiunto un tasso di errore accettabile per un dataset di prova.
3. Applicazione del modello: quando il modello statistico è considerato sufficientemente addestrato e “si adatta” ai dataset, può essere applicato a differenti task come classificazione e predizione. Nella classificazione (o riconoscimento) un nuovo valore x è associato a un valore y, se x rientra nella distribuzione del modello statistico. Nella predizione (o generazione) un nuovo valore x è utilizzato per generare e predire il suo corrispondente valore y utilizzando lo stesso modello statistico (la generazione di pattern a livello logico equivale alla predizione).
Si può vedere la combinazione di questi tre elementi (dati + algoritmo + modello) come un diagramma generale del machine learning. Continuando a utilizzare la metafora del medium ottico, come telescopio o microscopio, si può dire che il flusso di informazioni che attraversa questo strumento di conoscenza (qui denominato nooscopio) si comporta come un fascio di luce proiettato dai dataset, diffratto dall’algoritmo e dal suo modello statistico, e riflesso nel mondo con una distorsione integrata. I paragrafi che seguono descrivono ciascuna componente individuale, concentrandosi in particolare sulla natura del modello statistico che si trova alla base del machine learning.
La digitalizzazione di massa, avviata dopo la Seconda Guerra Mondiale con la commercializzazione dei mainframe industriali e culminata negli anni 2000 con l’espansione dei data center globali, ha gettato le basi per un nuovo regime di estrattivismo dell’intelligenza. L’intelligenza artificiale è addestrata su grandi dataset accumulati in modi che non sono neutrali a livello tecnico, né imparziali a livello sociale. Non esistono dati neutri, poiché essi dipendono dal lavoro individuale, da dati personali e comportamenti sociali che si accumulano nel tempo attraverso reti estese e tassonomie culturali composite .
I dataset sono probabilmente il fattore più importante per la qualità della “intelligenza” che viene estratta dagli algoritmi del machine learning. Il dataset è solitamente costituito da dati di input e da dati di output ideali: ad esempio, le immagini raw possono essere associate a delle label (in che modo gli esseri umani comunemente classificano quelle immagini con il loro significato). Come delineato sopra in termini matematici, il machine learning è il calcolo della relazione tra le immagini iniziali (input) e le loro label (output) con l’obiettivo di prevedere le label (output) di immagini future simili (input). La creazione, formattazione e modifica del dataset è un’impresa complessa e delicata, probabilmente più significativa dei parametri tecnici che controllano l’algoritmo di training . Nella preparazione dei dataset si possono riconoscere quattro stadi:
1. Produzione: lavoro individuale o fenomeni che producono informazione.
2. Acquisizione: l’acquisizione di informazioni attraverso uno strumento che le trasforma in dati.
3. Formattazione: la codifica delle informazioni in un formato di dati specifico.
4. Catalogazione: l’applicazione di categorie di una data tassonomia al dataset.
I dataset più popolari utilizzati per il machine learning (NMIST, ImageNet, Labelled Faces in the Wild, ecc.) provengono da aziende, università e agenzie militari del nord globale (sebbene, osservando più attentamente, si rilevi una profonda divisione del lavoro che si estende nel sud globale). I dataset possono derivare da comportamenti spontanei online (tramite i social media, le coperture mediatiche, la geolocalizzazione dei telefoni cellulari, ecc.) o da lavoro digitale sottoposto a crowdsource (ad esempio, tramite Amazon Mechanical Turk). In entrambi i casi, vengono impiegate forme di manodopera invisibili e poco riconosciute. I dati personali, in particolare, sono nascosti e scompaiono nei dataset privatizzati, senza che se ne abbia consapevolezza e senza trasparenza . Ecco perché questi dataset sollevano anche questioni relative alla proprietà dei dati, alla privacy e ai diritti civili, temi su cui le istituzioni politiche e legislative stanno lentamente cominciando a prendere consapevolezza (si veda il Regolamento generale sulla protezione dei dati, GDPR, che è stato approvato nel maggio 2018 dal Parlamento europeo) .
Quando i dataset sono pronti per l’analisi vengono forniti all’algoritmo, che viene selezionato tra diverse opzioni da un operatore umano in base a parametri specifici. Ad esempio, le reti neurali convoluzionali richiedono la definizione di una topologia e di un insieme complesso di iperparametri (numero di strati, neuroni, tipo di connessione, comportamento di ciascun strato e neurone, ecc.). Sebbene le reti neurali siano nate inizialmente come tecniche di riconoscimento dei pattern, oggi gli scienziati computazionali preferiscono utilizzare l’espressione più astratta e precisa di mappatura input-output, per evitare il confronto, ormai obsoleto, con i sistemi biologici e la percezione visiva.
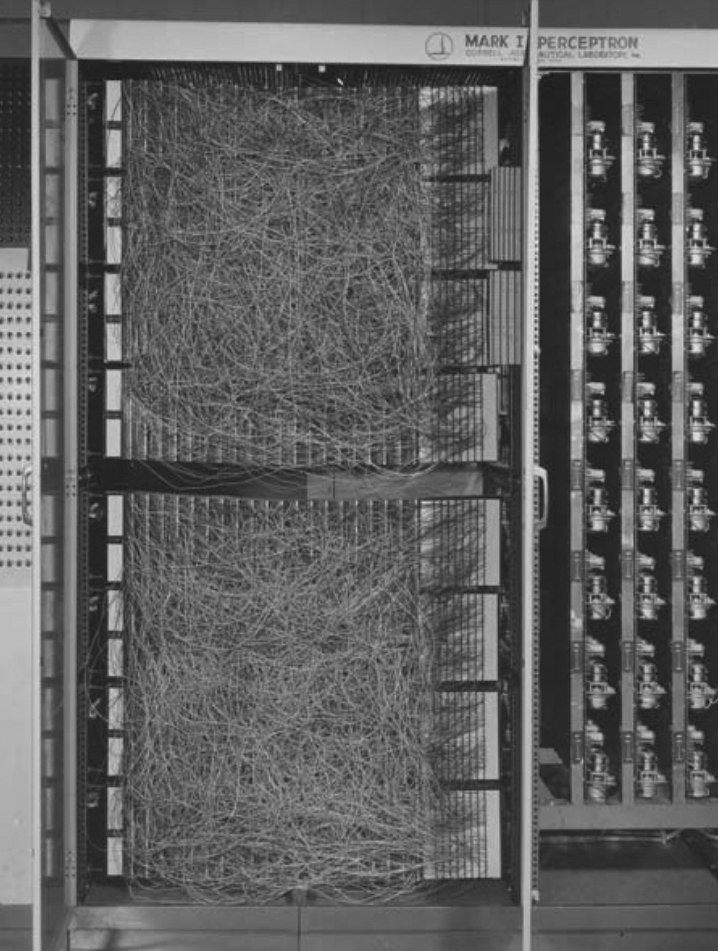
Ciononostante, la costruzione di una relazione tra un input x e un output y riguarda ancora fondamentalmente la ricerca di un pattern. Un esempio fondamentale di riconoscimento di pattern è il Perceptron di Frank Rosenblatt, creato nel 1957; la prima rete neurale operativa. Data una griglia visiva di fotorecettori 20x20, questa macchina poteva imparare a riconoscere una lettera semplice. Oggi, dato un input molto più complesso, come la registrazione video di una strada trafficata, la rete neurale di un’auto a guida autonoma non solo deve controllare le componenti meccaniche, ma anche prendere decisioni etiche di fronte a situazioni pericolose; ciò richiede quindi una mappatura input-output più complessa. Indipendentemente dalla loro complessità, dalla prospettiva numerica del machine learning nozioni come immagine, movimento, forma, stile e decisione possono essere tutte descritte come distribuzioni statistiche di un pattern. Per quanto riguarda il modello statistico si possono individuare tre modalità operative del machine learning: 1) training, 2) classificazione e 3) predizione. In termini più semplici, queste possono essere definite come: astrazione di pattern, riconoscimento di pattern e generazione di pattern.
1. Nella modalità di training (astrazione di pattern), l’algoritmo “impara” l’associazione tra un input x e un output y (il suo label, per esempio). Come già accennato, l’algoritmo tesse una distribuzione statistica dei pattern e li estrae dal loro contesto. Il modello statistico sarà considerato addestrato quando si raggiunge un tasso di errore accettabile su di un dataset di prova (ad oggi non esiste un metodo scientifico per determinare quando un modello è sufficientemente addestrato, cioè quando un’AI appare “intelligente”).
2. Nella modalità di classificazione (riconoscimento di pattern), i nuovi dati di input x vengono confrontati con il modello statistico per determinare se rientrano o meno nella sua distribuzione statistica. In caso affermativo, viene loro assegnato il label di output corrispondente y. Oggi esistono classificatori di oggetti in grado di rilevare tutti gli oggetti più comuni in uno scenario stradale e di applicare label come “persona”, “auto”, “camion”, “bicicletta” o “semaforo” in pochi millisecondi; ovviamente con un margine di errore.
3. Nella modalità di predizione (generazione di pattern), i nuovi dati di input x vengono utilizzati per prevedere il loro valore di output y. Si potrebbe dire che in questa modalità il modello statistico venga eseguito al contrario, per generare nuovi pattern invece di registrarli. L’espressione “arte creata dall’AI” indica in realtà che un operatore umano applica la modalità generativa delle reti neurali, dopo averle addestrate su un dataset. Una rete neurale addestrata con il dataset MIDI di un compositore musicale può per esempio generare una nuova melodia che ricalca lo stile del compositore stesso. La modalità generativa è utile come una sorta di “verifica della realtà” algoritmica, poiché mostra ciò che il modello ha appreso, ossia come il modello “percepisce il mondo”.
Il ciclo di retroazione informativa tra l’AI e la società, ovvero tra il machine learning e i suoi dataset, non è virtuoso, ma è compromesso da bias tecnici. Qualsiasi dataset – per quanto accurato possa apparire – rappresenta un campione statistico, quindi una visione parziale del mondo. Inoltre, il grado di compressione delle informazioni negli algoritmi di machine learning altera le proporzioni originali dei dati, amplificando così i bias. Per le sue dirette implicazioni sociali, quello relativo ai bias è il problema più discusso e conosciuto del machine learning, ed è un buon punto di partenza per illustrare i limiti logici dei suoi modelli statistici. Nell’ambito del machine learning è necessario distinguere almeno tra bias del mondo, bias dei dati e bias dell’algoritmo.
Il bias del mondo era già presente nelle società precedenti all’intervento tecnologico; i dataset rafforzano le diseguaglianze di razza, genere e classe, normalizzando ulteriormente stereotipi già operanti a livello sociale. La naturalizzazione del bias da parte del machine learning – ovvero l’integrazione della disuguaglianza in un algoritmo come dato apparentemente “imparziale” – ovviamente può essere pericolosa . Per individuare le categorie di bias, Kate Crawford ha distinto tra un pericolo nell’allocazione delle risorse (quando, ad esempio, un algoritmo nega mutui a un gruppo minoritario) e un pericolo nella rappresentazione sociale (come la denigrazione, la sotto-rappresentazione o la determinazione iniqua di razza, genere e classe) .
Il bias dei dati, invece, viene introdotto attraverso la raccolta, la formattazione e l’etichettatura dei dati nel dataset. L’atto stesso di raccogliere e formattare i dati può influenzare la risoluzione e l’accuratezza delle informazioni, ma la parte più delicata del processo è la classificazione dei dati. Università, aziende e agenzie militari costruiscono dataset con lavoro poco accurato e a basso costo, spesso utilizzando tassonomie vecchie e conservatrici, che producono una visione distorta delle culture e delle diversità del mondo. Queste tassonomie spesso riflettono gerarchie sociali e sono un’espressione di potere normativo, come già evidenziato da Foucault . Oggi, le tassonomie culturali e scientifiche vengono incorporate e formalizzate nel machine learning: il loro potere normativo non è più istituzionale, ma computazionale.
Il bias algoritmico (conosciuto anche come “bias della macchina”, “bias statistico” o “bias del modello”) è un’ulteriore amplificazione dei bias del mondo e dei bias dei dati, causata da errori computazionali, compressione delle informazioni e tecniche di approssimazione degli algoritmi di machine learning. A causa dei rapporti di compressione delle informazioni, gli algoritmi di machine learning diffrangono e distorcono i bias del mondo e quelli dei dati, causando disuguaglianze ancora più marcate. Un modo per illustrare questa diffrazione e amplificazione è considerare l’illusione della prospettiva anamorfica utilizzata nella pittura e nel graphic design. Anche il modo in cui il machine learning vede il mondo è anamorfico: pur rispettandone la forma o la topologia, ne distorce le proporzioni.
Al centro dei sistemi di AI attuali si trova un algoritmo di training il cui scopo è calcolare un modello statistico dei dataset. Gli scienziati informatici lo chiamano semplicemente “il modello”. Il modello è la rappresentazione statistica di un ampio e variegato numero di dataset racchiusa in un unico file. Fin dai tempi del Perceptron di Rosenblatt, la prima rete neurale operativa, l’obiettivo chiave del machine learning è stato quello di immagazzinare un piccolo modello statistico piuttosto che memorizzare, per esempio, mille immagini dello stesso oggetto da angolazioni diverse. Il modello viene calcolato utilizzando diverse tecniche (reti neurali, Support Vector Machine, reti bayesiane, ecc.) che assumono sempre la forma di una inferenza statistica e il cui output assume, di conseguenza, la forma di una distribuzione statistica. Tecnicamente si dice che il modello apprende la distribuzione statistica dei dataset mappando le correlazioni (note anche come pattern o dipendenze) tra gli input e gli output auspicati. Il modello statistico costruisce infine una funzione f che, quando è efficace, è in grado di descrivere i dataset in modo appropriato e di predirre l’output di un input futuro.
Prendiamo un esempio classico di machine learning: LeNet, sviluppato da Yann LeCun nel 1988: una rete neurale convoluzionale per il riconoscimento ottico di numeri nei codici postali e negli assegni bancari. I dataset vengono forniti dal database MNIST, che contiene 60.000 numeri scritti a mano (raccolti tra soli due gruppi sociali negli USA: studenti delle scuole superiori e impiegat* dell’ufficio di censimento). Il modello interno di LeNet registra l’associazione statistica tra le immagini fornite di numeri scritti a mano e la loro etichetta corretta, che in questo caso è un numero . Dopo essere stato addestrato, il modello statistico di LeNet riconoscerà le future occorrenze di numeri scritti a mano, con un margine di errore.
Un modello statistico si considera addestrato efficacemente quando riesce a estendere i pattern di un dataset su nuovi dati “nel mondo reale”, adattandosi ai nuovi dataset con il minor margine di errore possibile (c’è sempre un margine di errore nel machine learning). Se un modello apprende troppo bene i dataset, sarà in grado di riconoscere solo corrispondenze esatte, trascurando invece pattern basati su somiglianze e affinità. In questo caso, si dice che il modello è in overfitting, poiché non è in grado di distinguere i pattern dal contesto di riferimento, ossia ha appreso meticolosamente tutto, incluso il contesto. Al contrario, il modello è in underfitting quando non è in grado di estrarre pattern dai dataset. Nell’overfitting non c’è compressione delle informazioni, mentre nell’underfitting il modello perde la maggior parte delle informazioni importanti .
L’intelligenza artificiale viene comunemente descritta come la misura statistica di una correlazione tra dei punti dati. In effetti, il machine learning non impara nulla nel senso proprio del termine; si limita a mappare un input x e un output y, tracciando una funzione che descrive approssimativamente la loro tendenza, per poi applicare quella funzione a futuri input, per prevederne gli output. Anche questa funzione rappresenta un’approssimazione, nel senso che ipotizza le “parti mancanti” del grafico dei dati: sia attraverso l’interpolazione – cioè la proiezione e previsione di un output y che rientra nell’intervallo noto di input x nel dataset – sia attraverso l’estrapolazione, ovvero la proiezione e predizione di un output y oltre i limiti di x, spesso con alti rischi di inesattezza.
Il machine learning è estremamente efficace in quanto algoritmo per analizzare i dati e approssimare una funzione matematica che li descriva. L* informatic* preferiscono infatti la definizione di intelligenza artificiale come tecnica di compressione delle informazioni, diversamente dalla concezione popolare che vuole vederla come una manifestazione di coscienza sovrumana . Fin dai tempi antichi, gli algoritmi hanno rappresentato delle procedure di natura economica, progettate per raggiungere un risultato nel minor numero di passaggi possibile e consumando la minor quantità di risorse, come spazio, tempo, energia, ecc. Oggi la corsa alle armi tra le aziende di intelligenza artificiale è ancora basata sulla ricerca degli algoritmi più veloci per calcolare modelli statistici. La compressione delle informazioni dà quindi la misura della proporzione del profitto di queste aziende, ma anche della loro perdita di informazioni; quella perdita significa spesso la perdita delle diversità culturali del mondo.
L’analogia con lo strumento ottico offre una comprensione più chiara delle componenti dell’AI rispetto all’analogia con il cervello umano. Sorvolando per il momento sul fatto che la prima rete neurale operativa, il Perceptron, fosse un sistema visivo , seguendo il percorso delle riflessioni di Leibniz si può affermare che esistono delle somiglianze epistemologiche tra il machine learning e gli strumenti ottici come il microscopio e il telescopio . Il machine learning, come questi strumenti, presenta dei problemi sia nella risoluzione delle informazioni che nella diffrazione delle informazioni, poiché i modelli statistici hanno un ruolo correttivo simile a quello delle lenti negli strumenti ottici. Per quanto riguarda l’offuscamento delle informazioni, una questione probabilmente molto nota del machine learning è l’effetto black box, presente nelle grandi reti neurali (deep learning). “Black box” è un termine in voga utilizzato per descrivere come la compressione elimini molte informazioni apparentemente inutili, con il risultato di una condizione di offuscamento che non è reversibile .
Questo accade perché ogni strato di neuroni scarica la maggior parte dei dati ricevuti da quello precedente, dimenticando nel processo alcuni legami nella catena del “ragionamento”. Al di fuori dell’ambito informatico, quella della black box è diventata una metafora generalmente usata per indicare la complessità apparente dei sistemi di intelligenza artificiale, poiché questi possono sembrare inaccessibili e opachi, se non addirittura alieni e fuori controllo. Progetti come le Explainable Artificial Intelligence, l’Interpretable Deep Learning e l’Heatmapping, tra gli altri, hanno tuttavia dimostrato che è possibile entrare nella “scatola nera” e rendere la sua catena oscura di calcoli interpretabile per gli utenti .
A causa del livello di compressione e di perdita delle informazioni che si verifica nei suoi modelli statistici, il machine learning necessita di una riduzione delle categorie e delle etichette che sono presenti inizialmente nei dataset. Con la tecnica della riduzione della dimensionalità, le categorie che mostrano bassa varianza (cioè i cui valori oscillano solo di poco) vengono accorpate ed eliminate per ridurre i costi di calcolo. La riduzione dimensionale, quindi, porta a qualcosa che può essere definito riduzione delle categorie, che comporta anche il restringimento delle tassonomie culturali.
In sostanza il machine learning opera un effetto di normalizzazione delle diversità, ovvero un processo di livellamento delle anomalie verso un valore medio. Il termine tecnico regressione si riferisce effettivamente al fenomeno di regressione verso la media che Francis Galton ha osservato misurando l’altezza delle persone. Le reti neurali per il riconoscimento facciale, per esempio, mostrano la tendenza a favorire immagini di persone con la pelle chiara. La regressione verso la media non è quindi solamente una tecnica matematica del machine learning, ma ha delle chiare conseguenze sociali e implicazioni politiche.
Come osserva opportunamente Dan McQuillian: «non esiste intelligenza nell’intelligenza artificiale, né questa impara veramente, anche se il suo nome tecnico è machine learning; si tratta semplicemente di minimizzazione matematica» . È importante ricordare che l’intelligenza del machine learning non deriva dall’applicazione di formule esatte di analisi matematica ma da algoritmi di approssimazione, cioè da procedure euristiche. La forma della funzione correlativa tra un input x e un output y è calcolata algoritmicamente passo dopo passo attraverso complicati processi meccanici di adattamento graduale. È la stessa procedura utilizzata nella geometria differenziale o nel calcolo, in cui piccoli blocchi quadrati vengono usati per approssimare un’area irregolare, invece di disegnare una forma curvilinea esatta. Si dice che le reti neurali siano tra gli algoritmi più efficienti per l’apprendimento perché questi metodi differenziali di approssimazione consentono di indovinare qualsiasi funzione, dato un numero sufficiente di strati di neuroni e tempo di elaborazione dei dati (come dimostrato dal cosiddetto teorema di approssimazione universale). Quando si afferma che «le reti neurali possono risolvere qualsiasi problema», si intende che possono approssimare la forma di qualsiasi curva (una qualsiasi funzione non lineare) in uno spazio di dati multidimensionale .
L’approssimazione graduale e brutale di una funzione è la caratteristica fondamentale dell’AI odierna, e solo da questa prospettiva si possono comprendere le sue potenzialità e i suoi limiti. Un altro problema del machine learning riguarda il modo in cui la correlazione statistica tra due elementi viene utilizzata per spiegare la causalità logica che li lega. Nella grammatica degli errori dell’AI questo non è uno sbaglio attribuibile alla macchina, ma a una fallacia umana. Si ritiene comunemente che la correlazione non implichi causalità, il che significa che una correlazione statistica non è sufficiente a dimostrare la causalità. Questa fallacia logica può facilmente diventare una fallacia politica.
L’illusione di causalità può essere utilizzata, ad esempio, per avallare gli algoritmi di polizia predittiva. Quando il machine learning viene applicato alla società in questo modo, le correlazioni predittive si trasformano in un apparato politico di preemption. Dan McQuillan afferma: «La natura predittiva del machine learning promuove la preemption, ovvero l’azione che cerca di anticipare o prevenire l’esito previsto» . La preemption, in quanto automazione del processo decisionale, contribuisce all’esclusione della partecipazione collettiva dalle istituzioni sociali e politiche. Il machine learning potrebbe persino supportare correlazioni arbitrarie e insensate (per esempio tra il consumo quotidiano di formaggio, l’etnia e il credit score, si può sempre trovare una correlazione statistica). Questo è ciò che viene chiamato apofenia algoritmica: la consolidazione illusoria di correlazioni o relazioni causali che non esistono nel mondo materiale, ma solo nella mente dell’AI .
Un altro limite logico fondamentale del machine learning è la sua incapacità di prevedere e riconoscere una nuova anomalia unica, ovvero un’anomalia che appare solo una volta, come per esempio, una nuova metafora nella poesia, una nuova battuta del linguaggio quotidiano o un oggetto misterioso in mezzo alla strada. I sistemi di AI basati su algoritmi di riconoscimento vocale, ad esempio, incontrano spesso difficoltà nell'interagire con i dialetti locali. Ancora più problematico è il fatto che le minoranze sociali tendano a rimanere escluse dalla logistica dell’AI (per esempio le persone con accento scozzese, che faticano a essere comprese da Alexa, o le comunità di persone nere che vengono ignorate nei sistemi di consegna Amazon) . L’inavvertibilità del nuovo (di qualcosa di inaspettato, che non è mai stato “visto” prima da una macchina e quindi non classificato in una categoria nota) è un problema particolarmente pericoloso per le auto a guida autonoma, che hanno già causato incidenti mortali proprio a causa di questo. Gli adversarial attack sfruttano queste zone cieche del machine learning, utilizzando pattern perturbanti che ostacolano la lettura visiva dell’ambiente da parte della macchina: questi pattern sono talvolta progettati da una mente umana consapevole che una “mente” dell’AI non li ha mai visti.
Nel machine learning il problema della previsione del nuovo è logicamente correlato al problema della generazione del nuovo. È interessante notare come la definizione logica di un problema di sicurezza descriva anche il limite logico della creatività nel machine learning. La domanda “L’AI può fare arte?” dovrebbe essere riformulata in termini tecnici: l’AI può creare opere che non siano imitazioni del passato? È in grado di estrapolare oltre i confini stilistici dei dataset? La risposta è: non proprio. La “creatività” del machine learning è limitata alla rilevazione di vecchi stili presenti nei dataset e alla successiva improvvisazione casuale aderente a questi stili. In altre parole: il machine learning può esplorare e improvvisare solo entro i confini delle categorie stabilite dai dataset. Le opere d’arte del collettivo Obvious (nomen est omen) – un progetto collaborativo che crea dipinti utilizzando l’AI – forniscono delle prove visive di queste limitazioni. Lo stile dei loro ritratti è fortemente normato ed esteticamente prevedibile . Sarebbe pertanto più accurato definire l’arte dell’AI come arte statistica.
In termini di elaborazione del linguaggio naturale, ci si può chiedere se l’AI sia in grado di inventare nuove metafore in modo coerente e non casuale. In un’epoca precedente all’avvento del machine learning, quando gli fu chiesto se un algoritmo potesse inventare una metafora, Umberto Eco rispose: «Non esiste algoritmo per la metafora: essa non può essere prescritta per via di istruzioni precise a un computer, indipendentemente dal volume di informazione organizzata che vi si può introdurre» . Qualsiasi nuova metafora rompe una regola e ne inventa una nuova, sosteneva Eco. Un algoritmo può essere programmato per infrangere in modo creativo le regole (pattern) dei suoi dataset? Il machine learning non sarà mai in grado di rilevare o generare la famosa frase di Rimbaud “Io è un altro” dopo aver eseguito l’analisi statistica di un milione di giornali. Il machine learning non inventa mai codici e mondi, ma piuttosto traccia spazi vettoriali che riproducono le frequenze statistiche di dati passati. Nella statistica computazionale, una nuova metafora è un nuovo vettore senza somiglianze di frequenza con i vecchi vettori; qualcosa che svanirebbe facilmente nel passaggio computazionale successivo. Inoltre, una metafora non è la correlazione statistica di due significati, ma la costruzione di un nuovo modello di mondo in cui questa nuova espressione acquisterebbe un senso logico (una causalità) che non aveva nel vecchio modello di mondo. Una nuova metafora è l’invenzione di un paradigma costitutivo. Spesso le metafore sono banali, ma a volte possono essere brillanti e aperte, come quando lasciano spazio per infinite interpretazioni, un processo fondamentale per le scienze umane e non solo. Ci si chiede chi sogni di meccanizzare l’ermeneutica, l’arte dell’interpretazione e del giudizio estetico; processi che devono rimanere liberi da vincoli. Tuttavia, l’arte dell’interpretazione può essere arricchita e ampliata, naturalmente, da nuovi strumenti di esaltazione logica ed esplorazione di pattern.
Qualsiasi anomalia (anche sociale e politica) è l’invenzione di un nuovo codice o di una nuova regola. D’altra parte, il potere si basa spesso sulla normalizzazione di codici e regole, che cercano di minimizzare l’insorgenza dell’anomalo. Il machine learning non fa eccezione quando viene applicato alla misurazione e all’amministrazione della società. Si veda, per esempio, l’esperimento di word embedding condotto da Bolukbasi et al., che ha utilizzato Word2vec come modello statistico pre-addestrato per analizzare i post di Google News come dataset. Quando all’algoritmo è stata chiesta la risoluzione dell’equazione «l’uomo è programmatore informatico come la donna è a x», ha risposto in modo problematico con con x = ‘casalinga’, evidenziando l’effetto dell’AI nel rinforzare gli stereotipi . Le diversità sociali e culturali scompaiono facilmente nel machine learning, poiché gli algoritmi non possono esprimere profondità semantica, a meno che non diventino lenti e inefficaci . L’AI rappresenta un mondo sempre più standardizzato, in cui le norme istituzionali e sociali tradizionali vengono tradotte e ulteriormente amplificate in nuove norme statistiche e computazionali .
In questo saggio ho tentato di osservare i limiti che influenzano l’AI come tecnica matematica e culturale, sottolineando il ruolo dell’errore nella definizione dell’intelligenza in generale. Ho costruito un indice provvisorio di limiti, approssimazioni, bias, errori, fallacie e vulnerabilità del machine learning. Ho descritto il machine learning come composto da tre parti: dataset, algoritmo statistico e applicazione del modello (come classificazione o previsione). Ho quindi distinto tre tipi di bias: bias del mondo, bias dei dati e bias algoritmico. Ho sostenuto che i limiti logici dei modelli statistici producono o amplificano i bias (che spesso sono già presenti nei dataset) e causano errori nella classificazione e nella previsione. Tuttavia, quando una correlazione statistica tra numeri all’interno di un dataset viene accettata come causalità tra entità reali nel mondo, non si tratta di un problema della macchina, ma di una fallacia politica. Il grado di compressione delle informazioni da parte dei modelli statistici utilizzati nel machine learning causa una perdita di informazioni anche rispetto alla granulosità delle categorie e delle tassonomie, con conseguente perdita di diversità sociale e culturale. Il limite ultimo dei modelli di AI si ritrova nella loro incapacità di rilevare e prevedere un’anomalia unica, come una metafora nel linguaggio naturale. Per la stessa ragione, i sistemi di AI sono anche vulnerabili ad adversarial attack che possono essere lanciati da un operatore esterno consapevole delle regioni deboli di un modello statistico. In ultima analisi, l’effetto principale del machine learning sulla società nel suo complesso è la normalizzazione culturale e sociale. L’AI corporativa estende il potere normativo delle precedenti istituzioni del sapere nei nuovi apparati computazionali. La normatività distorta dell’AI deriva dai limiti logici della modellazione statistica; una tecnica che è venerata in modo imbarazzante, come un totem animistico della coscienza sovrumana.
[Testo originariamente pubblicato in AI & Conflicts. Volume 2, a cura di Daniela Cotimbo, Francesco D'Abbraccio e Andrea Facchetti. Brescia: Krisis Publishing, 2025. Titolo originale: “How a Machine Learns and Fails – A Grammar of Error for Artificial Intelligence”, Spheres. Journal for Digital Cultures #5: Spectres of AI (2019)]