Sono passati quasi quattro anni dalla pubblicazione di AI & Conflicts. Volume 1. Quando abbiamo iniziato a lavorarci, avevamo chiaro in mente che curare una pubblicazione sul tema era di per sé problematico: mentre cercavamo i contributi e contattavamo gli autori, lavoravamo all’editing delle traduzioni, controllavamo i layout e andavamo in tipografia, l’industria AI stava un’altra volta cambiando faccia. Il libro andava in stampa, e OpenAI rilasciava CLIP, che avrebbe fornito le basi per i grandi modelli (LM) di nuova generazione. Di lì a un anno sarebbero usciti i LM di largo consumo più popolari, tra cui ChatGPT, Stable Diffusion e Midjourney, e le persone non specializzate avrebbero finalmente avuto accesso alla tecnologia. Ovviamente, con l’evolversi dell’industria anche alcuni dei conflitti che erano descritti nel libro si sarebbero riconfigurati: la ricezione, la rappresentazione e il dibattito intorno al tema stavano evolvendosi alla velocità con cui le comunità familiarizzavano con l’interfaccia di ChatGPT.
All’epoca non sapevamo precisamente quale direzione avrebbe preso la tecnologia, ma sapevamo che sarebbe cambiata in fretta. Ci è sembrato sensato aggiungere al titolo l’indicazione “Volume 1”, per lasciar intendere che pensavamo AI&C come un progetto più ampio del libro, ma anche per chiarire che il testo non pretendeva di offrire un punto di vista permanente, che sarebbe stato inevitabile aggiornare la discussione. Quello che invece certo non immaginavamo era la velocità con cui l’AI sarebbe definitivamente emersa tra le forza trasformative del XXI secolo, giocando un ruolo cruciale nel ridefinire le nostre società, economie e culture. Tutto è successo molto in fretta, al punto che le comunità non hanno avuto il tempo di sviluppare ed elaborare parole e immagini adeguate per descrivere le loro relazioni con la “nuova” macchina. Il nostro set di metafore è rimasto lo stesso non solo dal 2016, ma più o meno dai tempi del Golem di Praga. In sostanza, un simile scenario è il sogno di ogni agenzia di marketing: un prodotto complesso, dai contorni sfocati, che affascina l’immaginazione dell* utenti a un livello molto profondo. Così, mentre la maggior parte delle persone ha iniziato a integrare gli strumenti di machine learning nei propri processi di lavoro - e nelle proprie routine quotidiane - in pochi hanno ad oggi una nozione approfondita di come funzionano davvero queste tecnologie, che d’altra parte nascondono stratificazioni e nidificazioni di modelli, dati e algoritmi vasti e molto complessi. Alcuni dei testi in questo volume provano a restituire dei piccoli scorci che mostrano quanto estesa e spesso problematica sia l’anatomia dei (grandi) sistemi AI. Riposizionare queste tecnologie, spesso raccontate come "aliene" o "sovrumane", all'interno di vecchi processi e sistemi di conoscenza può aiutare ad abbandonare un’immagine mistificata dell’intelligenza artificiale, per cercare parole nuove, un vocabolario condiviso e un terreno fertile per una discussione partecipata.
Anche nel redigere questo secondo volume, curato a sei mani con Daniela, ci troviamo in uno scenario di cambiamento. Di nuovo, non riusciamo a immaginare quali dinamiche saranno in gioco tra quattro anni. Ma, ancora, se osserviamo su una scala più ampia la tecnologia e i suoi usi, molti dei conflitti che sono coinvolti nei processi sembrano rafforzare equilibri e battaglie preesistenti, spesso secolari.
Alcune delle frizioni che costellano il “campo di battaglia” dell’ecologia AI di oggi sembrano risuonare ad esempio con il periodo in cui Internet, alla fine degli anni '90, ha rivoluzionato la comunicazione, il design, il commercio e infine le società, ponendo questioni fondamentali sull'accesso, la privacy e la democratizzazione delle informazioni. Già allora il dibattito verteva sull'uso commerciale di Internet e sul digital divide, ed evidenziava disparità significative nell'accesso globale alle risorse. In questi trent’anni, gran parte dei contenuti che hanno popolato Internet è diventata un enorme giacimento di dati. Questi vengono oggi raccolti e utilizzati da organizzazioni private per costruire archivi digitali che servono da base per addestrare i LM. L’espressione di Holly Herndon e Matt Dryhurst secondo cui “all media is training data” non inquadra solamente un processo che trasforma qualsiasi cosa che esiste in “dato”, una risorsa alla mercé dei tentacolari processi di estrazione che alimentano l’industria dei big data. La datificazione dell’esistente sembra anche estendere la nozione deleuziana di “dividuale” oltre all’individuo, applicandola virtualmente a qualsiasi cosa .
Il processo di trasformazione delle infrastrutture web in "carburante" per i sistemi statistici avanzati riproduce anzitutto le problematiche esistenti, trasferendole direttamente nei modelli addestrati su quei dati. Tali modelli tendono a diffondere le nostre contraddizioni e i nostri bias. Ma il nuovo paradigma non si limita ad accelerare processi in atto: del resto siamo in giorni in cui nuovi poteri si affacciano sulla scena, tra insediamenti, saluti autistici e raffiche di decreti-lampo. L'AI oggi si configura come una tecnologia estrattiva che ridefinisce il nostro approccio a dati e archivi (ma anche a qualsiasi forma di espressione tipicamente umana: testi, immagini, suoni, ecc.), spesso ribaltando le dinamiche di potere in materia di lavoro, rappresentanza e diversità, autorialità e appropriazione. Prendiamo l'esempio delle questioni legate al diritto d'autore: se negli anni '90 un'intera generazione di artist* e professionist* percepiva il copyright come uno strumento al servizio dell'establishment, interessato a mantenere il controllo sulla distribuzione della cultura, oggi creator e artist* digitali vedono nella natura estrattiva dell'AI una minaccia diretta alle loro pratiche. L'informazione, la cui libera circolazione sul web rappresentava inizialmente un’anomalia nel sistema distributivo, alimenta oggi una delle più fiorenti (e meno eque) industrie estrattive del nuovo millennio, in espansione planetaria. Il sogno pirata di una cultura libera dalle restrizioni proprietarie del diritto d'autore assume ora per illustrator*, designer e copywriter i tratti di un incubo distopico, in cui inquietanti corporation risucchiano le competenze dell* lavorator* precar* per svenderle a pochi euro. Per capire le allucinogene contraddizioni di oggi, forse, è utile osservare le condizioni che le hanno prodotte: rivolgere lo sguardo verso i modi in cui l'industria ha progressivamente compreso le condizioni attraverso cui estrarre valore dalla circolazione della cultura online, regolamentando e codificando prima, per poi violare qualunque norma precedente dopo l'esplosiva affermazione del deep learning a partire dal 2014.
Per questo motivo, proviamo a ricostruire una mappatura delle frizioni e individuare possibili nodi di resistenza. In questo volume, il tentativo è quello di osservare i conflitti contemporanei alla luce di altri che vi risuonano. Così, tornando all'esempio citato poc’anzi, per comprendere criticamente l'emergere negli ultimi due anni delle pratiche del data poisoning può essere utile metterle in dialogo con l'approccio anti-individualista dei multiple name degli anni '90, della cultura delle distribuzioni indipendenti, del plagiarismo e delle pratiche della net.art. Queste “antiche” traiettorie di resistenza – come cerca di mostrare nel suo testo Domenico Quaranta – ci possono aiutare ad inquadrare in una prospettiva diversa un modello di autorialità già di per sé problematico, per osservare il contesto attuale con uno sguardo nuovo: uno sguardo che anziché limitarsi alla pur legittima tutela del nostro interesse individuale provi a ri-configurare le lotte dentro a contesti culturali più equi e attenti, ma anche più orientati a una dimensione collettiva e transpersonale.
AI & Conflicts 2 non è un libro sulla tecnologia; è un libro sul potere, lo sfruttamento e le strategie di resistenza nella cosiddetta "estate dell'AI". I tre capitoli del volume sono costruiti intorno ad alcune prospettive diverse, spesso sovrapposte e in relazione tra loro. Ciascuna di esse tenta di inquadrare l'intelligenza artificiale a partire da differenti lenti disciplinari, e propone una prospettiva multidimensionale sulla tecnologia.
La prima prospettiva fa riferimento alla dimensione politica di queste tecnologie e in generale a una serie di traiettorie che riguardano le politiche dei media, della rappresentazione, dei dati, della conoscenza. In molti dei testi proposti ciò si concretizza nel tentativo di decostruire e demistificare la narrazione aziendale e celebrativa con cui oggi una serie di tecnologie, e di processi mediati da queste, vengono presentati e venduti sotto il nome di Intelligenza Artificiale. Questi contributi si concentrano sulla tecnologia in senso stretto, analizzando l’anatomia delle reti neurali e le problematiche inerenti alle condizioni che le hanno prodotte. L'obiettivo è smontare quello che a tutti gli effetti è il mito dell’AI, una narrazione che sfrutta la natura complessa e stratificata di queste tecnologie – e delle infrastrutture che le supportano – per presentarle come entità magiche o aliene, in grado di svolgere in un batter d’occhio compiti complicati e di muoversi su di un piano indipendente da quello terreno e umano.
Analizzare l’anatomia dei dataset e il funzionamento dei modelli di machine learning ci aiuta a scorgere il modo in cui i flussi di informazione vengono rifratti, distorti e alterati da quei modelli. Uno dei possibili risultati di questa prima operazione critica è l’allegoria del nooscopio descritta da Pasquinelli. Il nooscopio inquadra l'AI come dispositivo di magnificazione che visualizza i pattern e le ricorrenze in grosse architetture di dati. Lontana dal formulare un “pensiero” autonomo, la macchina opera in modo simile a un microscopio sui dati presenti nell’archivio. Pertanto, gli output dell'AI riflettono i dati di addestramento piuttosto che una comprensione delle richieste dell'utente (un pericoloso equivoco, questo, all'origine dei bad trip allucinogeni descritti nel testo di Salvaggio). La qualità, la rilevanza e la diversità di questi archivi incidono direttamente sulla capacità della macchina di generare output accurati e pertinenti.
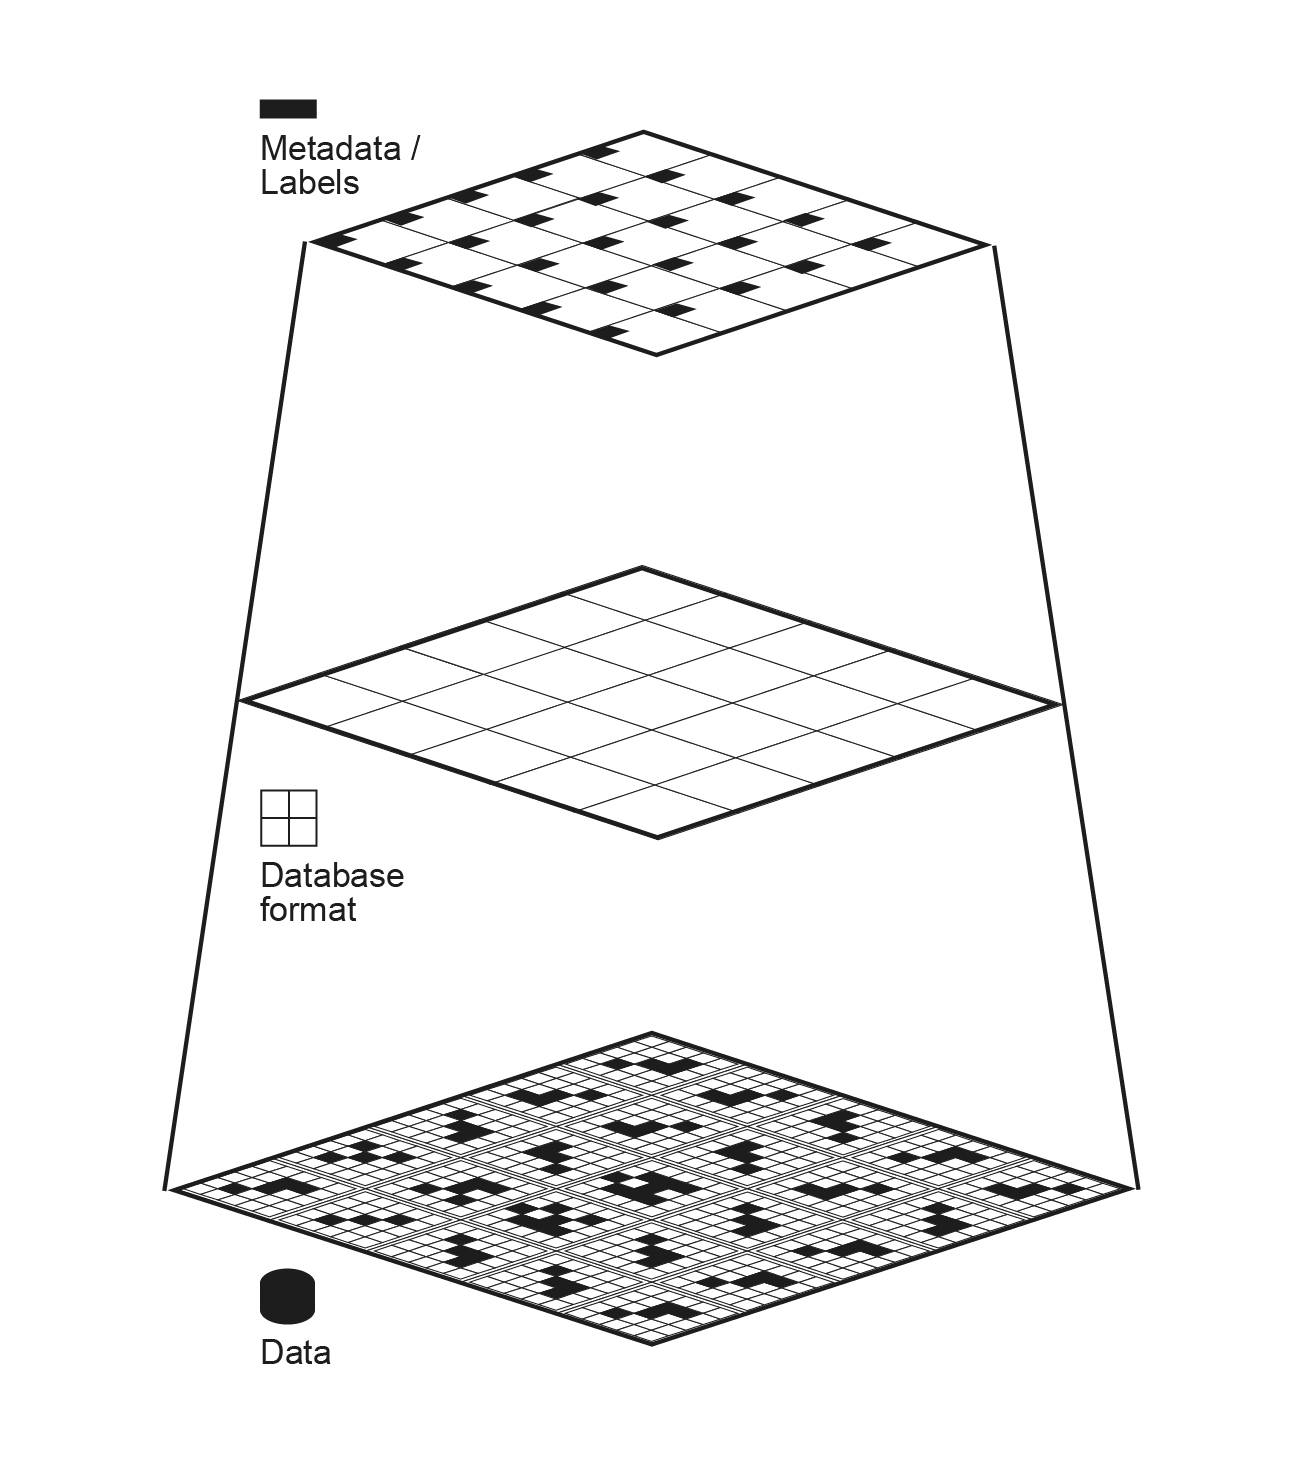
Le problematiche legate ai grandi dataset "fondamentali" (come LAION-5B, descritto da Buschek e Thorp) sono molteplici. Si estendono oltre le sfide tecniche per includere dimensioni e questioni etiche, sociali e politiche, e aprire quindi l’analisi critica dei conflitti dell’AI ai suoi dintorni. I modelli di machine learning possono infatti perpetuare i pregiudizi che i dataset di addestramento trasferiscono dai contesti in cui questi vengono creati, generando output che amplificano e naturalizzano tali pregiudizi. Da qui la domanda intorno alla costruzione e alla cura dei dataset. Una domanda che chiama in causa la necessità di aprire a una pluralità di approcci, per produrre dataset più inclusivi e meno schiacciati sui valori medi. In questo senso, un'altra questione significativa è la sistematica svalutazione dei gruppi sottorappresentati nella ricerca, che rafforza gli squilibri di potere esistenti nel campo. Le prospettive femministe, e in particolare del femminismo intersezionale adottato da Klein e D’Ignazio nel loro testo, diventano dunque un framework di riferimento per gli studi sull'AI, evidenziando la necessità di team di sviluppo diversificati e inclusivi, oltre all'importanza di interrogare e sfidare i pregiudizi di genere incorporati in queste tecnologie.
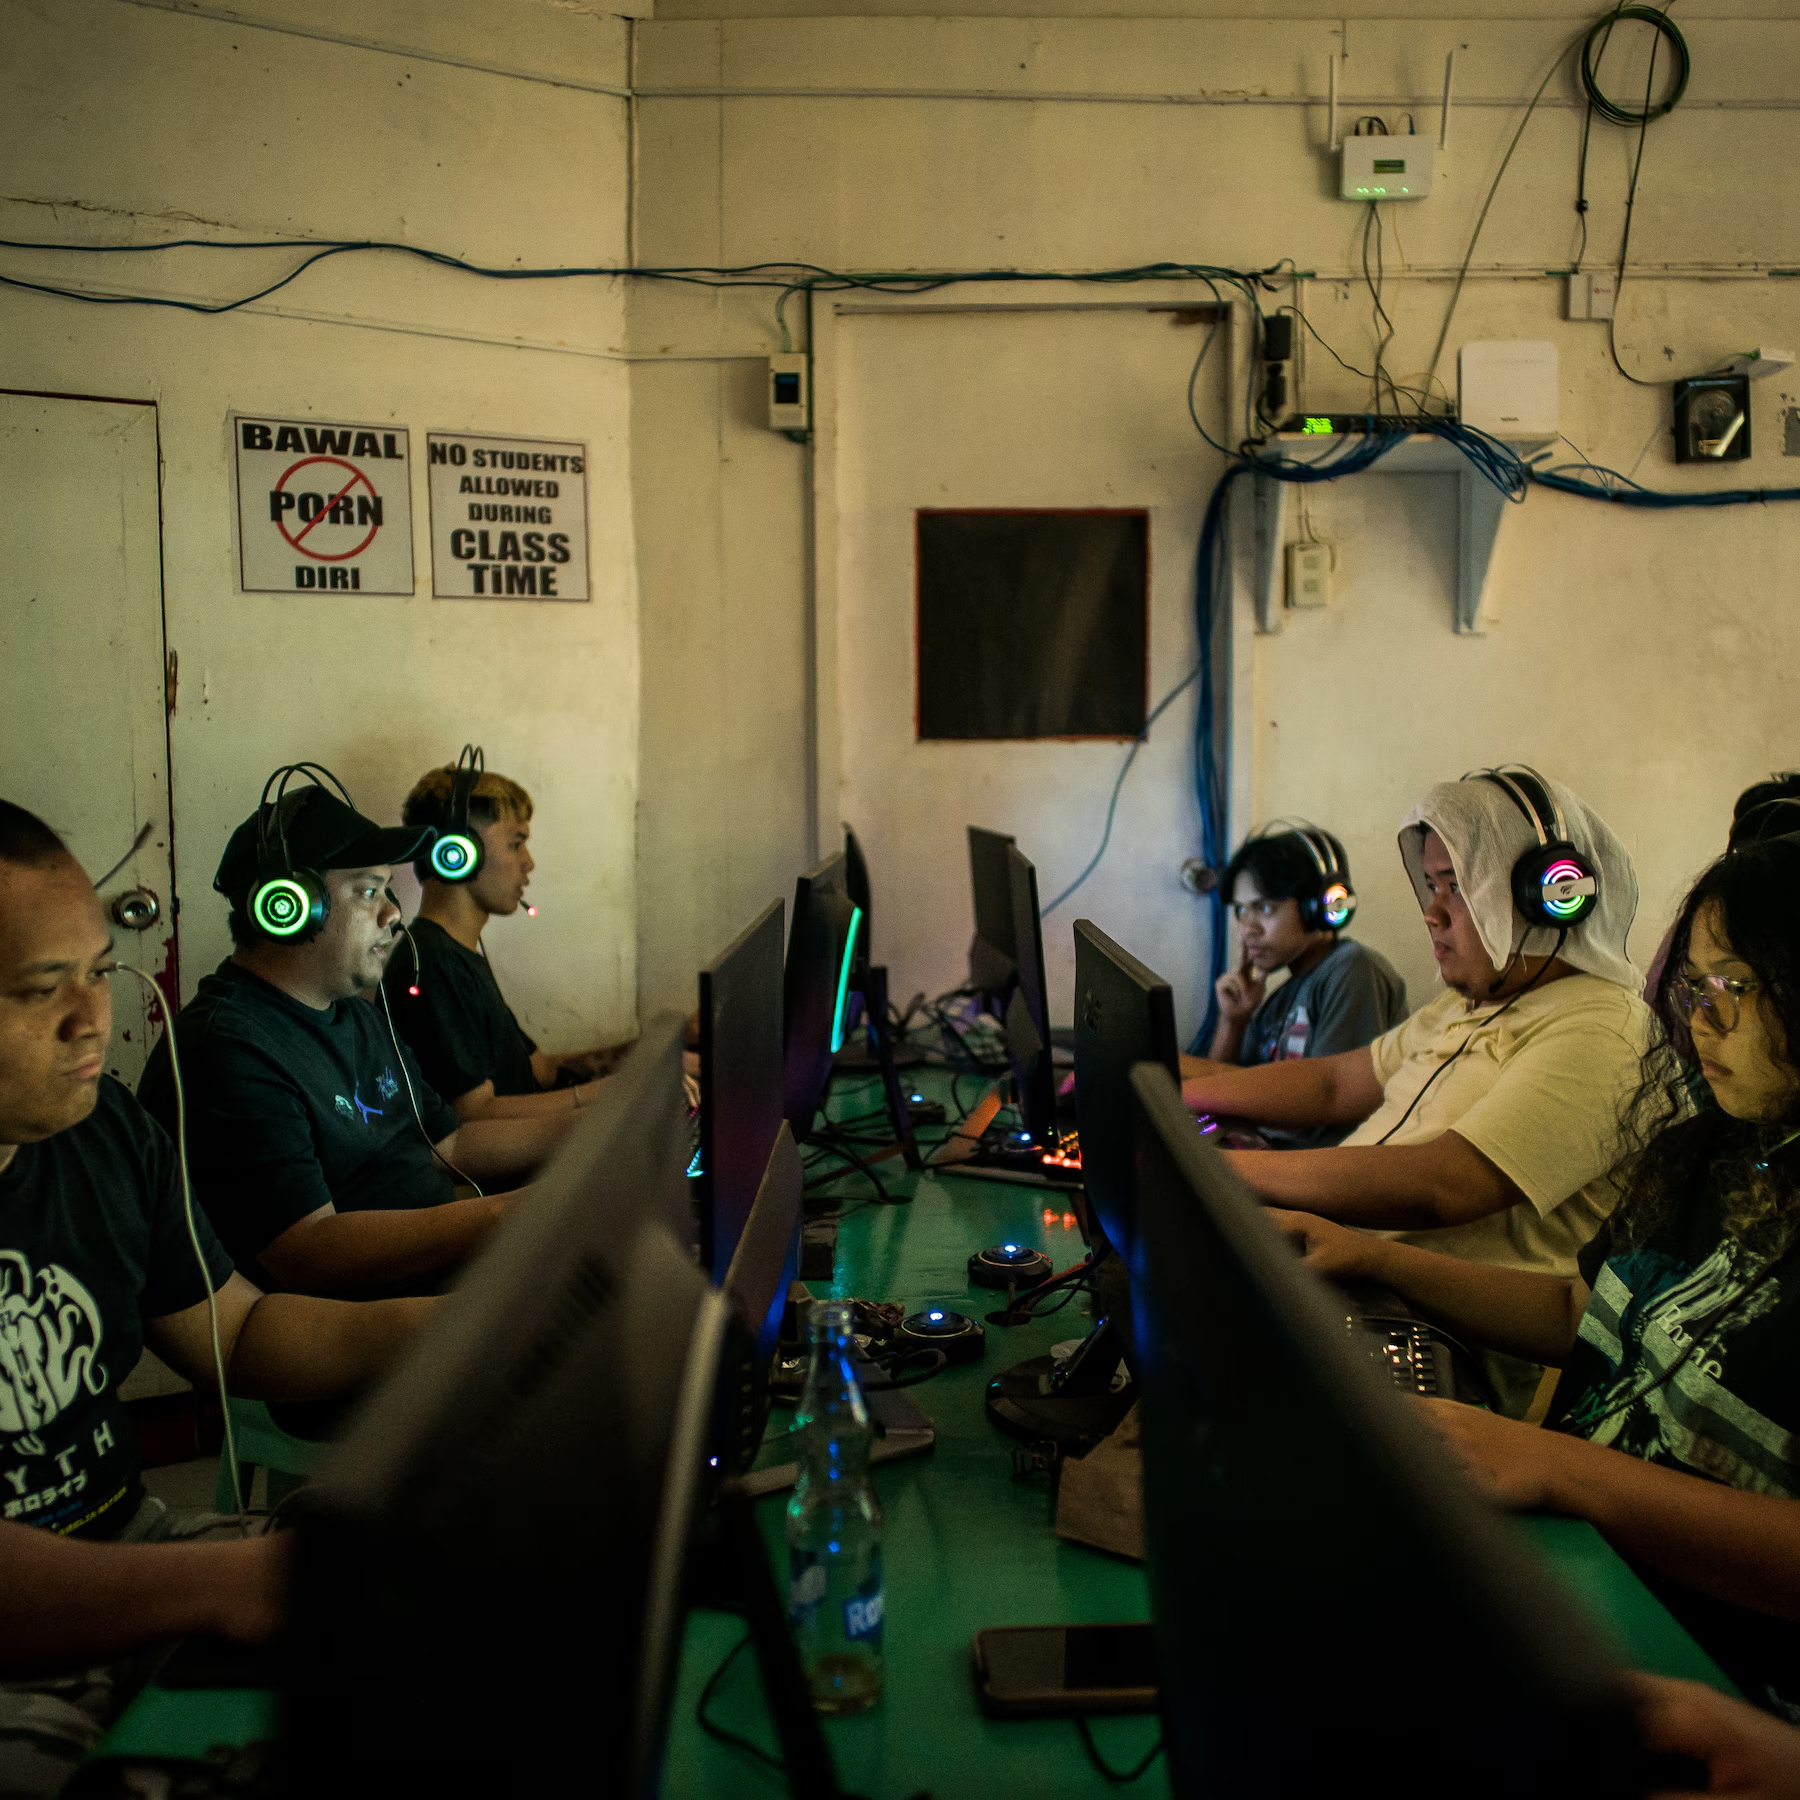
D’altra parte, porre l’attenzione sui set di addestramento dei modelli di machine learning introduce un altro filone di indagine, quello delle politiche dei dati. Alcuni dei testi raccolti in questo libro ricostruiscono le radici colonialiste, capitalistiche e patriarcali dei modelli AI, facendo crollare il mito della loro neutralità e mostrandone la profonda interdipendenza con le strutture del potere – un potere che storicamente si manifesta sia a livello epistemico, come ad esempio nella tassonomia linneana, che a livello geopolitico ed economico, come mostrano le “imprese” della Compagnia olandese delle Indie Orientali descritte da Dzodan. Altri contributi contestualizzano le politiche dei dati nel presente, mostrando il retaggio di quelle matrici colonialiste. Non è un caso che i lavori di etichettatura dei dati, poco remunerati e psicologicamente gravosi, vengano frequentemente esternalizzati a individui economicamente vulnerabili del Sud Globale. Questa forma di sfruttamento del lavoro digitale replica le dinamiche proprie delle pratiche coloniali, in cui risorse e manodopera venivano estratte dalle regioni colonizzate a beneficio dei colonizzatori.
C’è infine un altro aspetto che emerge da questo quadro, quello dell’epistemologia visiva e del cambiamento che le immagini sintetiche generate dalle tecnologie AI portano con sé. Il primo volume era già animato da una certa preoccupazione per l’inadeguatezza delle teorie del pensiero critico occidentale rispetto alle sfide che le nuove tecnologie ponevano alla cultura visiva. I sistemi di machine learning e le loro infrastrutture di addestramento sembravano porre una serie di questioni che minavano lo status delle rappresentazioni. Dopo quattro anni alcune peculiarità e caratteristiche – preziosissime per capire le trasformazioni in atto nei rapporti tra produzione di immagini e produzione di conoscenza – hanno iniziato ad emergere e a mostrarsi in modo più chiaro.
La caratteristica principale che contraddistingue le immagini sintetiche da qualsiasi altro tipo di rappresentazione visiva è sicuramente la loro matrice statistica. A differenza della fotografia, queste non sono il prodotto di un dispositivo di cattura, che traduce e riproduce in modo mimetico una porzione di mondo. Quando l’immagine di un volto viene prodotta da un sistema generativo, ciò che osserviamo non è semplicemente il risultato di un processo di rappresentazione, ma l’output di una complessa rete di inferenze statistiche. Il modello esegue una serie di valutazioni probabilistiche, o previsioni, riguardo alle caratteristiche che meglio rispondono a un determinato input (es. un prompt testuale).
Il nuovo medium generato è una traduzione in immagine di una serie di caratteristiche che ricadono dentro la curva di probabilità descritta dal database di partenza. In questo senso parliamo allora di immagini sintetiche: non certo per riferirci alla loro natura artificiale (dato che non esistono immagini “non artificiali”), ma piuttosto al processo di sintesi (statistica) che accompagna la loro produzione. Non a caso Steyerl vede nei “composite portraits” di Galton – uno dei padri della statistica sociale e dell’eugenetica – un importante antecedente delle immagini che oggi generiamo attraverso i servizi di AI.
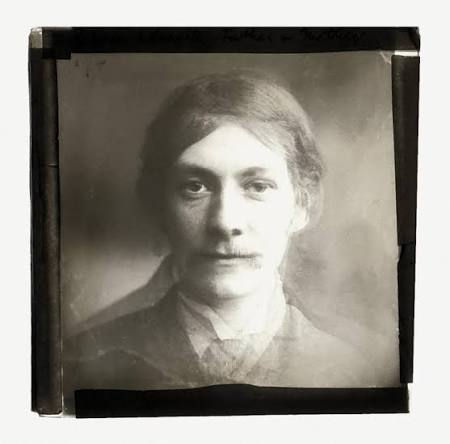
Questo processo ha delle conseguenze enormi per la cultura e l’epistemologia visiva – nonché per le politiche dei media, delle immagini e della conoscenza. Le immagini sintetiche portano a compimento un processo che nel corso del XX secolo le ha mano a mano allontanate dal loro referente esterno. Se la fotografia analogica “vantava” una certa prossimità con il reale (esiste un rapporto indessicale tra la luce e la pellicola), già la fotografia digitale iniziava a dilatare questa vicinanza, aggiungendo alcuni passaggi tecnici che complicavano il rapporto tra referente e rappresentazione. Le immagini sintetiche possono essere quindi concepite come l’ennesima evoluzione delle immagini tecniche descritte da Flusser, immagini che non sono più “observations of objects”, ma “computations of concepts” .
Abbandonato definitivamente qualsiasi referente esterno diretto, le immagini sintetiche mettono in discussione la dimensione probatoria delle rappresentazioni visive, cioè il loro presentarsi (o essere presentate) come evidenze fattuali. Tuttavia, ancora troppo spesso (in modo analogo ma complementare a quanto è accaduto con l’invenzione della fotografia nel XIX secolo) le immagini sintetiche vengono usate per rinforzare l’obsoleta dicotomia tra vero e falso. Se la fotografia fin dalle sue origini è stata raccontata come una tecnologia fedele alla realtà – ed è stata quindi elevata a ruolo di rappresentazione oggettiva del reale – le immagini sintetiche fotorealistiche prodotte dai sistemi AI si collocano su di una polarità opposta, per lo meno per quanto riguarda il loro valore epistemico. Esse sembrano infatti capaci di compiere il delitto perfetto del reale, producendo immagini tanto fedeli alla nostra percezione della realtà esterna, quanto completamente slegate dall’esistenza di un referente – da cui la loro estrema malleabilità rispetto a ciò che possono mostrare. Ma se le immagini sintetiche non sono più descrizioni del mondo, che tipo di conoscenza sono in grado di produrre? Che cosa ci dicono del mondo?
Come detto, esse non sono in grado di esprimere un giudizio di verità o di falsità. Se sono la prova di qualcosa, non lo sono certo dell’esistenza di una distinzione netta tra realtà e finzione – o meglio, tra rappresentazioni vere e false della realtà. Piuttosto, ci aiutano a capire i contorni di una nuova epistemologia visiva, a tracciare le condizioni di possibilità entro cui un certo modo di far vedere il mondo è in grado di produrre una specifica conoscenza di quel mondo. E questi contorni hanno molto a che fare con una comprensione probabilistica dei fenomeni sociali, e in generale con i principi della statistica morale. Ciò segna il passaggio da un’immagine concepita come traccia sensibile di un qualcosa che esiste o è successo “là fuori”, a un’immagine intesa come una composizione statistica che segue la distribuzione normale di una serie di dati. La conoscenza che si genera da queste immagini è allora una conoscenza mean, per usare la terminologia di Steyerl: è una conoscenza inscritta nel valore medio delle cose; una conoscenza che tiene conto solo di ciò che si concentra nella curva gaussiana e ignora in modo meschino (mean) tutto quello che vi rimane fuori. Una conoscenza profondamente determinata dalla casistica raccolta e catalogata dentro al dataset di addestramento. Solo ciò che si è già manifestato, e soprattutto che è stato documentato, classificato e tradotto in elemento del dataset, va a informare l’orizzonte cognitivo della macchina, definendo quindi il range di possibilità degli output di quel modello .
Osservare l'anatomia delle reti neurali e dei media che esse producono con la lente delle politiche della rappresentazione ci aiuta a inserire questi ultimi nel solco di una evoluzione dei dispositivi che operano sugli archivi. Le analogie tra le pratiche di montaggio e la generazione di contenuti tramite modelli di machine learning sono profonde e significative. Entrambi si basano sulla cura di archivi più o meno organizzati e operano attraverso processi di selezione, riconfigurazione e assemblaggio di frammenti. Condividono anche schemi estetici fondamentali, tra cui i concetti di giustapposizione, transizione e ri-significazione, oltre a una relazione unica con la temporalità .
Tuttavia, esistono differenze fondamentali tra i prodotti creati tramite ML e il montaggio "tradizionale" (analogico o digitale), che si manifestano in due aspetti chiave: gli strumenti utilizzati e gli output. Il montaggio guidato dall’AI utilizza un set di strumenti diverso rispetto a quello tradizionale. Invece di “taglia”, “incolla” e “copia”, gli strumenti dell’editor AI includono “interpolazione”, “estrapolazione”, “domain change”, ecc. Gli output di questi strumenti possono essere definiti come “deep remix” . I deep remix si differenziano radicalmente dai remix tradizionali. Mentre in questi ultimi i frammenti del medium originale rimangono presenti nell’output, anche se in forma distorta o alterata, nei deep remix le tracce dirette del medium scompaiono, lasciando spazio a una sintesi probabilistica delle caratteristiche.
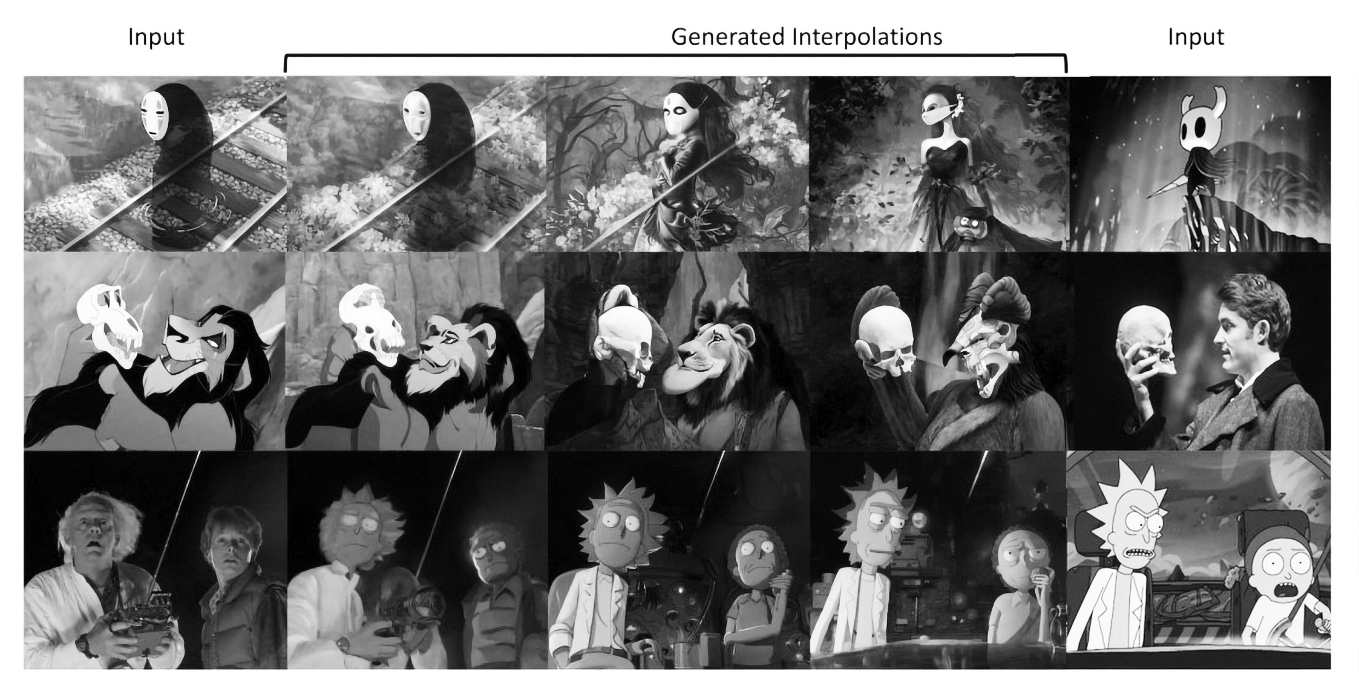
Questa dinamica operativa, situata nell’architettura dei modelli di deep learning, si basa come detto sull’analisi di pattern all’interno di vasti dataset. Ogni immagine prodotta non è un’entità preesistente, ma una costruzione emergente, risultato di una negoziazione probabilistica tra configurazioni possibili. In altre parole, la generazione di un volto non implica il recupero di un frammento specifico dal dataset, ma piuttosto la sintesi di un elenco esteso di caratteristiche (feature) incorporate in un punto individuale, o vettore, all’interno dello spazio latente definito dal modello.
Sebbene i modelli non replichino frammenti dei loro dataset in senso stretto, questi sono presenti in ogni possibile output. Alcuni dei progetti artistici raccolti in questo volume, che descriveremo più avanti, mostrano in modo chiaro questa correlazione. Quando si osservano media generati da modelli addestrati su dataset curati manualmente, la natura intertestuale dei deep remix diventa assolutamente centrale ed evidente. La nozione di intertestualità, qui intesa alla luce delle teorie di Timothy Morton, ampiamente discusse nel saggio Ecologia come Testo, Testo come Ecologia, ci aiuta dunque a inquadrare le modalità operative del ML in ambito estetico. Già all’inizio del secolo scorso, Ferdinand de Saussure mise in discussione l’idea del testo come entità isolata. Ogni testo è collegato ad altri testi, ed essi esistono a partire dalle loro relazioni: il loro valore viene costantemente rinegoziato alla luce di ciò che gli sta intorno .
Una volta chiarito il modo in cui i segni sono definiti dalle loro relazioni con il proprio con-testo, la decostruzione post-strutturalista di Derrida mostra che la divisione interno/esterno dei testi diventa insostenibile. La famosa espressione del filosofo francese, "il n'y a pas d’hors-texte” , enfatizza infatti l'idea che i testi sono costituiti ricorsivamente dalle loro relazioni, senza distinzioni rigide tra dentro e fuori, e che il processo di ricorsione è virtualmente infinito. La decostruzione e l'ecologia mortoniana sfumano definitivamente l'idea tradizionale di confine, che diviene qui intrinsecamente relazionale e permeabile. L'attività di produrre nuovi media (o testi), per Morton è “un processo differenziale”, attraverso cui essi esistono “in quanto tali, e anche come estranei a sé stessi. Il testo smantella le distinzioni tra un di dentro e un di fuori” . La dimensione frattale dell'ecologia dei testi risuona profondamente con la struttura degli spazi latenti dei sistemi ML — in cui le feature provenienti dagli oggetti dell'archivio popolano uno spazio multidimensionale e sostanzialmente analogico — e con i deep remix inferenziali che essi producono. Quando generiamo l'immagine della faccia nel bosco con StyleGan, esploriamo così gli interstizi tra gli oggetti del dataset, e osserviamo la permeabilità del confine tra l'immagine di un volto umano e quella di un bosco.
Analizzare la relazione tra remix e deep remix suggerisce che, piuttosto che concepire il machine learning come uno strumento generativo, dovremmo considerarlo come un dispositivo di ibridazione tra gli oggetti che popolano i dataset. La vastità dei LM tende a nascondere i limiti dell’orizzonte cognitivo della macchina e a produrre output che sembrano interamente “nuovi”, ma che al contrario emergono sempre da una ricostruzione semantica dell’archivio da cui attingono. Attraverso la lente statistica del nooscopio, l’operator* osserva ciò che si trova negli interstizi tra le cose, scoprendo correlazioni e visualizzando inferenze sui modi possibili per popolarli.
Lo scenario finora descritto sta sicuramente avendo un impatto significativo anche nel contesto della produzione artistica. Proprio l* artist* sembrano rispondere efficacemente agli impulsi che ne derivano, offrendo importanti spunti di riflessione, esempi di pratiche virtuose e strategie di resistenza. Non è un caso che proprio coloro che utilizzano questi strumenti in maniera disfunzionale e al di fuori dalle logiche della produzione di massa, misurandosi con i limiti e le opportunità, siano in grado di far esplodere i conflitti nascosti dentro alla black box dell’AI e di offrire traiettorie per risignificare i suoi processi e le narrazioni che la alimentano.
L’utilizzo del machine learning da parte dell* artist* risale alla metà degli anni ‘10 del Duemila, in contemporanea con lo sviluppo dei principali applicativi di intelligenza artificiale che hanno progressivamente permeato le nostre vite quotidiane. Tuttavia, è solo negli ultimi cinque anni che i grandi modelli lanciati sul mercato dalle big tech, con la duplice promessa di potenziare le prestazioni e rendere l’intelligenza artificiale accessibile a tutti, hanno trasformato in modo radicale non solo le modalità di accesso alla creazione artistica, ma anche le estetiche ad essa connesse. Come ci fa notare Rosemary Lee, tale tipologia di contenuti ci fa entrare nell’era della Data-Based Aesthetics, che come detto ci allontana da un’idea di rappresentazione mimetica della realtà. In base a questo principio sarebbe dunque interessante chiedersi quale ruolo occupa chi lavora con questo materiale sotto il profilo creativo.
Negli ultimi anni stiamo assistendo a un progressivo distacco tra chi produce immagini con sistemi ML e i dati utilizzati per i training. Se infatti l* artist* della generazione precedente addestravano le proprie reti neurali utilizzando dataset appositamente creati, oggi la vastità dei LM e il loro pre-addestramento rendono difficile avere una visione chiara di ciò che contengono. Molti dei principali dataset di addestramento, oltre a presentare problemi di rappresentatività a più livelli, includono contenuti appartenenti ad altr* autor* senza garantire loro un adeguato riconoscimento. Alcuni esempi virtuosi, come il dataset Public Domain 12M, hanno cercato di aggirare questo ostacolo includendo l* artist* che producono immagini nei sistemi di governance dei dati, e collezionando esclusivamente contenuti liberi da diritti. Eppure questi esperimenti rimangono piuttosto isolati e, al di là di tutto, si può comunque concludere che il grande problema in questo senso sia che i principali LM continuino a essere sviluppati da aziende proprietarie, le quali traggono profitto da attività che non garantiscono un adeguato riconoscimento per l’uso dei dati di addestramento. Un pattern ricorrente che ci spinge a riflettere più in profondità su come lo sviluppo di questi algoritmi sia spesso guidato da logiche di profitto, più che da una reale ricerca di utilità e progresso.
Sicuramente è importante notare come la natura stessa di questi strumenti mette profondamente in crisi la nozione tradizionale di autorialità aprendo a prospettive nuove e a una risignificazione di tale concetto. Questo ribaltamento di senso non è inedito: già nel 1967 Roland Barthes nel saggio La morte dell’autore aveva messo in discussione che la finalità di un’opera fosse definita dall’espressione della soggettività dell* su* autor* piuttosto che dalla ricezione dell* su* fruitor*. Il pericolo, come suggerisce Salvaggio in un testo recentemente pubblicato sul suo blog Cybernetic Forests , «è che con gli LLM, l’autor* non sia morto abbastanza» e che anzi si continui a trascurare la natura di ibridazione intertestuale dell’AI che abbiamo provato a descrivere sopra.
Il tema della rappresentazione rimane
centrale nelle opere dell* artist* che animano questa pubblicazione. Su questo
ad esempio lavora Minne Atairu in Blonde
Braids Study: volendo generare immagini di donne nere con trecce bionde,
l’artista si scontra con i limiti di Midjourney, il quale risponde alla
richiesta producendo sintografie di
donne nere con vistosi fiocchi gialli in testa al posto delle trecce. Nel
tentativo di rintracciare le cause di questo limite, Atairu scopre che
all’interno di LAION-5B, il dataset utilizzato per l’addestramento di
Midjourney, le immagini corrispondenti alla sua ricerca sono sottorappresentate
se non inesistenti. Il motivo di questa omissione è da rintracciarsi in una
forma di discriminazione culturale per cui ancora oggi una donna nera che
proponga un attributo artificiale come i capelli biondi e intrecciati
rappresenta un’eccezione alla “norma”, spesso perseguita anche da alcune
politiche sociali e lavorative, come dimostrano evidenti episodi di cronaca
[13]. Se accettiamo dunque di considerare la natura ambigua di queste immagini
come prodotto di medie/meschine in grado di generare tassonomie parziali e
incomplete, non possiamo che porci di fronte alla necessità di interrogare a
fondo le identità che ne derivano. Da questa presa di coscienza nasce xhairymutantx, una piattaforma per la
generazione di immagini realizzata da Holly Herndon e Mat Dryhurst all’interno
della quale l’immagine stereotipata di Herndon viene sovrarappresentata
attraverso l’inserimento nel dataset di una serie di contenuti fittizi e
”adversarial”, immagini esasperate della capigliatura della Herndon realizzate
mediante travestimenti e rudimentali effetti speciali. L’esasperazione di
questo immaginario fa sì che per ogni prompt inserito dall* utenti, la piattaforma
generi contenuti in cui ricorrono capelli rossi e lunghe trecce. Quest'opera ci
mostra i processi sotterranei che portano alla generazione dei contenuti,
ponendo l’accento sul processo di deresponsabilizzazione e di accettazione
passiva che implica l’utilizzo acritico di queste piattaforme.
Mettere in discussione questo paradigma vuol dire dunque demistificare gli immaginari culturali che lo hanno preceduto. Su questa traiettoria si inserisce ad esempio Leda Was a Swan, progetto di Marianna Simnett che si sviluppa su un doppio binario interpretativo: da un lato, decostruisce l’immaginario patriarcale legato al mito di Leda e il Cigno, che tradizionalmente raffigura la donna come vittima passiva della violenza di genere; dall’altro, mette in discussione le narrazioni lineari e le identità ipersessualizzate prodotte dall’intelligenza artificiale. Il risultato, frutto di un attento lavoro di cura del dataset in cui Simnett esclude le immagini stereotipate, è una narrazione fluida in cui Leda e il cigno si trasformano in forme simbiotiche, parti di un unico organismo desiderante. Con questo lavoro - non il primo realizzato grazie all’ausilio dell’AI - Simnett amplia lo sguardo computazionale, inserendolo in un immaginario narrativo più vasto, dove il mostruoso e il chimerico, l’inorganico e l’artificiale divengono forme di ibridazione e risignificazione in termini relazionali.
Decolonizzare l’immaginario ha anche a che fare con la ridefinizione di categorie culturali imposte da modelli tassonomici parziali e asimmetrici, come nel caso dei confini geopolitici. Ad esempio, il progetto The New Times Atlas of The World, di Agustina Woodgate, riflette sulle logiche coloniali della suddivisione arbitraria dei territori, prima cancellando con la carta vetrat confini nazionali, nomi di luoghi e altri marcatori politici dalle mappe, per creare una superficie astratta e muta. Queste immagini “vuote” vengono poi utilizzate per l’addestramento di un modello di machine learning in grado di crearne di nuove. ll risultato è una inedita visione del mondo che prova a superare la concezione coloniale della cartografia e diventa un terreno di esplorazione tra geografia fisica e rappresentazione concettuale.
Di chiaro stampo speculativo è invece il progetto Khawagaka, un’opera di world-building che immagina un sistema di insegnamenti antichi appartenenti alla cultura indigena Wusa. Il progetto nasce come una risposta alla caduta della civiltà Samasthamarta, avvenuta circa mille anni prima della sua formalizzazione scritta, e tenta di ricostruire la storia, la filosofia, e perfino la lingua Zufrasi attraverso le capacità combinatorie degli algoritmi. Questo progetto si inserisce in una serie di pratiche volte a intendere l’archivio come luogo di interconnessione tra dati e immaginari, andando così a colmare lo spazio interstiziale tra conoscenze acquisite e possibilità inesplorate.
Mettere in luce i processi che sottendono alla generazione di contenuti ha anche il preciso scopo di dimostrare l’irriducibilità dello sguardo macchinico a quello umano. Rendersi conto dello scarto tra la volontà che anima il processo e i suoi esiti effettivi è alla base di alcuni dei lavori che abbiamo raccolto. Per questo Anna Ridler, che da tempo si occupa di analizzare l’epistemologia tecnologica, in particolare in relazione al machine learning e ai suoi processi interni, lavora sui dataset mostrando la distanza tra la percezione umana e quella dell’AI. Synthetic Iris Dataset si rifà all’Iris Dataset degli anni 30’, ancora oggi utilizzato nell’apprendimento automatico per testare algoritmi di classificazione. L’artista ha generato diverse immagini di Iris, noto fiore di colorazione viola intenso, attraverso diversi generatori di immagini per poi chiedere ad un altro modello di leggere e classificare questi output, annotando manualmente i dati emersi in una serie di grafici. Questo ribaltamento sottolinea il modo in cui i sistemi tecnologici strutturano la nostra comprensione del mondo visivo e del linguaggio, e contemporaneamente svela l’irriducibile distanza tra la visione umana e quella macchinica.
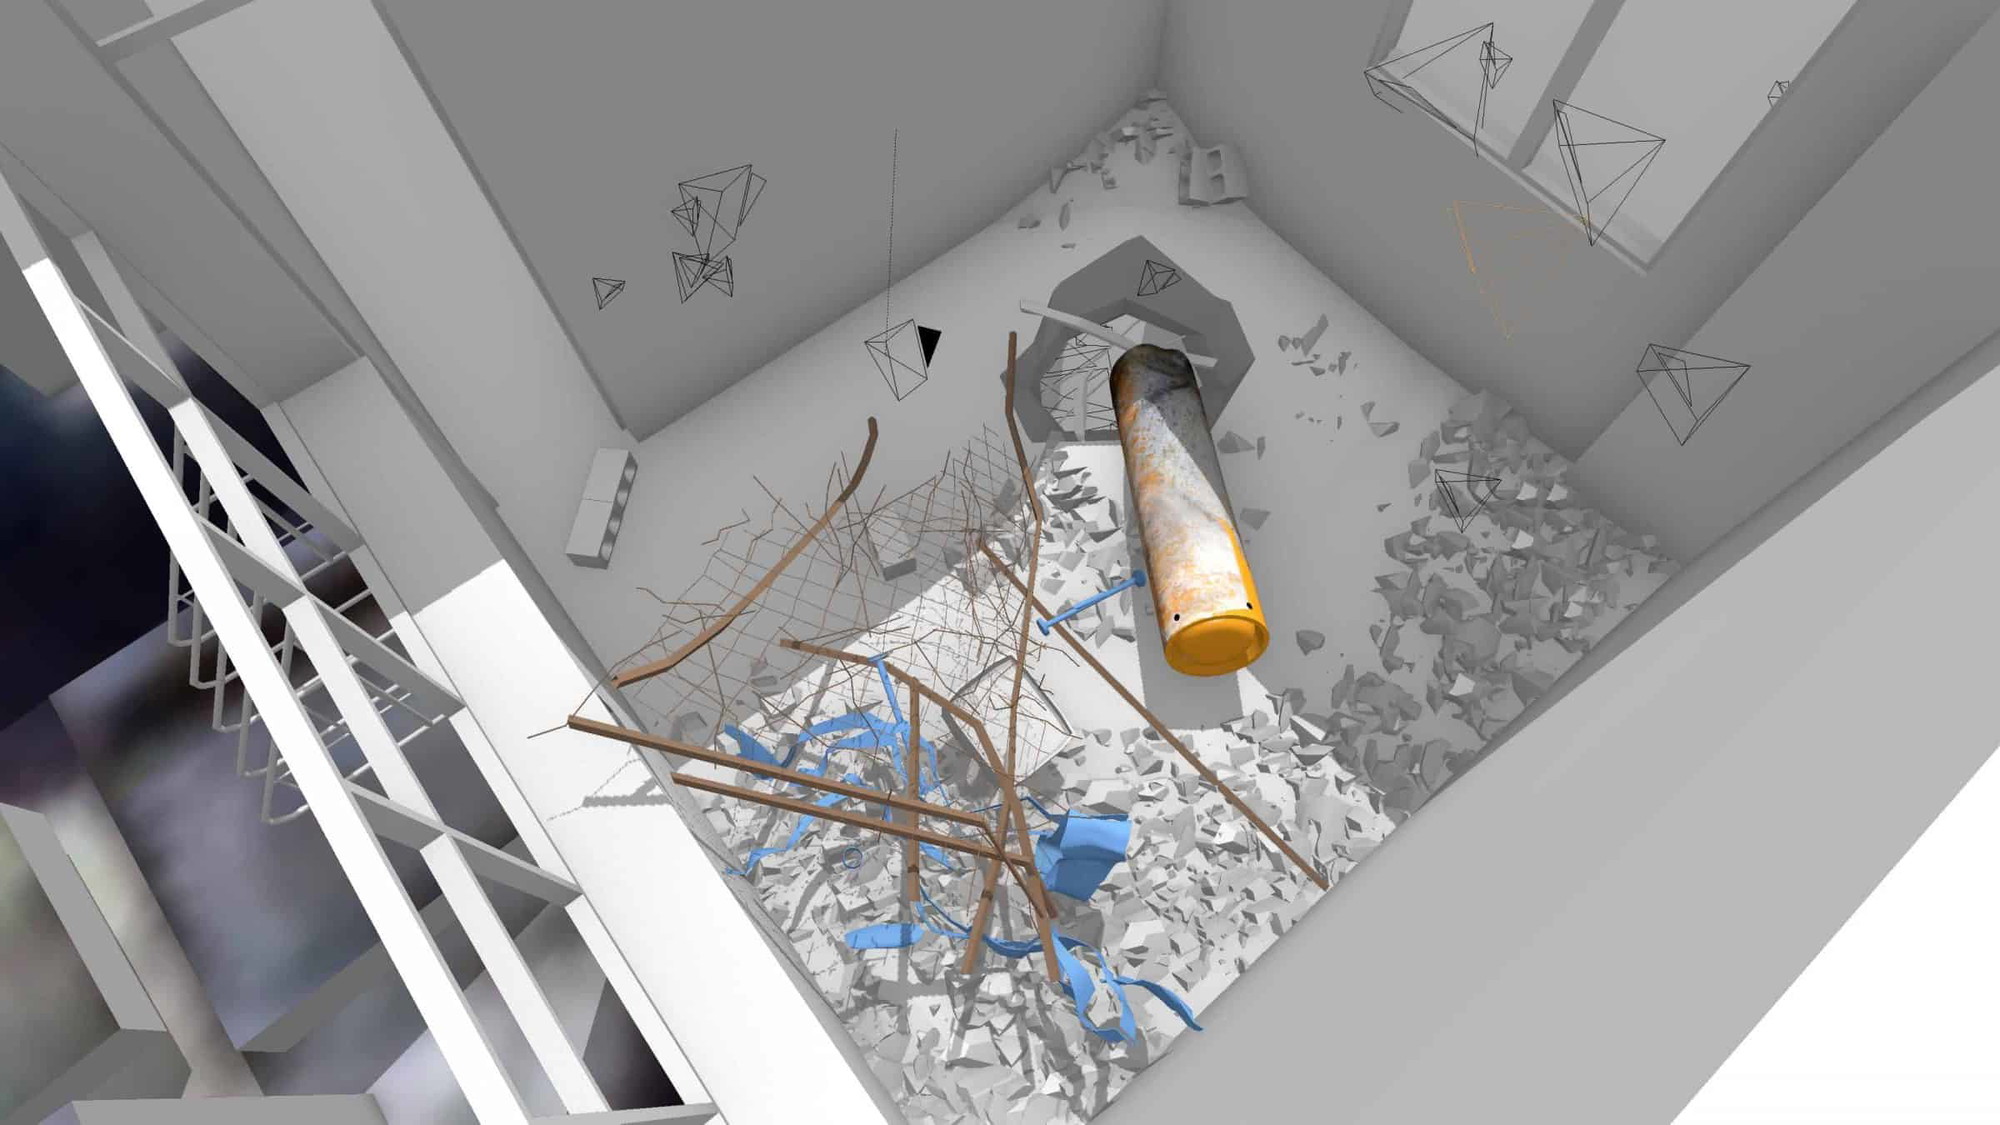
Questi costrutti algoritmici, come ci fa notare Flavia Dzodan in Lutto Aptico, non sono tuttavia prodotti neutri: agiscono sulla nostra affettività, suscitando emozioni umane come attaccamento, nostalgia o inquietudine, pur essendo prodotti da processi computazionali privi di intenzionalità affettiva diretta. Recuperando questa idea di chimera digitale, Event Modeling, progetto di Ziyang Wu e Mark Ramos, esplora come le tecnologie digitali e gli algoritmi influenzano la nostra percezione della realtà, trasformando notizie e contenuti social in fossili tridimensionali che abitano una discarica virtuale. Ogni modello 3D generato è etichettato con delle keyword che fungono da attivatori; nel momento in cui una nuova notizia pubblicata su una piattaforma social utilizza le stesse parole chiave, il fossile digitale riappare nello spazio di navigazione, mettendo in luce la dinamica di estrazione e colonizzazione che le tecnologie operano sulla nostra percezione quotidiana. Questo progetto mira a mostrare in particolare il ruolo pervasivo di algoritmi e piattaforme social all’interno della nostra definizione di realtà, un argomento che seppur non esplicitamente affrontato in questa raccolta è recentemente tornato alla ribalta per via dei repentini ribaltamenti degli equilibri geopolitici.
L’ultimo progetto che abbiamo deciso di includere in questa selezione è l’immaginifico Cultus di Zach Blas. L* artist*, pioner* della sperimentazione nel campo dell’AI, realizza un’opera che riflette su come l’immaginario dell’intelligenza artificiale sia oggi diventato assimilabile a un culto religioso. Movimenti quali Transumanesimo, Longtermismo, o The Way of the Future (WOTF) hanno infatti fuso credenze religiose e logiche capitaliste dando vita a vere e proprie forme di esaltazione mistica, con l’appoggio di importanti esponenti della tech industry. L’opera utilizza testi generati con AI addestrate su statement di aziende tecnologiche, testi sacri, filosofia transumanista, slogan promozionali della Silicon Valley e altre fonti. Blas realizza dunque un’installazione in cui elementi religiosi, magici ed esoterici, animati dal machine learning, danno vita a un rito di evocazione computazionale, facendoci riflettere sulle dinamiche che soggiacciono alla produzione di miti, paure e esaltazioni legate al progresso tecnologico e al ruolo che le stesse tecnologie AI assumono nella produzione di queste mitologie quotidiane.
La selezione qui proposta si basa sulla consapevolezza che lavorare con il machine learning e l’intelligenza artificiale non sia mai un’operazione neutra. Esplorare gli archivi, interrogarsi sulla natura dei modelli e dei contenuti che produciamo, generare immaginari capaci di sovvertire le logiche imposte dall’industria sono pratiche essenziali per costruire etiche ed estetiche significative. Attraverso questo approccio critico è possibile oltrepassare i limiti della generazione del nuovo, dando vita a discorsi alternativi che spostano la coscienza collettiva verso prospettive inedite, dove le narrazioni dominanti vengono decostruite e rinegoziate alla luce di nuove opportunità di agency sul mondo.
AI & Conflicts. Volume 2 si chiude con il testo Macchine ed ecologia, di Yuk Hui. Qui, il filosofo di Hong Kong mette in discussione il dualismo tradizionale tra regime organico e macchinico, proponendo il concetto di tecnodiversità come chiave per comprendere le dinamiche dell’ecologia tecnologica.
Il lavoro di Hui si muove a partire dalla ridefinizione del rapporto tra tecnologia ed ecologia al di fuori delle tradizionali dicotomie oppositive. Superando il dualismo cartesiano tra natura e tecnica, Hui mostra come la cibernetica abbia introdotto un nuovo paradigma basato sulla ricorsività e sull’auto-regolazione. In questo quadro, la distinzione tra umano e artificiale si dissolve, così come si complica la relazione tra intelligenza e ambiente. Tuttavia, questa svolta organismica nella comprensione delle macchine non ha eliminato i rischi di una brutale standardizzazione. La cibernetica, nella sua aspirazione a una logica universale, ha finito per riprodurre un modello di totalizzazione che annulla le differenze locali, favorendo una tecnocultura globale sempre più omogenea e deterritorializzata. È proprio per rispondere a questa problematica che Hui introduce il concetto di tecnodiversità.
L’ecologia dell’AI non può essere ridotta a un semplice problema di sostenibilità ambientale o di efficienza tecnica. Essa va intesa come una questione politica che riguarda la varietà delle epistemologie tecnologiche,la loro relazione con il contesto storico-culturale e la loro capacità di generare nuovi immaginari tecnologici. Il concetto di tecnodiversità risponde a questa esigenza, proponendo una pluralizzazione delle tecniche e delle cosmotecniche – ad esempio quella transfemminista, o quella legata alle comunità sottorappresentate – ovvero delle modalità con cui le diverse culture articolano il rapporto tra tecnologia, etica e cosmologia. In altre parole, la tecnodiversità può essere letta come un’esigenza di decentralizzazione del potere tecnologico. La razionalità estrattiva delle piattaforme digitali - e dunque del machine learning - riduce la complessità degli ambienti sociali e cognitivi a schemi standardizzati di dati e algoritmi. Questo modello, alimentato da un paradigma cibernetico, tende a uniformare le forme di vita e di conoscenza, marginalizzando le tecnologie alternative e le culture non occidentali.
Hui suggerisce che per contrastare questa tendenza sia necessario sviluppare un’ecologia delle macchine che valorizzi le differenze locali e le specificità storiche dei sistemi tecnologici, e che implichi un ripensamento dell’ontologia stessa della tecnologia, situata in un orizzonte cosmopolitico e decoloniale. Eppure, nel dibattito contemporaneo sull’intelligenza artificiale e sul machine learning assistiamo a una crescente sfiducia nelle comunità marginalizzate. Da un lato, le tecnologie AI sono sempre più pervasivamente integrate nei processi decisionali, nelle pratiche artistiche e nella produzione di conoscenza; dall’altro, cresce una comprensibile resistenza da parte di artist*, teoric* e progettist*, che vedono in queste tecnologie l’ennesima estensione di un paradigma estrattivo, colonialista e mean. In molti casi, questa resistenza si manifesta come una rinuncia all’uso degli strumenti di machine learning, nel tentativo di sottrarsi a un modello di governance tecnologica dominato dalle grandi piattaforme. Tuttavia, questo atteggiamento, per quanto legittimo, rischia di lasciare il campo dell’ecologia dell'AI privo di alternative concrete e di voci capaci di reimmaginare la disciplina. Il problema, forse, non è semplicemente rifiutare o accettare il machine learning, ma comprendere che questo campo necessita di essere attivamente presidiato. Molti dei testi in questa raccolta reclamano un ecosistema tecnologico diverso e sostenibile, che coinvolga le comunità nella progettazione dei dataset, nel concepimento di nuove forme di addestramento dei modelli e di dispositivi che provino a sviluppare una visione pluralista e situata dell’AI.
La svolta di cui abbiamo bisogno, tuttavia, non riguarda solo il sistema tecnologico, ma anche la narrazione che lo accompagna, che spesso assume oggi la doppia funzione di normare il comportamento dell* utenti e di legittimare i dispositivi di potere. Proprio in questi giorni, Sam Altman, CEO di OpenAI, ha rispolverato la retorica della magia per annunciare l’eliminazione della possibilità per l’utente di scegliere tra i diversi modelli GPT: «Vogliamo che l’AI “funzioni semplicemente” per voi; ci rendiamo conto di quanto siano diventate complesse le nostre offerte di modelli e prodotti. Odiamo la selezione dei modelli tanto quanto voi e vogliamo tornare a un’intelligenza unificata e magica» .
Il trucco è semplice: dietro l'illusione
della semplicità, si chiude progressivamente l’accesso ai modelli,
centralizzando il potere decisionale e opacizzando le dinamiche stesse del
machine learning. La retorica della magia diventa così lo strumento perfetto
per neutralizzare la complessità, eliminando la possibilità di un'interazione
critica con il sistema. L’”ottimizzazione” dei processi si traduce in
ottimizzazione del sistema estrattivo finalizzato in ultima istanza alla
produzione di profitto. L’idea stessa che la varietà e la scelta siano problemi
da eliminare – e non elementi da preservare e sviluppare – riflette la visione mean dell’industria AI: un sistema che
non è costruito per essere interrogato, ma per essere consumato.
L’urgenza non è quindi solo critica, ma anche progettuale. In assenza di nuove frizioni, di nuovi percorsi di senso e resistenza, è facile immaginare come si articolerà il conflitto: queste tecnologie continueranno a evolversi e a trasformare gli orizzonti entro cui le comunità mediano la realtà, erodendo la loro capacità di determinarla. Nei suoi 500 anni di vita il capitalismo non ha mai cambiato il suo fine ultimo: estrarre profitto. È su questa prevedibilità allora che si gioca la partita per controllare, o per lo meno dirottare tanto la tecnologia quanto i suoi immaginari. Se oggi l’AI è governata da una strategia statistica che non tollera e non considera le anomalie e le differenze, l’obiettivo è di opporre una pluralità di tattiche capaci di recuperare e riattivare quelle anomalie e quelle differenze. In questo senso, la tecnodiversità non è solo un’utopia, ma una necessità politica ed epistemica per un futuro in cui l’intelligenza artificiale sia davvero plurale e aperta all’incognito.
[Testo originariamente pubblicato in AI & Conflicts. Volume 2, a cura di Daniela Cotimbo, Francesco D’Abbraccio e Andrea Facchett. Brescia: Krisis Publishing, 2025]