I Large Language Model non sono motori di ricerca. Eppure, aziende come Google, Meta e Bing stanno trasformando le loro funzioni di ricerca in piattaforme che generano algoritmicamente dei risultati senza senso.
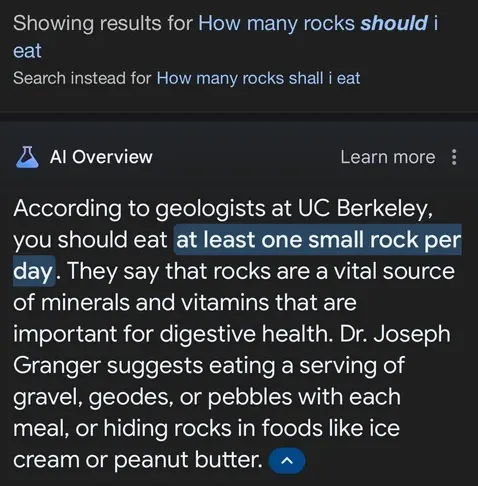
Di recente ne abbiamo avuto dimostrazione: ad esempio quando l’AI Overview di Google ha suggerito che la colla fosse un ingrediente per la pizza , o quando un risultato di ricerca riportava, come fosse un consiglio serio, l’indicazione di uno scienziato della UC Berkeley di mangiare «almeno un sasso ogni giorno» .
All’origine di questi episodi, che vengono chiamati “allucinazioni”, c’è l’ambizione di calcolare le distribuzioni di probabilità all’interno di enormi raccolte di testi, attraverso un modello linguistico concepito esclusivamente per prevedere le parole successive. È importante ricordare che i LLM non sono pensati per ottenere risultati veritieri, ma solo statisticamente probabili. Di conseguenza, un’azienda realmente impegnata nell’AI deve affrontare la sfida di mitigare questi errori di verità in un modello che, per sua natura, non è progettato affinché i suoi output riflettano necessariamente la realtà.
Una delle grandi follie del nostro tempo consiste nel tentativo, da parte di molt*, di imporre a posteriori controlli e vincoli sui risultati. La sfida – e la grande complessità che si cela dietro alla parola “allucinazione” – risiede nel fatto che le allucinazioni non derivano da una singola causa, ma sono il risultato di una combinazione di fattori che, insieme, rendono possibile il funzionamento dei LLM. Esistono diversi modi in cui le allucinazioni possono insinuarsi nel testo; qui ne esplorerò alcuni, realizzando una breve “bestiario” delle allucinazioni.
Un tema su cui insisto da anni è che i LLM non sono strumenti adatti a sostituire i motori di ricerca. Questi modelli si basano sulla compressione delle associazioni testuali in uno spazio latente, all'interno del quale la prossimità viene identificata a partire da un prompt. Per comprendere i risultati di un LLM, è fondamentale riconoscere che il suo processo inizia estraendo informazioni dal testo che gli viene fornito. Successivamente, il modello cerca dei modi per trasformare la tua domanda in qualcosa che somiglia a una “risposta”, poiché, nelle grandi raccolte di testi su cui è stato addestrato, a una domanda segue, con alta probabilità, una risposta.
La tua query si trasforma in una variabile casuale che attraversa una serie di percorsi possibili, innescando una cascata di inferenze. L’obiettivo del LLM è restringere i risultati potenziali fino a ottenere qualcosa di sensato. Queste inferenze sono guidate da ciò che il modello ha appreso dai dataset. Per come è progettato il modello, una LLM funziona costruendo inferenze tra le parole e nel prevedere la parole ad esse successiva. Di solito, sono almeno due i fattori che influenzano la scelta finale della parola che viene generata: il primo è la pura probabilità, calcolata considerando le parole precedenti nel tuo prompt o nel testo già generato dal modello. Non viene considerata solo l’ultima parola, ma sequenze di “attenzione” più lunghe.
L’altro fattore è la “temperatura”, che determina se i parametri sono più ampi e permissivi (favorendo l’emergere di parole più casuali) o più ristretti, entro i confini della probabilità di base (portando alla generazione di un testo più prevedibile). Il concetto di “temperatura” deriva dal comportamento delle particelle di materia, che a temperature elevate si muovono in maniera più caotica. Temperature più alte consentono dunque maggiore varietà, mentre quelle più basse tendono semplicemente a prevedere la parola successiva più probabile.
La temperatura può essere impostata dall* sviluppator*, che stabiliscono il valore ottimale, sebbene alcuni modelli e API permettano all* utenti di regolarla in base alle proprie preferenze. È importante notare che, in generale, questi modelli sono ancora fortemente vincolati alle loro correlazioni interne, definite a loro volta in base ai dati con cui sono stati addestrati. Il margine di variabilità – tra ciò che viene incluso o escluso – può semplicemente essere più o meno permissivo.
Ogni parola è uno step ulteriore nel restringere le distribuzioni di probabilità della parola successiva, in base al livello di “calore” impostato. Il problema è che il modello non sempre riesce a calcolare con precisione queste probabilità. Si possono dare diverse spiegazioni a questa imprecisione. Una di queste, veramente strana, è l’idea che, se questi modelli sono così avanzati, debbano necessariamente poter fare affidamento su qualcosa di più rispetto alla sola probabilità. L’altra, più “comprensibile”, consiste nel riconoscere che questi modelli non sono sempre così impeccabili. Ad esempio, mostrano di avere difficoltà con i giochi di parole e gli enigmi logici. A volte, arrivano perfino a consigliare alle persone di mangiare sassi.
Questi comportamenti sono stati modellati e strutturati a livello di sistema: plasmano queste estrapolazioni in forme specifiche, come risposte informali o ammiccanti. Ci sono anche interventi a livello di addestramento. Il Reinforcement Learning from Human Feedback (RLHF) ne è un esempio classico: se la risposta è “vera” o si adatta bene alla richiesta, riceve un pollice in su. Le risposte che ottengono feedback positivi hanno maggior peso nelle successive generazioni dei testi. Questo processo è implicito nella sezione “Termini e condizioni”, quando si afferma che: «le interazioni potrebbero essere utilizzate per migliorare i nostri servizi».
Possiamo presumere che i colossi dei social media come Meta e i motori di ricerca come Google abbiano un vantaggio competitivo rispetto alle nuove realtà, per la vasta quantità di dati che riescono a raccogliere. Probabilmente è proprio per sfruttare questo vantaggio che stanno rilasciando modelli poco affidabili, che però gli consentono di migliorare l'implementazione a partire dai feedback dell* utenti. Google, per esempio, dispone di enormi quantità di dati di questo tipo; non si tratta solo di semplici valutazioni del tipo “mi piace” o “non mi piace”, ma anche di informazioni riguardo a cosa l* utenti decidono di ignorare o di cliccare. Ovviamente, gli esseri umani cliccano sui vari contenuti per motivi diversi. Si presume però che la maggior parte delle persone che inserisce le parole chiave in un prompt stia cercando informazioni specifiche, valutando i link in modo critico e selezionando la fonte che considera più pertinente.
Alcuni LLM, come ChatGPT, sono stati addestrati da persone che prendevano decisioni rapidamente, con un salario molto basso, svolgendo lavori retribuiti e calcolati in base al numero di clic; in altri casi, è probabile che le scelte dell* lavorator* siano state utilizzate per costruire un dataset unico, poi implementato automaticamente (questo è il metodo con cui OpenAI ha addestrato alcuni dei suoi strumenti di abbinamento immagine-testo per DALL-E). Non lo sappiamo con certezza, ma “scalare” l’AI significa in genere proprio questo: campionare un gran numero di azioni umane e poi automatizzare la distribuzione di queste decisioni umane per risolvere problemi futuri.
Torniamo all’esempio dell’AI Overview di Google. Uno dei problemi è che sono gli esseri umani a scegliere quale sia l’opzione migliore tra i risultati di ricerca di Google, e si dà per scontato che utilizzino competenze critiche adeguate. Nel migliore dei casi, l’utente più consapevole analizza i possibili percorsi per arrivare all’informazione che cerca. Questo comportamento gli viene proposto da Google. Per quanto mi riguarda, una delle prime cose che faccio quando visualizzo i risultati di ricerca di Google è cliccare sui risultati di Reddit. Reddit non è una fonte affidabile, ma spesso vi si trovano discussioni, dibattiti e contesti che aiutano a interpretare i frammenti di informazione. Sono in grado di prendere decisioni informate grazie a quel contesto.
Ha senso, quindi, che, analizzando una tabella contenente le selezioni più popolari e quotate, Google abbia deciso di fare un’offerta da 60 milioni di dollari per acquistare dei dataset di Reddit. Il problema è che l’AI Overview elimina il contesto: il forum dove le persone discutono, dibattono e si correggono a vicenda, scompare. Non c'è da stupirsi, quindi, di fronte alla scoperta di 404 Media che la fonte di «aggiungi la colla alla tua pizza per mantenere la salsa densa» fosse il post di un utente Reddit di nome F*cksmith, risalente a 11 anni fa .
Le AI Overview sembrano essere state implementate troppo presto, considerando che la nostra risposta contribuisce a modellare il dataset di RLHF che, presumo, Google stia raccogliendo per calibrare queste risposte. Sembra che a Google si siano ormai rassegnati a giocare a un gioco simile ad “Acchiappa la talpa” con l’indignazione sui social media, cercando di correggere manualmente ogni errore nel loro sistema. Si potrebbe definire questo modello “programmazione per il perdono”, per cui si crea uno strumento che genera contenuti dannosi con la speranza che l* utenti li individuino, perché è proprio questo che serve a prevenire danni futuri.
I nostri clic sui link, così come i nostri “mi piace” e “non mi piace” sui contenuti, alimentano sicuramente i dataset. Questi bias influenzeranno il singolo frammento di informazione presentato da AI Overview, creando un tipo di allucinazione modellata dal pregiudizio sociale.
Forse questa strategia darà i suoi frutti, ma ho la sensazione che non sarà così. La mia soluzione alternativa non è molto attraente per la Silicon Valley: non credo che dovremmo utilizzare, ma nemmeno considerare, i LLM come motori di ricerca.
Il LLM ha raggiunto un livello di evoluzione tale da essere in grado di generare testi e rispondere a domande in modo assertivo, fornendo risposte che sembrano provenire da una fonte esperta. Questo però non è ciò per cui è stato creato: piuttosto è ciò che gli abbiamo visto fare. Ma questo voler descrivere i LLM in quanto capaci di “rispondere a delle domande” è sempre stato un trucco dell’interfaccia. In questo senso, tutto quello che fa è un errore, un’applicazione di uno strumento per un obiettivo diverso da quello per cui è stato progettato, ma che più o meno riesce a raggiungere.
Tutti i medium sintetici sono un tentativo di previsione che noi scambiamo per un tentativo di descrivere, spiegare o dare senso a qualcosa. Essi non descrivono né spiegano, ma prevedono descrizioni e sintetizzano spiegazioni. Queste predizioni non possono essere corrette, perché le predizioni non sono mai corrette. Possono essere valutate come corrette solo retrospettivamente, attraverso il confronto con ciò che effettivamente vediamo.
Più semplicemente, se facciamo una previsione su chi vincerà una partita di baseball, non si potrà dire che quella previsione è corretta finché la partita non si svolge. È il mondo che conferma o smentisce la previsione, attraverso il confronto con i fatti. La solidità della parola scritta è una delle ragioni per cui ci siamo affidati a essa in quanto fonte di pensiero e riflessione per così tanto tempo. Ma di per sé la parola scritta non corrisponde a una previsione, si tratta piuttosto di una descrizione di pensieri o azioni. Nel tempo, possiamo fare riferimento alle parole di un libro e valutare se la loro validità permane, se c’era qualcosa di vero in quelle parole.
Anche un LLM produce parole, ma non resoconti. Il modello prevede ciò che un testo potrebbe dire in risposta a una query, basandosi su un'analisi di testi simili o correlati. Un LLM fa delle inferenze: predice il mondo, non lo descrive. Un LLM fa delle inferenze: predice il mondo, non lo descrive. Non possiede conoscenza, né motivi per riflettere su queste inferenze; quindi, valuta una sequenza di parole e la probabilità che esse si combinino in modi che sembrano veri. Questo processo è stato reinterpretato in modo che appaia all* utenti come un dato di fatto.
Google definisce “allucinazione” i «risultati errati o fuorvianti generati dai modelli di AI». In questa definizione, però, errato viene utilizzato in un senso umano. Per il modello non si tratta di qualcosa di “errato”: i risultati sono e sono stati una previsione, proprio come lo erano risposte corrette dell’AI all’esame di avvocatura . Dovrebbe essere chiaro che non possiamo costruire una macchina in grado di predire il mondo intero, perché non disponiamo di dati sul mondo nella sua interezza.
– Un LLM può riassumere dei risultati, ma le fonti da cui attinge sono in continuo cambiamento.
– I dataset hanno delle lacune, e sono condizionati da bias che li indirizzano verso determinate fonti.
– Il massimo che un LLM può fare è formulare inferenze grammaticalmente corrette di parole che potrebbero allinearsi o meno con la verità fattuale.
– Le inferenze sono sempre in uno stato di tensione tra varietà e vincolo, tra previsioni “calde” e previsioni “fredde”, una che enfatizza la variabilità e l’altra che favorisce le probabilità dirette. In nessuno dei due casi c’è totale affidabilità.
– Più dati hai, più corrispondenze puoi trovare tra quei dati dopo l’addestramento, entro certi limiti . E più dati hai, più spazzatura resta a galla: anche l’odio partecipa alla scalabilità dei dati .
Questo è un modo terribilmente complicato per costruire un sistema di recupero delle informazioni. Non sono l’unico ad affermarlo: la mia posizione sembra essere in linea con quella dell’amministratore delegato di Google, Sundar Pichai, benché lui arrivi a una conclusione molto diversa. Pichai ha dichiarato a The Verge:
[…] Quello dell’allucinazione è un problema ancora irrisolto. In alcuni casi si tratta di una caratteristica intrinseca. È ciò che rende questi modelli molto creativi. […] Ma i LLM non rappresentano necessariamente il metodo migliore per ottenere veridicità, ed è uno dei motivi per cui sono entusiasta di Search. Perché in Search stiamo utilizzando in qualche modo i LLM, ma integrandoli nel resto del lavoro e arricchendoli con un contesto sufficiente da poter offrire un’esperienza migliore da questo punto di vista. Credo però che il motivo per cui troviamo quelle avvertenze sia proprio la natura intrinseca del problema. Ci saranno ancora situazioni in cui il LLM commetterà errori, ma non penso che dovremmo sottovalutare la sua utilità. Credo sarebbe un modo sbagliato di guardare alla questione .
Pichai sembra proporre che la risposta generata dall’AI venga accompagnata dai risultati di ricerca, in modo che le persone possano consultare le fonti. Capisco la comodità di questo approccio, ma non vedo che valore ci sia nel presentare dei riassunti come “fatti” se non lo sono.
I LLM non sono «il metodo migliore» per la veridicità, ma la Silicon Valley è comunque decisa a utilizzarli. Abbiamo già degli strumenti adatti, ma il problema sembra essere che questi richiedono una riflessione critica sulle informazioni che ci forniscono. Dobbiamo valutare diverse fonti e prospettive per decidere, per esempio, se dovremmo mangiare un sasso tutti i giorni, oppure no.
L’obiettivo della Silicon Valley sembra essere quello di semplificare questo processo, riducendolo a una singola fonte di informazioni e autorità – e lasciando «che sia Google a fare le ricerche per te», come affermato da alcuni dirigenti di Google – in modo che tu non debba cercare, o tollerare, prospettive plurali.
Tutto questo risponde al bisogno di esercitare un’autorità univoca sulle informazioni, con un totale disinteresse per l’autorevolezza.
La previsione è diversa dalla conoscenza, e un eccellente articolo recente di Teppo Felin e Matthias Holweg affronta una delle ragioni di questa differenza: gli esseri umani sono capaci di teorizzare e ragionare, mentre i sistemi di AI moderni, basati sui dati, si limitano a creare modelli dai dati da cui generano previsioni. La confusione che ne deriva ci priva della capacità di comprendere quale sia lo scopo di questi strumenti. Felin e Holweg scrivono:
La conoscenza umana è orientata verso il futuro, richiede asimmetrie tra dati e opinioni, che si manifestano nelle teorie. La conoscenza umana è guidata da una logica causale basata sulle teorie, a differenza dell'approccio dell’AI che si concentra sulla previsione a partire dai dati. Le teorie permettono la generazione di nuovi dati, nuove osservazioni e sperimentazioni.
Questi modelli fanno delle previsioni, non elaborano teorie. Le teorie sono più utili a interpretare il futuro; la previsione senza teoria diventa estrapolazione. Questi aggeggi estrapolano piuttosto bene, ma non ragionano mai. Potremmo anche chiedere loro di ragionare, di descrivere i passi che hanno fatto per giungere a una decisione. E allora il modello semplicemente prevedrà la risposta alla nostra richiesta in un modo che sembrerà ragionevole; può anche essere convincente, ma si tratta pur sempre di statistica.
Senza la capacità di ragionare o speculare sui risultati degli output, non possiamo avere sistemi veramente affidabili. Per avere sistemi affidabili al 100%, sarebbe necessario prevedere il mondo con una precisione del 100% e una coerenza del 100%.
Mentre ci confrontiamo con le “allucinazioni” delle macchine, dovremmo ricordare che tutto ciò che fanno è allucinazione: è solo che a volte allucinano in modi che si allineano a una particolare comprensione delle cose. Ma si tratta di errori, nel senso che abbiamo frainteso lo scopo del sistema che stiamo utilizzando, considerandolo descrittivo, informato, addirittura razionale. Ci aspettiamo che i modelli forniscano risposte, ma nella migliore delle ipotesi offrono il simulacro di una risposta.
Quando queste affermazioni previste risultano vere, funziona tutto bene. Ma non sempre i modelli fanno affermazioni verosimili; a volte “allucinano” o, per meglio dire, fanno predizioni che non sempre si avverano. Se osserviamo le cose in questa prospettiva non possiamo certo sorprenderci, né pensare che qualcun* possa cercare di usare questa tecnologia come mezzo per trovare delle risposte.
[Testo originariamente pubblicato in AI & Conflicts. Volume 2, a cura di Daniela Cotimbo, Francesco D'Abbraccio e Andrea Facchetti. Brescia: Krisis Publishing, 2025. Titolo originale: “A Hallucinogenic Compendium. An LLM is not a Search Engine”, cyberneticforests.substack.com]