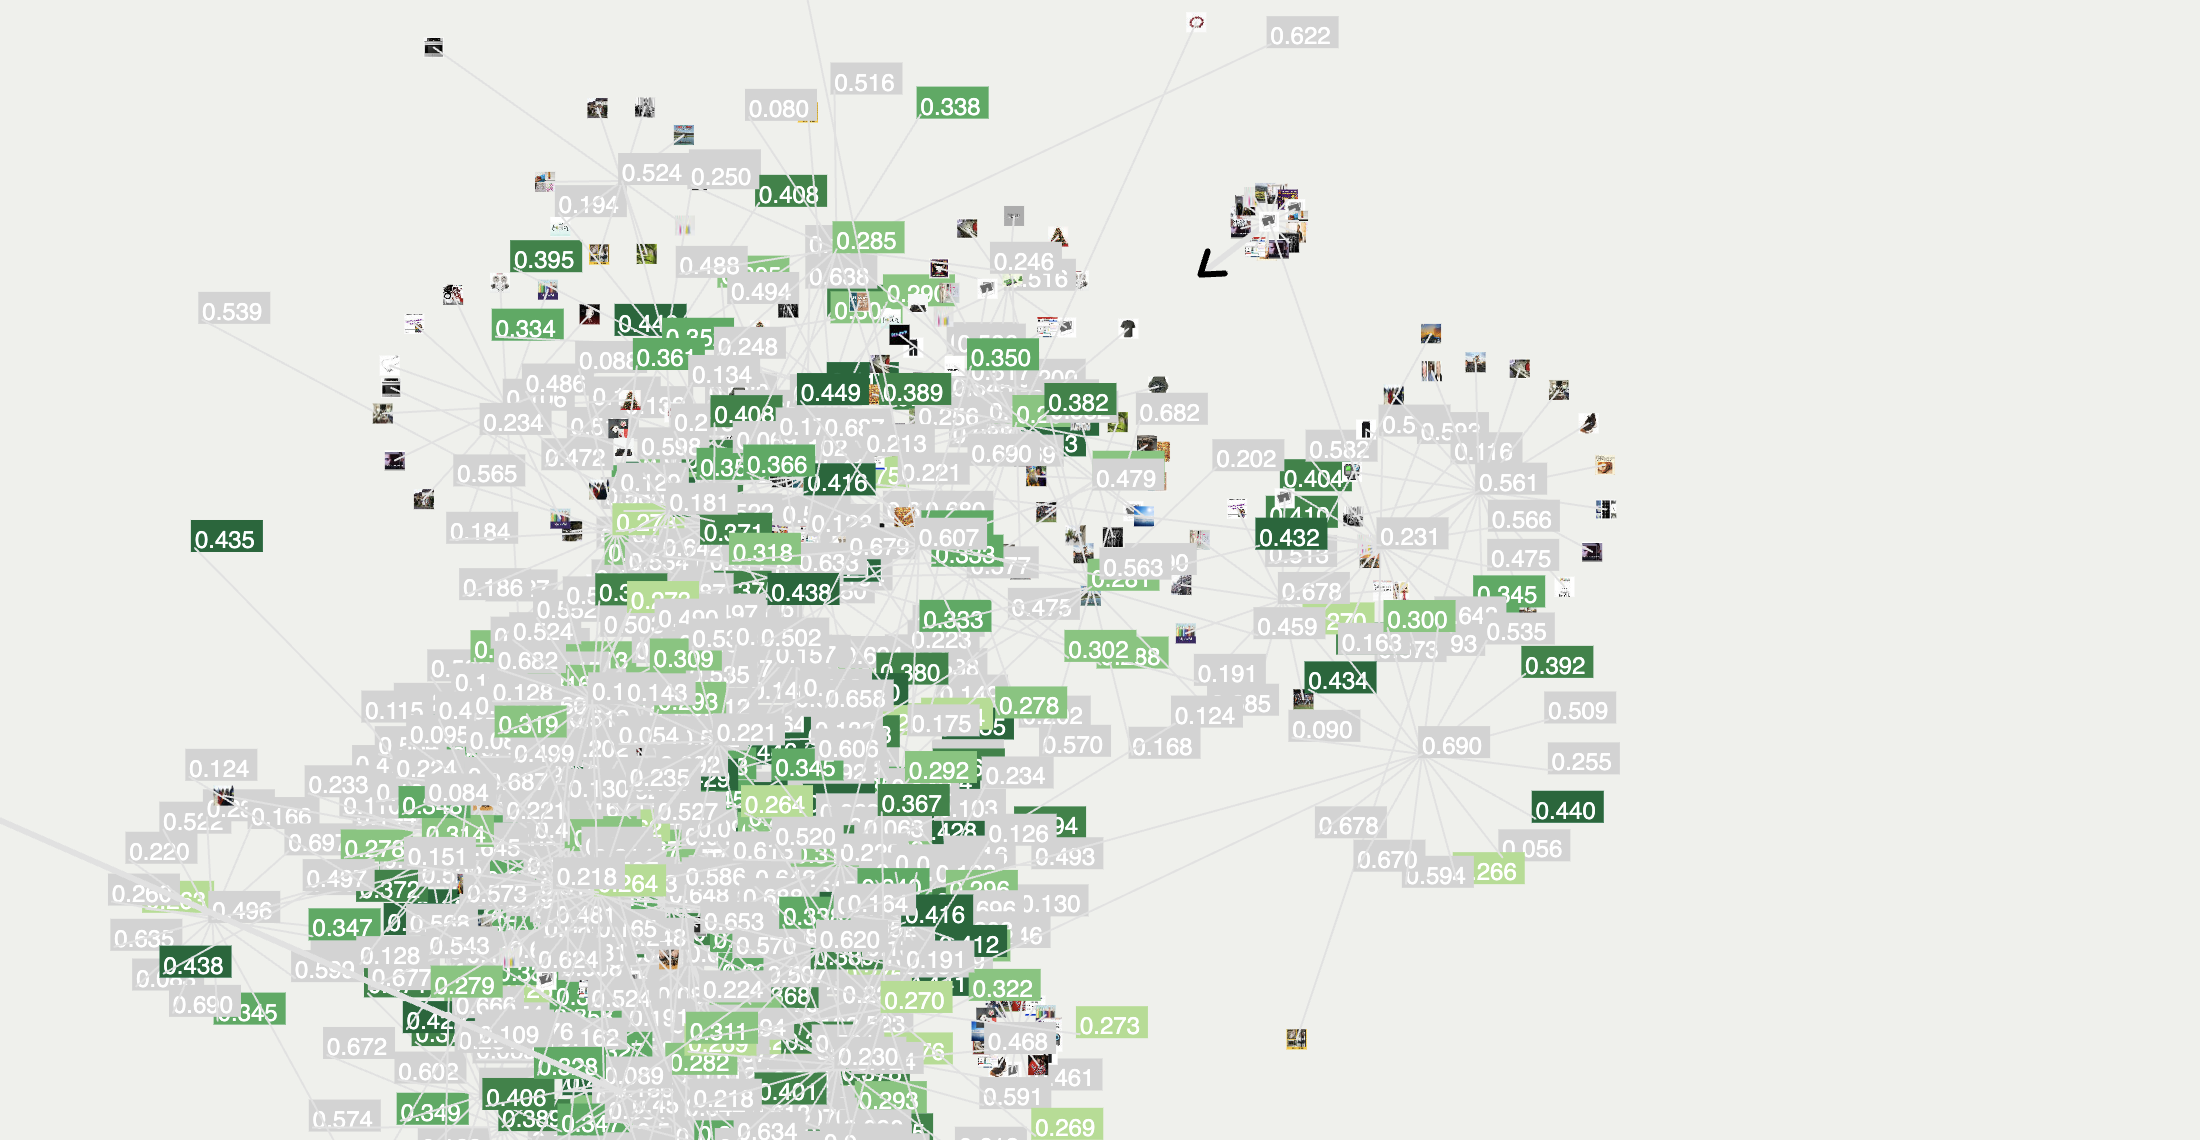
Se vuoi creare un modello AI molto grande – del tipo che può generare immagini, fare i tuoi compiti, creare un sito web, fingere un atterraggio sulla luna – devi iniziare trovando un dataset molto grande.
Miliardi di immagini e parole raccolte da internet, materiale per costruire il mondo che il tuo modello di intelligenza artificiale ti restituirà.
Il contenuto del dataset è estremamente importante. Influenzerà, più di qualunque altra cosa, che cosa il tuo modello sarà in grado di fare e con quale efficacia.
Eppure, ancora poche persone hanno impiegato del tempo per osservare che cosa contengono i dataset che alimentano i loro modelli.
Quando lo fanno, emergono dei veri problemi, spesso con delle serie implicazioni legali.
A dicembre, alcun* ricercator* dell’Internet Observatory presso l’Università di Stanford hanno identificato più di 1000 immagini catalogate come Child Sexual Abuse Material (CSAM) in uno dei dataset più influenti del momento: LAION-5B.
LAION-5B è un dataset open-source molto grande che raccoglie immagini e caption da internet, progettato per grandi modelli AI. È stato rilasciato nel 2022 da LAION, una organizzazione no-profit tedesca.
LAION-5B è ciò che viene chiamato un “foundation dataset” per le intelligenze artificiali generative.
Addestrare un modello su LAION-5B serve a fornirgli una rappresentazione completa del mondo, utile a costruire una sorta di vocabolario di cose e concetti.
L’obiettivo dichiarato per la creazione di LAION-5B era quello di condurre una ricerca di base per l’organizzazione dei dataset. In particolare, gli sviluppatori volevano creare un dataset di immagini con dei metodi puramente automatizzati: “hands-off”, senza la supervisione di esseri umani.
Il dataset hands-off che ne è risultato è stato usato in centinaia di progetti accademici. Il paper con cui è stato annunciato il progetto di LAION-5B è stato citato 1331 volte.
Nella loro homepage, gli sviluppatori mettono esplicitamente in guardia dal suo uso nei contesti quotidiani:
«Pur fornendo il nostro dataset in modo aperto, non ne raccomandiamo tuttavia l’utilizzo per la creazione di prodotti industriali pronti all’uso».
Questo avvertimento è stato in gran parte ignorato. Midjourney e Stable Diffusion, due grossi modelli dei cui dati si conoscono solo in parte le origini, sono stati parzialmente addestrati su LAION-5B.
È probabile che molti altri modelli commerciali – forse centinaia – siano stati creati con questo dataset. Modelli che alimentano i chatbot e i generatori di immagini e che hanno centinaia di migliaia di utenti. Il fatto che ci siano immagini pedopornografiche all’interno di LAION-5B è allarmante, ma non certo sorprendente.
Date le dimensioni di LAION-5B, la gestione e l’organizzazione umana dei dataset è quasi impossibile.
Se guardassi ognuna delle immagini del dataset per un solo secondo, lavorando full-time otto ore al giorno, cinque giorni a settimana, impiegheresti 781 anni.
Staresti facendo un lavoro importante.
Analizzare i dataset è una pratica essenziale per comprendere come lavorano i modelli generativi di intelligenza artificiale, i modi in cui vedono e ricreano il mondo.
Esaminare questi dataset è forse l’unico modo per avere un’immagine chiara dei modelli che vengono addestrati su di essi.
Queste analisi ci possono aiutare a identificare dei bias e a prevedere meglio rischi e danni che potrebbero verificarsi qualora i modelli dovessero diffondersi su larga scala.
Ma come si
può analizzare qualcosa che richiede una vita intera per essere osservato?
Si comincia cercando di capire esattamente com’è fatto.
LAION-5B è stato creato da Common Crawl, un dataset ancora più grande che viene da un’altra organizzazione no-profit.
Common Crawl è un corpus di dati provenienti da una operazione di crawling mensile sul web. Contiene dati provenienti da più di 3 miliardi di siti.
Alcuni di questi siti in particolare sono molto ben rappresentati su LAION-5B.
Ci sono quasi 155 milioni di abbinamenti (immagini+caption) che provengono da Pinterest; circa uno ogni quaranta abbinamenti.
Il 2,4% di dati di LAION-5B – 140 milioni di abbinamenti di immagini – proviene da Shopify.
72 milioni di abbinamenti vengono da SlidePlayer, una piattaforma per l’archiviazione e la condivisione di presentazioni PowerPoint.
Questi ambiti sono ben rappresentati in LAION-5B anche perché contengono numerose immagini.
Inoltre, i contenuti di questi tre siti sono organizzati in un modo da renderli particolarmente interessanti per i metodi di organizzazione statistica di LAION.
Per creare LAION-5B, gli sviluppatori hanno processato Common Crawl cercando tag HTML IMG che avessero un attributo ALT.
L’intento originario dell’attributo ALT è migliorare l’accessibilità, in particolare per persone con disabilità visive che utilizzano degli screen reader.
Meno del 40% delle immagini sul web hanno dei tag ALT. Per alcuni siti questa percentuale è molto maggiore.
Per esempio, SlidePlayer sembra aggiungere automaticamente i tag ALT, popolandoli con testi tratti dalle slide PowerPoint che acquisisce.
Pinterest genera in automatico le caption sulle proprie pagine a partire dal tag ALT; l* utenti hanno dunque imparato a compilarle prima di pinnare le loro immagini.
L* utenti di Shopify hanno come riferimento i punteggi di Google PageRank e scrivono descrizioni con tag ALT tenendo a mente le regole SEO (Search Engine Optimization).
Tutto questo significa che i tag ALT non sono realmente delle descrizioni di immagini, quanto piuttosto creazioni dell* lavorator* del web e degli obiettivi commerciali dei creatori.
Il contenuto di un tag ALT dovrebbe descrivere cosa è contenuto in un’immagine.
Nonostante questo, i tag ALT spesso descrivono ciò che i proprietari dei siti vogliono che l’algoritmo veda, non ciò che vogliono che venga visto dagli esseri umani.
Ecco una verità importante riguardo a LAION-5B: Vi si trova molto meno riguardo al modo in cui gli esseri umani vedono il mondo, rispetto al modo in cui i motori di ricerca vedono il mondo. È un dataset fortemente plasmato da logiche commerciali.
Un momento chiave della creazione di LAION-5B è stato il tentativo di selezionare immagini e caption da Common Crawl in cui il testo dell’attributo ALT combaciasse il più possibile con il contenuto dell’immagine.
Per farlo, gli sviluppatori hanno usato un modello chiamato CLIP (Contrastive Language–Image Pre-training), una rete neurale sviluppata da ricercatori di OpenAI.
Gli sviluppatori hanno usato CLIP per ottenere un punteggio con cui valutare quanto una stringa di testo corrisponda a un’immagine: una metrica per la somiglianza tra l’immagine e il suo tag ALT.
Gli autori di LAION-5B hanno utilizzato questo punteggio per determinare quali immagini e caption di Common Crawl includere nel loro dataset.
Per giungere a un punteggio minimo accettabile, LAION-5B ha addestrato un
modello con esempi provenienti da Common Crawl confrontandoli con dei dataset
popolari di riferimento, come ImageNet-1K.
Gli sviluppatori hanno così stabilito che avrebbero incluso in LAION gli abbinamenti testo-immagine con un punteggio di somiglianza al di sopra di una soglia compresa tra 0,26 e 0,28 (a seconda della lingua usata nella caption).
Questa soglia minima è ciò che definisce più di ogni altra cosa quali immagini possono essere contenute in LAION-5B.
Come accade per la maggior parte delle reti neurali, è difficile ricostruire il funzionamento di CLIP. OpenAI non è trasparente rispetto ai dati su cui CLIP è stato addestrato. Gli abbinamenti di immagini in LAION – e i loro punteggi – ci lasciano intravedere qualcosa rispetto al suo funzionamento.
Osservando le immagini che si trovano ai margini estremi delle soglie di
somiglianza di LAION-5B, possiamo capire come CLIP percepisce le immagini e
come l’uso di questo punteggio possa influenzare ciò che LAION include ed
esclude.
Alti punteggi di somiglianza vengono tendenzialmente assegnati ad abbinamenti in cui il testo nell’immagine corrisponde perfettamente al tag ALT.
I punteggi generati dal team di LAION utilizzando CLIP sembrano avere dei limiti più alti rispetto al range di 0,5; ci sono solo 22.645 immagini in tutto il set 5B che hanno punteggi più alti di 0,5.
Ecco alcuni abbinamenti immagine-testo con punteggio di somiglianza maggiore di 0,46.
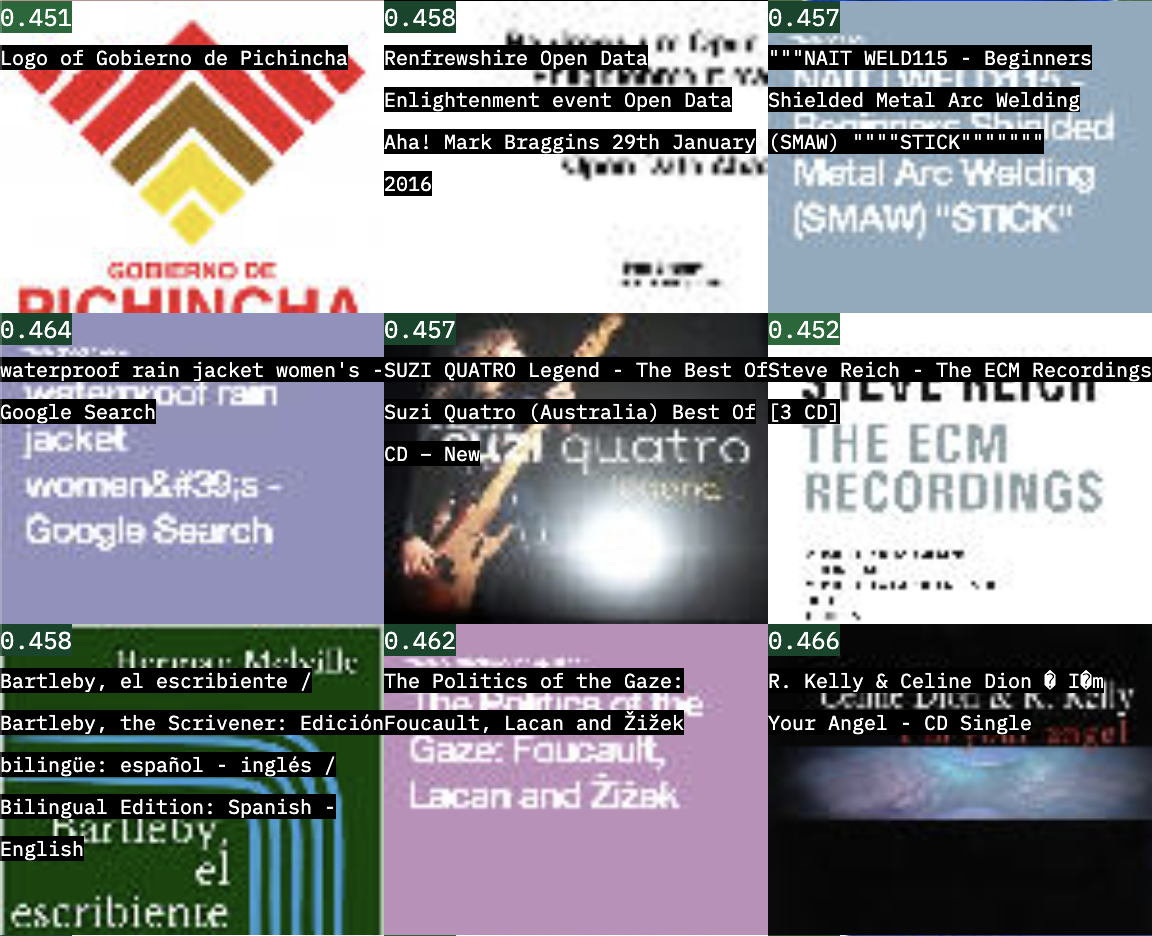
Si tratta prevalentemente di abbinamenti in cui l’immagine contiene del testo e in cui il tag ALT combacia con esso.
Analizzando LAION-5B è chiaro che questi punteggi di CLIP sono distribuiti in maniera disomogenea.
Molto spesso i punteggi si avvicinano alla soglia scelta da LAION.
Un buon 16%
delle immagini totali nei diversi sottoinsiemi presenta punteggi che si
avvicinano molto al limite inferiore, con un intervallo massimo di 0,01.
Ciò significa che se gli sviluppatori di LAION avessero deciso di alzare la soglia di somiglianza CLIP di appena 0,01, avrebbero rimosso 937.489.831 abbinamenti dal dataset.
Le più piccole variazioni nelle soglie di LAION avrebbero potuto escludere o includere centinaia di milioni di immagini.
Il contenuto dell’immagine non influisce ciò che resta e ciò che viene escluso.
L’approccio statistico all’organizzazione dei dataset comporta proprio questo: delle piccole modifiche al codice possono avere effetti profondi sul contenuto dei dataset e sui modelli che li utilizzano per plasmare la loro visione computazionale del mondo.
Da tutto questo possiamo imparare due cose importanti.
In primo luogo che l’organizzazione algoritmica dipende in genere da soglie numeriche che sono spesso poco conosciute.
Per decenni i dataset sono stati costruiti dall’intervento umano. Questo ha generalmente prodotto dataset di alta qualità, ma troppo piccoli per permettere ai Large Language Models (LLM) di fornire risultati significativi.
LAION ha deciso di costruire un dataset per questi modelli più recenti e “affamati”. Il dataset è stato creato interamente attraverso processi automatici, testando modelli e modificando le soglie: LAION-5B è stato realizzato su misura.
Ma che cosa viene misurato? La qualità dei dati? La capacità di CLIP? Il successo di un modello rispetto a un parametro di riferimento? Il parametro in sé?
In secondo luogo, c’è una circolarità intrinseca alla creazione dei dataset per l’AI.
Poiché i dataset devono essere così grandi, la loro costruzione coinvolge necessariamente l’utilizzo di altri modelli, a loro volta addestrati su dataset popolati algoritmicamente.
Prendiamo in considerazione il punteggio di somiglianza di LAION-5B: è il risultato di un modello (CLIP) addestrato su di un dataset, rispetto al quale OpenAI non fornisce informazioni.
Per
raggiungere una soglia di somiglianza accettabile, LAION ha creato un altro
modello, addestrato su una piccola parte del proprio dataset e lo ha
confrontato con i principali benchmark (es. ImageNet-1K).
Lo standard di riferimento per questo parametro è stato fissato nel 2020 da
un terzo modello, una rete neurale molto diffusa che si chiama ResNet50.
Ci sono modelli all’origine dei modelli e dataset all’origine dei dataset.
Le omissioni, i bias e i punti ciechi presenti in queste stratificazioni di modelli e dataset influenzano i successivi modelli e dataset che ne derivano.
Solamente osservando i dataset possiamo avere un’idea più precisa di come funzionano i modelli di intelligenza artificiale, di tutti i vuoti, gli errori e i bias che possono conseguirne.
Riferirsi a LAION-5B al singolare, come un unico enorme dataset, è comodo.
In realtà la maggior parte dell* ricercator* che addestrano dei modelli su LAION-5B utilizza un sottoinsieme di dati, costruito avendo in mente un obiettivo o un task specifico.
Non c’è infatti alcun modo di scaricare direttamente LAION-5B, è necessario scegliere uno dei tre sottoinsiemi linguistici.
LAION-2B EN
2.3 miliardi di abbinamenti immagine-testo in cui il testo viene identificato dall’algoritmo come lingua inglese.
LAION-2B MULTI
2.3 miliardi di abbinamenti immagine-testo in cui il testo viene identificato dall’algoritmo come non inglese.
LAION-1B NOLANG
1,27 miliardi di abbinamenti immagine-testo in cui l’algoritmo non è riuscito a identificare la lingua o il livello di affidabilità era troppo basso.
Per implementare questi sottoinsiemi, gli sviluppatori di LAION si sono affidati a un modello di machine learning sviluppato da Google e chiamato CLD3 (Compact Language Detector 3). Il modello viene utilizzato per classificare la lingua del tag ALT in una delle 107 classi linguistiche.
Dopo l’inglese, il russo è la lingua che si trova più frequentemente nel dataset, seguito dal francese e dal tedesco.
Per ciascuno dei 225 milioni di parlanti russofoni presenti sul pianeta c’è un’immagine nel dataset catalogata come russa.
C’è una caption etichettata come francese per ogni due parlanti francofon*.
Per una persona su 35 dei 71,6 milioni di persone che parlano lo swahili c'è una caption LAION-5B etichettata come swahili.
Al contempo, per ogni parlante anglofono sulla terra ci sono 1,6 caption etichettate come inglesi.
Per ogni parlante olandese ci sono 3 caption etichettate come olandesi.
Per ogni parlante islandese ci sono 7 caption etichettate come islandesi.
Queste statistiche ci dicono poco sulla composizione del dataset di origine – Common Crawl – ma ci dicono invece molto sui limiti del modello di rilevamento linguistico che gli sviluppatori di LAION-5B hanno deciso di utilizzare.
La distribuzione linguistica tra Common Crawl e LAION-5B differisce in maniera sostanziale.
In altre parole, la quantità di pagine in una lingua presenti in Common Crawl potrebbe non corrispondere al numero di immagini di LAION-5B per quella stessa lingua.
Per fare un esempio: ci sono 34.270.773 caption in LAION-5B che CLD3 ha classificato come “lussemburghese”: una lingua parlata da appena 300.000 persone. Significa 1 caption ogni 114 immagini del dataset.
Eppure le pagine classificate come lussemburghesi in Common Crawl sono solo all'incirca 53.500: 1 ogni 58.000 pagine.
Osservando un set di abbinamenti di immagini e caption taggate come lussemburghesi, ci accorgiamo subito che il testo ALT è nella maggior parte dei casi in inglese o in una lingua completamente diversa.
Il motivo per cui CLD3 tende a identificare erroneamente la lingua lussemburghese meriterebbe un’ulteriore indagine, insieme all’analisi di un altro dataset.
In ogni caso, questo è un buon esempio di come i processi non supervisionati di LAION falliscano facilmente.
Nonostante il fatto che molte caption in inglese sembrino essere state classificate erroneamente come altre lingue, è ovvio che LAION-5B nel complesso dà priorità ai contenuti in lingua inglese.
Questa preferenza caratterizza anche il dataset su cui è stato costruito LAION-5B, ossia Common Crawl, in cui il 45% dei siti raccolgono principalmente contenuti in inglese.
Una simile ripartizione ci dice qualcosa di specifico sulla visione del mondo contenuta in LAION-5B; una prospettiva che viene trasferita nei modelli AI addestrati su di esso.
Per i modelli addestrati su LAION-5B l’inglese (e la cultura anglofona) ha più valore di tutte le altre 107 lingue messe insieme.
Gli sviluppatori di LAION-5B sono consapevoli dei limiti di Common Crawl nel rappresentare diversità linguistiche e culturali.
Tuttavia, ritengono che la situazione sia gestibile. Dopotutto, i loro sforzi sono al servizio di una ricerca che non è finalizzata a creare “progetti industriali pronti all'uso”.
Eppure, il team di LAION ha sviluppato ulteriori sottoinsiemi del proprio enorme dataset, pensati per soddisfare le esigenze specifiche delle intelligenze artificiali generative rivolte all* consumator*.
Oltre ai sottoinsiemi linguistici, LAION ha pubblicato numerosi altri dataset derivati da LAION-5B, progettati per scopi specifici.
Forse il più interessante tra questi è LAION-Aesthetics, un sottoinsieme ideato per raccogliere immagini che hanno una “alta qualità visiva”.
Se chiedi a Midjourney o a Stable Diffusion di generare un’immagine, otterrai un risultato che è stato ottimizzato utilizzando questo sottoinsieme di LAION.
Il modello usato per creare questo sottoinsieme è stato addestrato su tre fonti
diverse: un set di 15.000 immagini di loghi e due diversi gruppi di immagini
etichettate dall* utenti come visivamente attraenti.
Un campione di immagini proviene da un dataset chiamato Simulacra Aesthetic Captions (SAC). Questo set contiene immagini sintetiche, generate da AI generative come CompVis Latent GLIDE e Stable Diffusion.
238.000 di queste immagini sono state etichettate dall* utenti delle comunità
Discord per GLIDE e Stable Diffusion, all* quali è stato chiesto di assegnare
alle immagini un punteggio su una scala da 1 a 10.
Quelle che
seguono sono un campione delle 176.000 immagini con i punteggi più alti del
dataset.
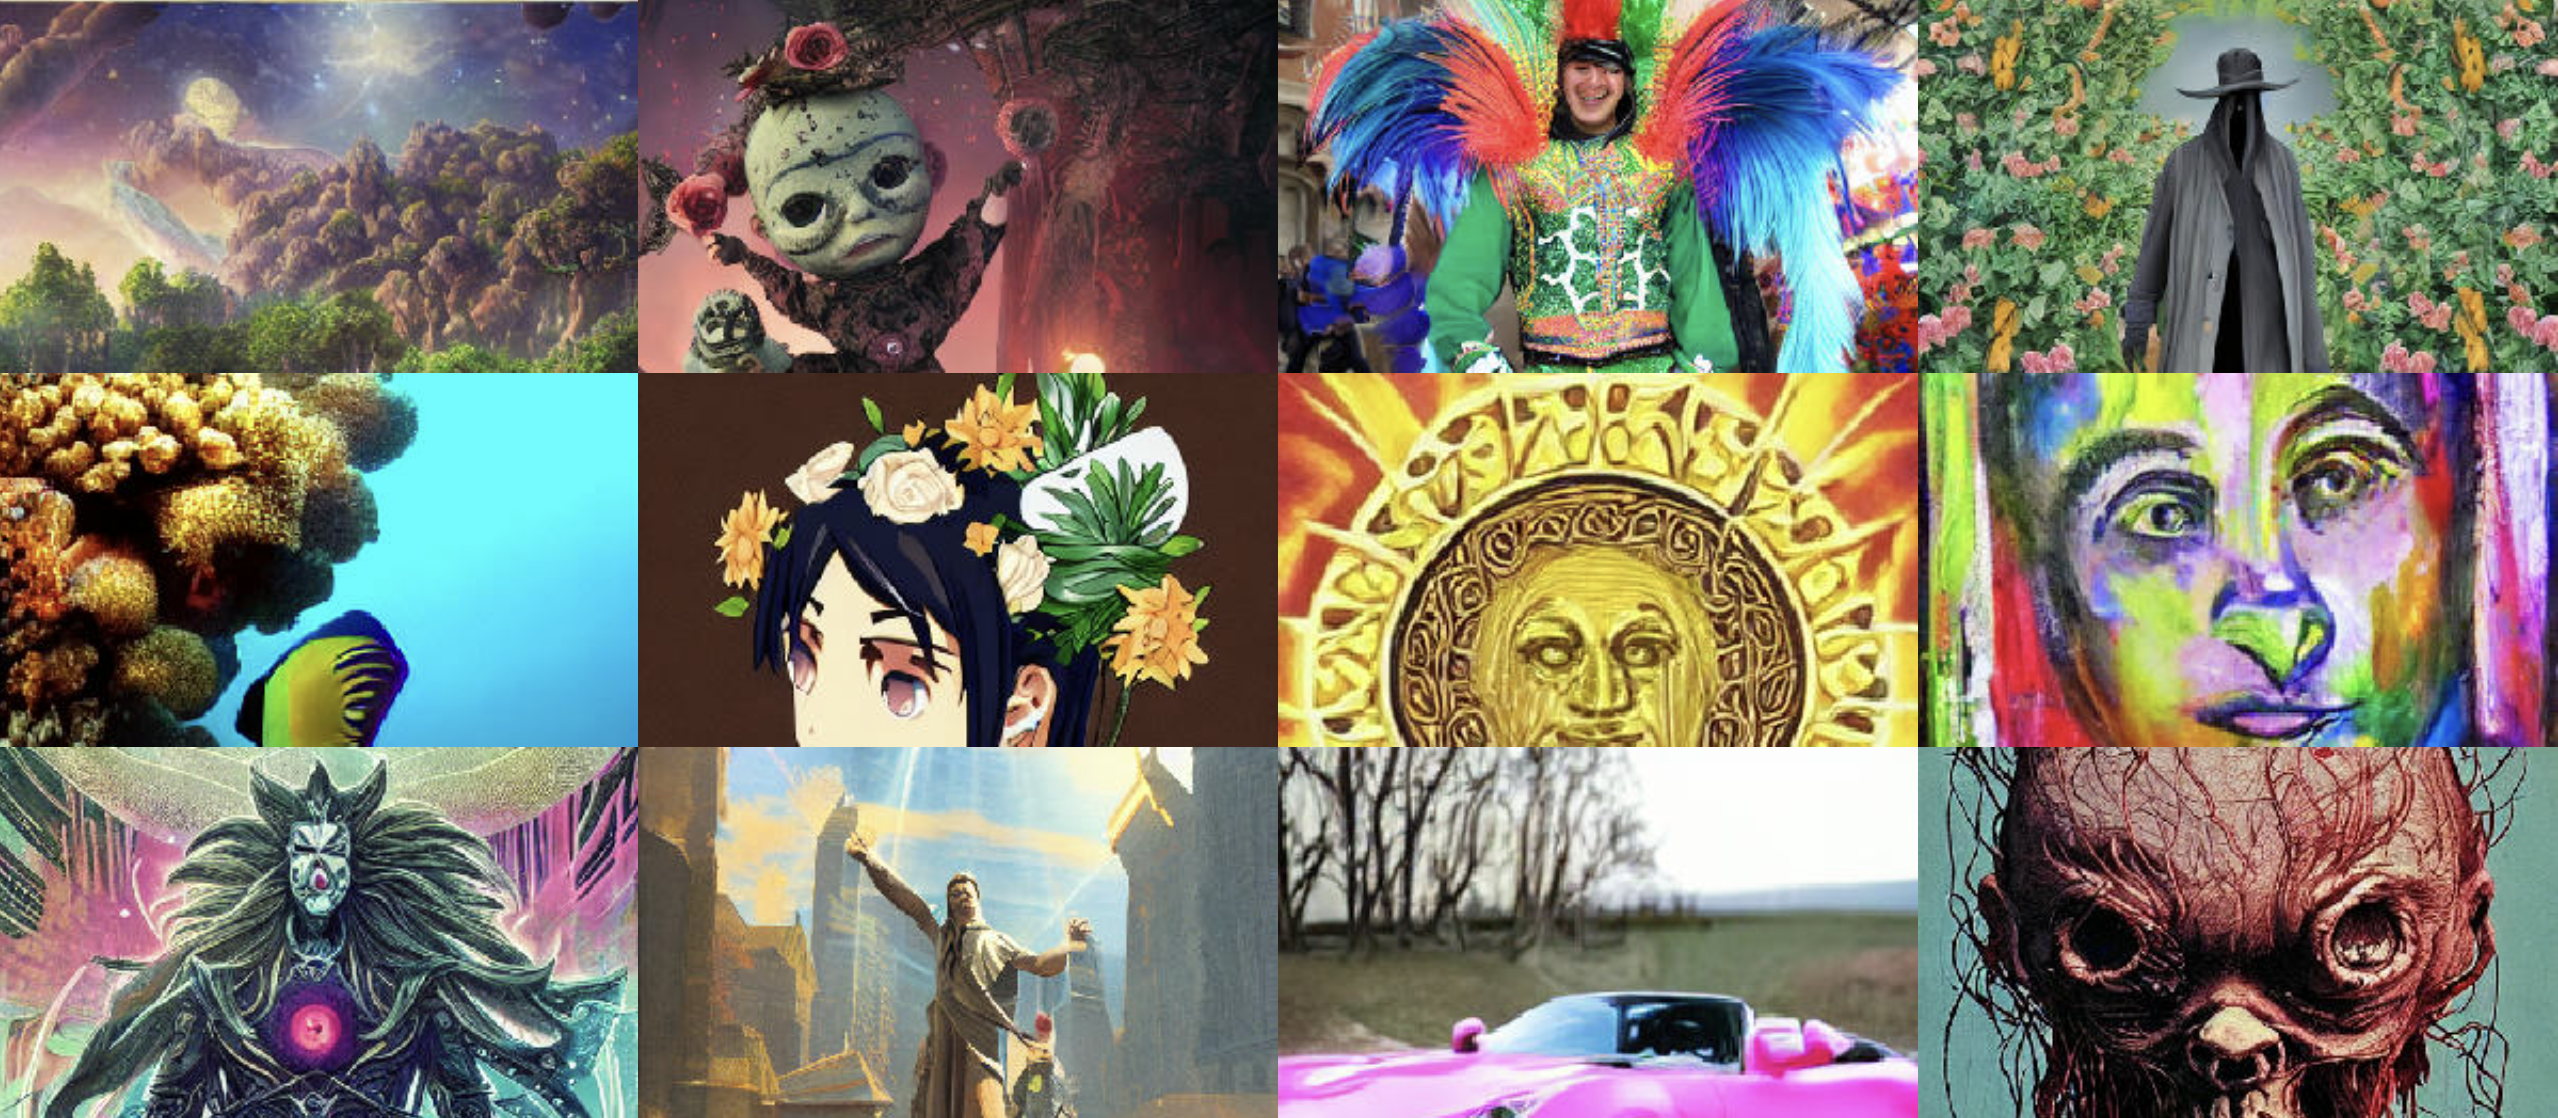
I creatori di SAC hanno evidenziato chiaramente i limiti del dataset, in particolare rispetto al fatto che i punteggi sono stati forniti da utenti che appartengono a categorie WEIRD (Western, Educated, Industrialized, Rich, and Democratic) e da sviluppatori di arte AI, gruppi demografici che loro stessi descrivono come inclini a essere “nerd” ed “enigmatici”.
Ammettono inoltre che la maggior parte delle valutazioni nel dataset sono state fatte da un “ristretto gruppo di utenti”, le cui “preferenze estetiche dominano il dataset”.
Un altro dei dataset utilizza immagini valutate sul sito dpchallenge.com, che viene descritto come un “contest di fotografia digitale”.
Per il dataset Aesthetic Visual Analysis (AVA) sono state estratte dal sito 250.000 immagini e le relative valutazioni degli utenti.
Ecco un
campione delle immagini con le valutazioni più alte del set.
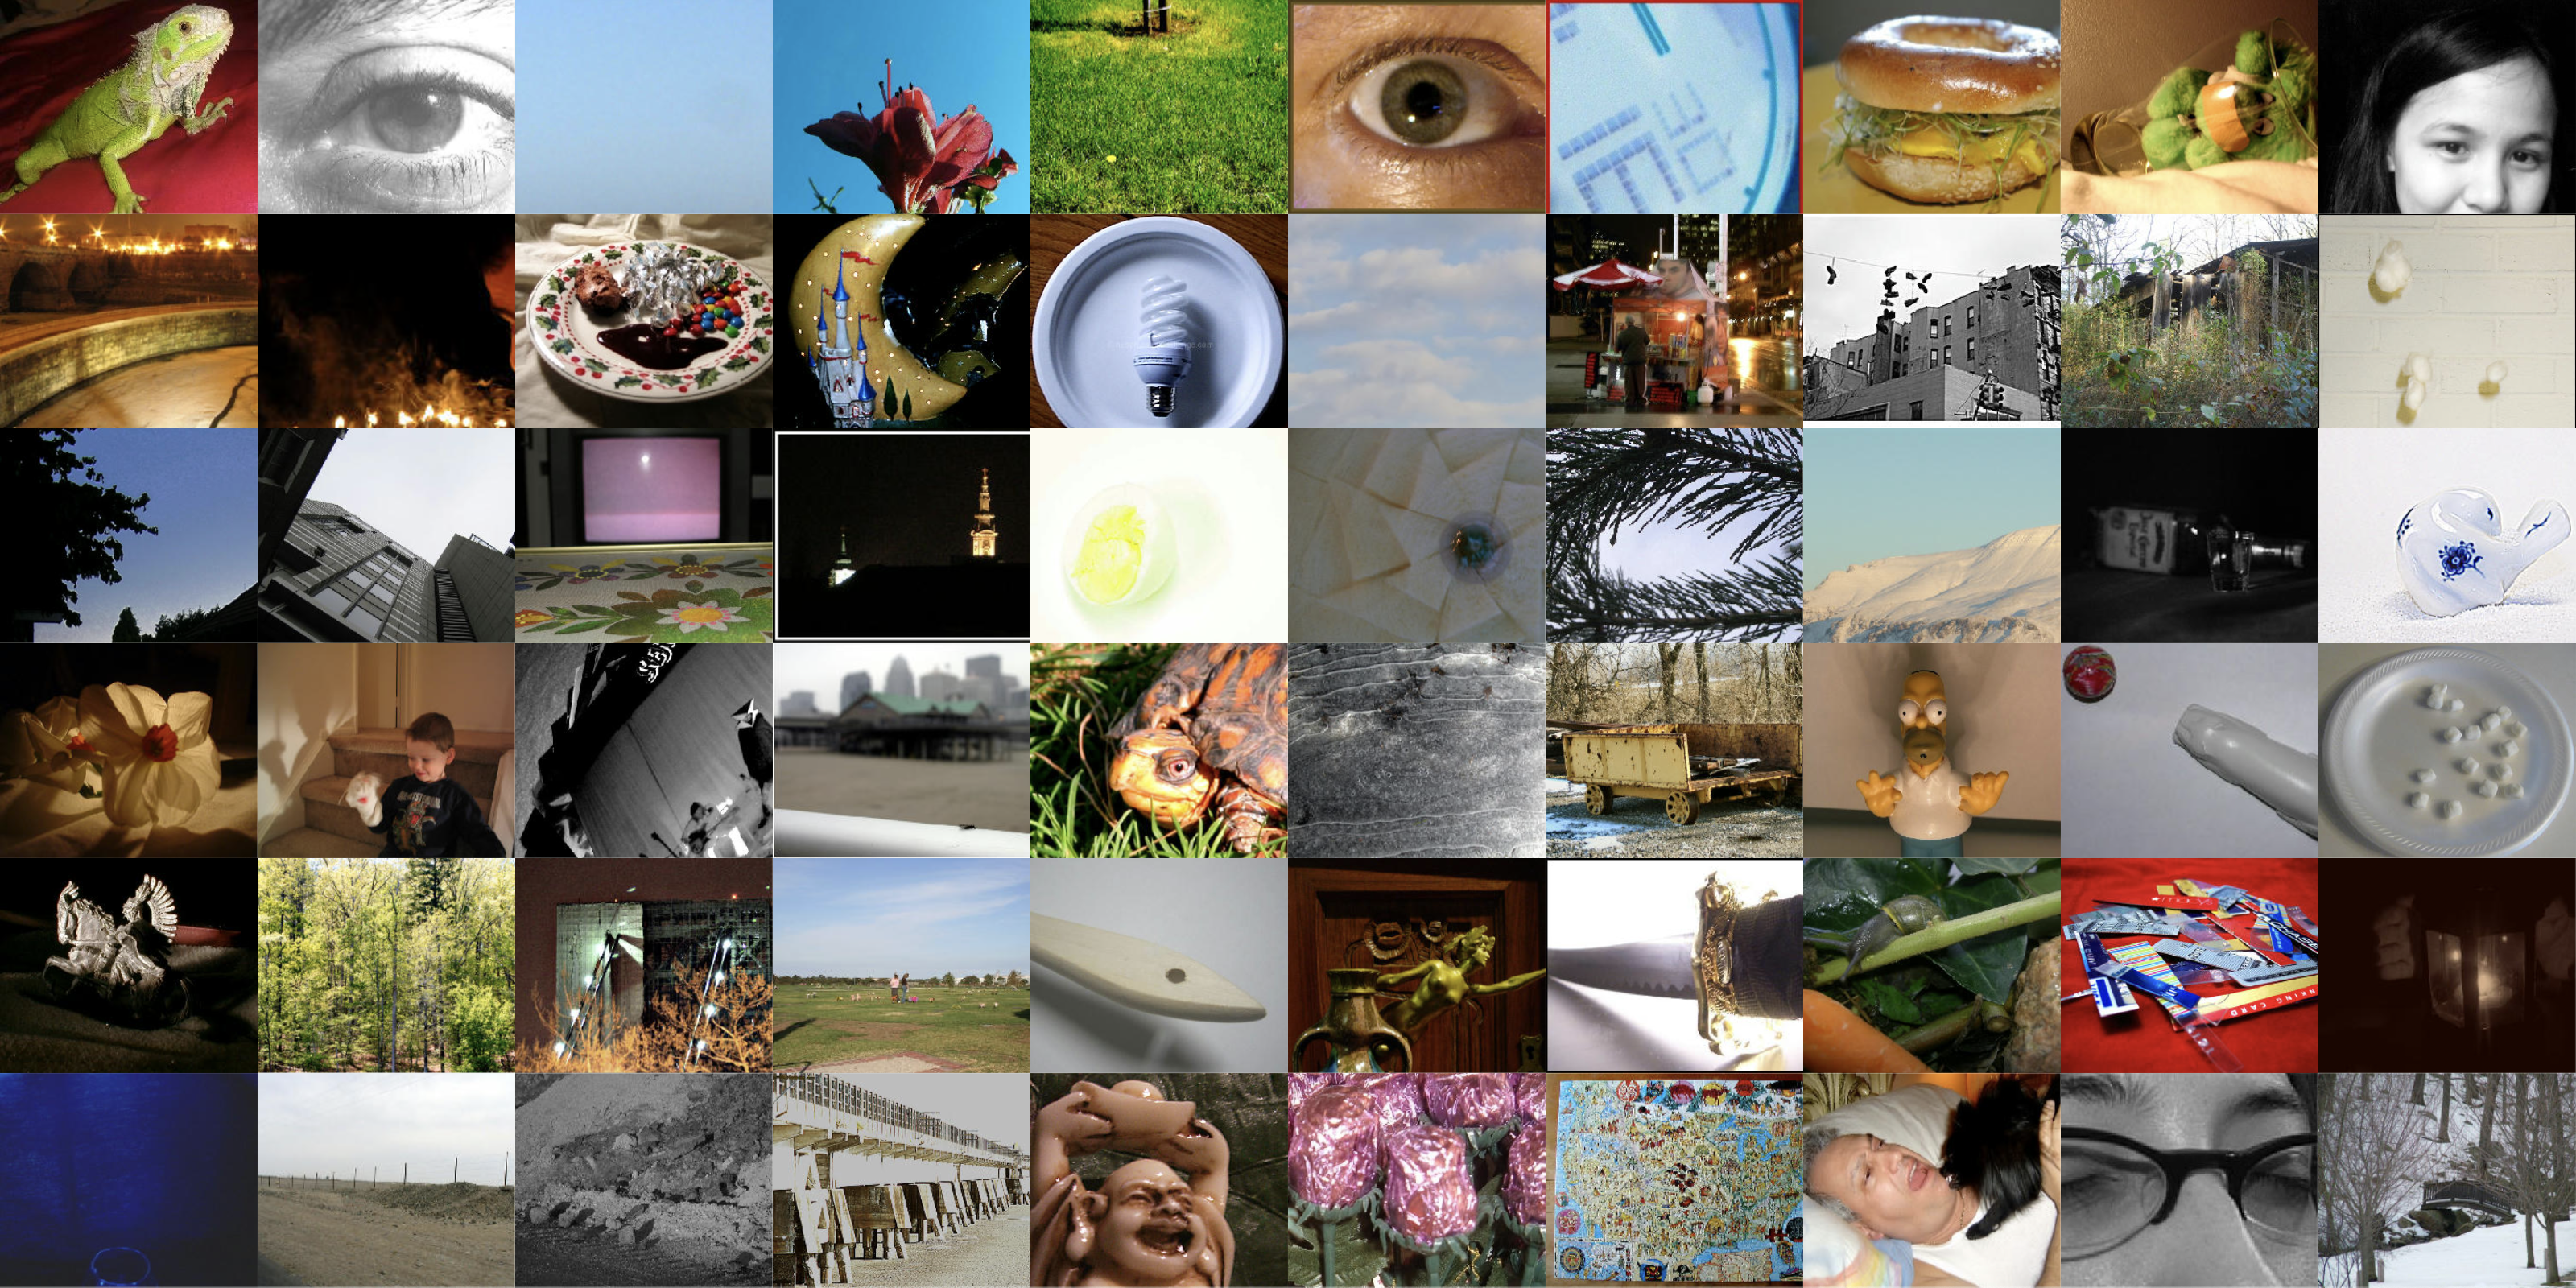
dpchallenge.com stila una classifica dell* revisor* di immagini.
Nella top 50, responsabili nel complesso di oltre 7,5 milioni di recensioni, ci sono persone che sembrano rientrare perfettamente nella demografia WEIRD.
Tra l* 41 utenti che condividono informazioni sulla loro posizione, il 95% si trova negli Stati Uniti, in Canada o in Europa. Sono in prevalenza appassionat* di fotografia di mezza età che vivono in piccole città americane.
Utilizzando il dataset SAC, le immagini di LAION-Logos e AVA, gli sviluppatori di LAION hanno addestrato un modello chiamato LAION-Aesthetics_Predictor V2.
Questo modello produce un punteggio estetico basato sull’output di analisi visiva del modello CLIP.
Il modello è stato utilizzato per valutare il dataset in lingua inglese (2,3 miliardi di immagini) e per rilasciare una serie di nuovi dataset con diverse soglie di valutazione.
Il più piccolo di questi sottoinsiemi – i 600 milioni di immagini che hanno ricevuto un punteggio pari o superiore a 5 – è stato utilizzato dal team di Midjourney per ottimizzare i risultati del loro modello con l’obiettivo di produrre output che risultassero più attraenti per l* loro utenti.
Ci troviamo di fronte a un’altra verità rispetto alle AI generative:
L’opinione rispetto a ciò che è o non è visivamente attraente può essere enormemente influenzata dai gusti di un gruppo molto ristretto di individui e dai processi per l’organizzazione dei dataset che vengono decisi dagli sviluppatori.
Nel caso di Midjourney il dataset è stato influenzato da un gruppo ristretto di “nerd enigmatici” e da un ingegnere meccanico di 65 anni che vive nel sud-est del Wisconsin.
Negli ultimi due anni i modelli di intelligenza artificiale generativa hanno costretto le persone a mettere fortemente in discussione le loro idee su proprietà e sicurezza.
All’origine di questo dibattito si trovano dataset come LAION-5B, i cui contenuti travalicano qualunque confine, etico e legale.
Il dataset LAION-5B chiama in causa questioni legate sia alla proprietà che alla sicurezza, sebbene con un approccio tipicamente statistico.
Per quanto riguarda la proprietà di immagini, il dataset LAION-5B offre un punteggio che indica la probabilità che l’immagine contenga un watermark e segnala la presenza di contenuti NSFW .
Queste metriche sono state create utilizzando modelli generati da LAION. I ricercatori ammettono che questi modelli “non sono perfetti”.
Torna ancora una volta l’avvertimento: queste misure non dovrebbero essere utilizzate per creare sottoinsiemi “pronti all’uso”.
Si tratta di una scappatoia per evitare qualsiasi responsabilità e si fonda in modo evidente su uno dei pilastri della ricerca basata sul software: se rendi visibili i problemi, qualcuno poi tenterà di risolverli.
Nel loro paper, il team di LAION “raccomanda di utilizzare questi tag in modo responsabile”, senza affidarsi ad essi per produrre versioni “veramente sicure” del loro dataset.
Oltre a questo, non viene fornito nessun altro consiglio su quale dovrebbe essere un utilizzo responsabile.
Un uso responsabile potrebbe iniziare con un’analisi più attenta di come questi punteggi siano collegati ai contenuti delle pagine da cui sono state raccolte le immagini e le caption.
C'è una cosa in particolare che va riconosciuta a LAION: pubblicano i propri dataset come open-source.
Nel campo delle intelligenze artificiali sono gli unici a farlo. È questo che ci ha permesso di dissezionare LAION.
La trasparenza è importante nel campo dell'AI, non solo per individuare i bias nei modelli, ma anche per individuare quelli strutturali nell’ecosistema. Un problema persistente è che l’organizzazione e la gestione dei dataset basata su di un approccio statistico amplifica enormemente questi tipi di bias.
Sostenuti da investimenti miliardari, i dataset e i modelli di AI, troppo complessi o vasti per essere realmente analizzati, vengono implementati con una velocità vertiginosa.
L’analisi dei dataset è uno dei pochi strumenti a disposizione di accademic*, professionist* o giornalist* per comprendere e ottenere previsioni sui sistemi più complessi mai concepiti dagli esseri umani.
Per questo pretendere la trasparenza sui dataset è cruciale, se vogliamo immaginare un futuro sostenibile per i sistemi AI.
LAION-5B non è più disponibile per il download da quando, nel dicembre 2023, sono emerse le analisi relative al CSAM.
Gli sviluppatori affermano di essere al lavoro per risolverne i problemi.
Nel frattempo hanno rilasciato CommonPool, un nuovo dataset di immagini e testi che contiene 12,8 miliardi di coppie di immagini.
12,8 miliardi di abbinamenti di immagini estratte da Common Crawl.
12,8 miliardi di abbinamenti di immagini valutate da CLIP.
12,8 miliardi di abbinamenti di immagini selezionate e organizzate su base statistica.
[Testo originariamente pubblicato in AI & Conflicts. Volume 2, a cura di Daniela Cotimbo, Francesco D'Abbraccio e Andrea Facchetti. Brescia: Krisis Publishing, 2025. Titolo originale: “Models All The Way Down”, knowingmachines.org]