Uno dei modi cruciali in cui oggi il mondo viene compreso e costituito è attraverso i media computazionali. Ciò crea condizioni interessanti sia per l’investigazione sia per un’estetica estesa. Algoritmi, dati e altre strutture formali dell’informatica sono formazioni estetiche. Il machine learning, ad esempio, in quanto tecnologia di sensibilizzazione, di rilevazione e di calcolo e organizzazione delle differenze significative, può svolgere un ruolo all’interno dell’estetica investigativa.
Gli eventi avvengono sempre più nei media e come media – in media res , come direbbe Wendy Hui Kyong Chun. Questo è inevitabile nell’ambito computazionale, dove gli eventi accadono all’interno di logiche algoritmiche e della loro composizione reticolare, e in queste vengono trasposti. Ciò può comportare che un evento sia articolato come parte di una rete, strutturato attraverso siti e processi, che si svolga su molteplici scale, velocità e durate temporali, coinvolgendo potenzialmente una miriade di attori e forme di codifica.
L’integrazione di scale nei sistemi computazionali – dalle azioni altamente granulari inscritte in pattern specifici fino alle immense categorie di dati generate on the fly o che riproducono e consolidano categorie sociali di lungo periodo – porta con sé e rinnova problematiche storiche legate alla discriminazione e ad altre formazioni politiche. Ci sono diversi modi in cui ciò avviene, e gli studi sulle distorsioni sociali – in particolare bias razziali insiti o appresi da tecnologie come il machine learning hanno dato origine a inedite forme di investigazione .
Uno dei riscontri più evidenti è spesso che c'è “qualcosa che non va nei dati", dando luogo al vecchio problema noto come garbage in, garbage out. Se un sistema contiene dati tendenziosi non fa che replicare tali distorsioni, se non perfino amplificarle. Gli errori nei dati possono assumere molte forme diverse, inoltre, un sistema che ha appreso a discriminare ingiustamente, sia attraverso l'addestramento sia per percezioni consce o inconsce incorporate nel modello stesso, può essere applicato in altri contesti, rafforzando ulteriormente le disuguaglianze.
Un secondo problema è che sistemi come il riconoscimento facciale possono essere addestrati per funzionare meglio su determinati colori della pelle e geometrie dei volti . Questo può talvolta comportare un’esclusione funzionale quando, ad esempio, il tuo telefono cellulare o l’ingresso del tuo luogo di lavoro non sono in grado di riconoscere il tuo volto. Possono forse derivarne benefici collaterali qualora quei sistemi utilizzati dalla polizia non riconoscano la tua presenza.
In terzo luogo, vi è il problema assai semplice dell’iper-attenzione: la sorveglianza mirata rivolta intenzionalmente a determinate comunità, aree geografiche o attività. Questo si aggiunge alla pressione, esplicita e implicita, della vita quotidiana, e si intensifica durante determinati processi, come l’attraversamento di un confine. Questa condizione si lega a un problema poco riconosciuto nelle politiche del trattamento e della soggezione ai processi. Le tecniche di quella che si può definire “politica della vessazione” consistono nell’essere trattenuti in uno stato di continua soggezione a varie fasi di processualizzazione e di scrutinio. Ogni aspetto della vita è gravato dall’applicazione di quelli che gli economisti neo-istituzionali definirebbero “costi di transazione” . L’ampliato managerialismo del capitalismo avanzato e della dominazione coloniale distribuisce la vessazione in un’economia diseguale dell’entropia .
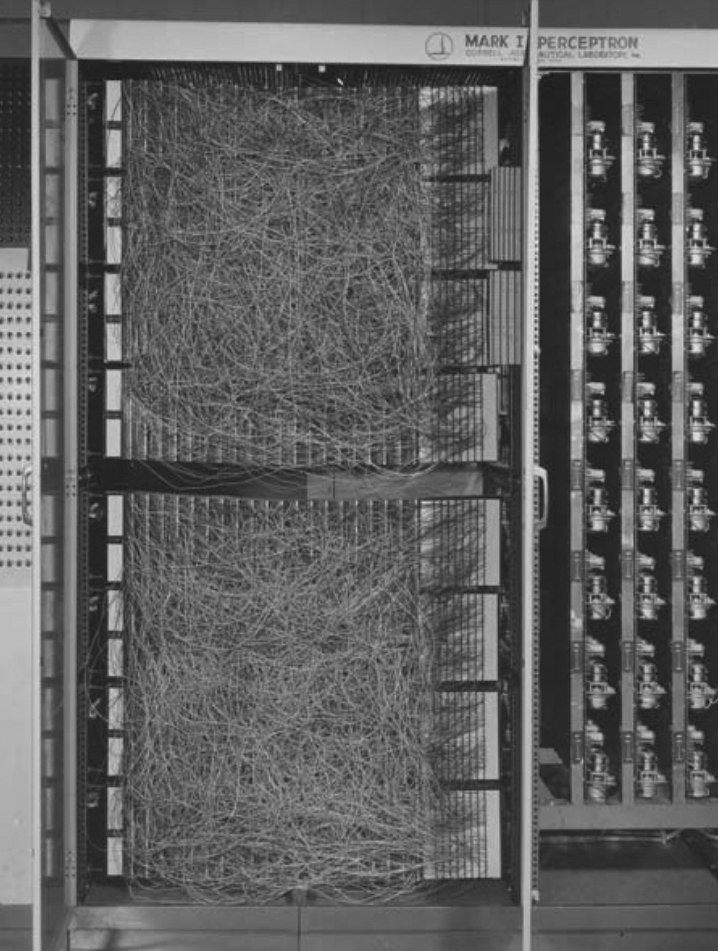
In quarto luogo, i processi di ragionamento incorporati in tali sistemi si fondano o fanno affidamento su strutture logiche che, in modo implicito o esplicito, impongono determinate ontologie. Questo era autoevidente nelle prime forme di intelligenza artificiale, in cui il ragionamento top-down regnava sovrano, con tutto il suo potenziale di distorsioni e fallacie intrinseche. Quel tipo di intelligenza artificiale si basava spesso su strutture logiche ben definite per automatizzare le decisioni, ma naufragava nella difficoltà di renderle applicabili al di fuori di ambiti circoscritti. Il machine learning, rinascita delle tecniche di reti neurali, si propone di riuscire laddove il precedente programma di ricerca aveva incontrato i propri limiti, aggirando i colli di bottiglia del significato attraverso l’impiego dell’apprendimento stesso.
Questo dà origine al “problema della scatola nera”, quando un algoritmo addestrato non è in grado di descrivere ciò che ha appreso né i principi secondo cui opera . Un quinto problema consiste nel fatto che le ingenti risorse e la potenza dei sistemi attualmente impiegati, e di quelli in fase di sviluppo, tendono a consolidare le posizioni delle lingue, delle culture e delle formazioni politiche dominanti, poiché sono queste le più processate, le più accessibili e le più diffuse.
In ambito informatico, è necessario fare un passo fuori dalle logiche e dalle strutture della ragione che hanno caratterizzato il patriarcato, il colonialismo e la militarizzazione, nonché molti aspetti delle diverse fasi del capitalismo e della sua deriva ecocida. Lo sviluppo di sistemi di ragionamento e valutazione più adeguati a una concezione più ampia della vita su questo pianeta richiede una rielaborazione dell’estetica del senso automatizzato e della produzione automatizzata di senso.
È però altrettanto necessario vigilare sull’impiego tattico di un’etica deliberatamente debole in relazione a tali sistemi. Per etica debole si intende una forma ridotta e funzionalista di etica, concepita per garantire la continuità delle pratiche aziendali e per scongiurare qualsiasi regolamentazione delle attività delle imprese tecnologiche. Infatti, “l’etica” è divenuta talmente strumentalizzata da parte delle aziende, nel tentativo di “promuovere” il proprio profilo, da essere talvolta impiegata per segnalare che una determinata tecnica viene “trattenuta” per timore delle sue conseguenze qualora fosse liberata – una strategia che finisce per alimentare l’enfasi sulla tecnologia piuttosto che affrontare il potenziale problema. Persino i produttori di armi chiedono oggi di integrare maggiormente l’etica nell’uso delle armi autonome. Uno di questi produttori ha persino recentemente auspicato che un numero maggiore di studenti delle scuole superiori venga formato in filosofia, al fine assicurare una forza lavoro stabile e adeguatamente istruita di futuri operatori e supervisori delle operazioni militari . Forme meccaniche di utilitarismo possono essere codificate algoritmicamente per autorizzare “mali minori”, ricevendo il placet del controllo qualità da parte di diplomati impiegati nei call center militari.
Tali forme di etica autoreferenziali tendono a concentrarsi sulla minimizzazione delle basi per la responsabilità riguardo alle conseguenze delle nuove tecnologie. Spinte dalla necessità di mantenere l’autoregolamentazione delle aziende contro l’idea di un controllo socializzato, le loro coordinate di riferimento sono formulate più secondo la logica profilattica della valutazione del rischio tipica di una compagnia assicurativa, che non secondo i presupposti di un autentico confronto etico. Quest’ultimo implicherebbe trasformazione e apprendimento. Troppo spesso, infatti, l’“etica degli algoritmi” si presenta come una forma accondiscendente, se non addirittura complice, nascosta nei termini di quel liberalismo umanista che camuffa e struttura gran parte della tecnocultura.
Discipline come i software studies, che includono aspetti investigativi, tra altri approcci, mirano a porre interrogativi più profondi sulla natura e sulle azioni del software. Stabilire regole esplicite per la governance di sistemi normativi che generano operazioni non esplicitate è un’impresa senz’altro degna di essere intrapresa. Tuttavia, ciò che deve essere effettivamente progettato è l’autentico incontro etico. Un simile incontro porterebbe alla dismissione di molti dei sistemi che un’etica così industrialmente debole tollera e protegge.
Date le molteplici linee di conflitto che attualmente attraversano il campo dell'informatica, è inevitabile che essa diventi uno spazio di indagine. Le forme che questa assunzione sta prendendo sono svariate: dalla sperimentazione hacker sulle strutture e sugli accessi, o la divulgazione di file, fino all’esplorazione sistematica delle geometrie dello spazio–tempo–informazione–politica così come vengono articolate dai sistemi digitali su larga scala. In effetti, uno dei primi ambiti dell'investigazione macchinica è stato proprio l'esame programmatico delle macchine stesse. Spesso, tale lavoro assume la forma di una procedura, creando meccanismi attraverso cui un sistema possa essere testato passo dopo passo, con migliaia di varianti, al fine di ricostruire tramite reverse engineering la logica computazionale che sottende i contorni del suo potere e renderli accessibili a un’indagine collettiva. Tale attività si è intensificata negli ultimi anni e sembra destinata a diventare uno strumento costante per chiamare il potere algoritmico a rendere conto di sé.
Parte di questa ingegneria investigativa può essere realizzata anche ridisegnando il diagramma politico di spazio–tempo–informazione, il che comporta una sfida fondamentale alle digital enclosures. Un modo per entrarvi passa per il differenziale di accesso e di informazione: quali dati, su chi, sono open-source per chi o per che cosa? Come invertire o almeno riassestare il diagramma? Abbiamo bisogno di molti Angeli per trasformare il segreto macchinico in dati aperti e di molti Gatti per ricomporne i frammenti. L’uno non funziona senza l’altro. In realtà, sono più interdipendenti di quanto sembri. È necessario sia aprire la fonte di chi mantiene il codice chiuso (l’Angelo), sia collegare i puntini quando tale codice viene riversato (il Gatto).
L’arte del leak e l’investigazione dei materiali trapelati, però, richiedono capacità crescenti. A questo scopo, l’automazione della percezione e della costruzione di senso può risultare vantaggiosa. Ciò esigerà anche ulteriori metodi per accordare l’indagine alle proprie condizioni mediatiche: alcuni di questi metodi sono di natura matematica, altri lo diventano nel processo di mediazione. Man mano che le traduzioni del mondo in numero acquisiscono una loro efficacia, esse cominciano a circolare come entità autonome nel mondo, in quanto tali. I loro precursori storici si rintracciano in dispositivi che orientano modi di pensare e agire, quali calendari, modelli architettonici o le funzioni delle catene di montaggio modulari. I simboli e le strutture numeriche iniziano anche ad agire come sostituti di entità, o di catene di altre entità, fino a rimpiazzarle, talvolta, come oggetti di conoscenza ed esperienza.
Ad esempio, consideriamo il modo in cui si identifica l’immagine di un carro armato in un filmato. Nell’intelligenza artificiale simbolica classica, il carro armato verrebbe compreso come un simbolo, o come un cluster di simboli, annidati all’interno di un sistema di altre strutture simili (modelli di orientamento e di localizzazione rispetto a un insieme di volumi tipici, e di colore – forse inteso come un insieme di tre dimensioni: tonalità, saturazione e luminosità). Verrebbe definito attraverso una descrizione concettuale esplicita e razionalmente determinata della forma e delle caratteristiche di un carro armato. L’aspetto fondamentale è che il carro armato, o un oggetto analogo, verrebbe descritto in anticipo rispetto all’incontro del sistema con esso.
Questo si contrappone ai più recenti approcci basati sul machine learning. Qui, un insieme di fenomeni visivi che corrispondono a una maggiore probabilità che un’entità venga diagnosticata come un carro armato emerge dal processo di addestramento. Attraverso l’esposizione ripetuta a un fenomeno in condizioni diverse, si mira a creare un insieme di risposte sufficientemente stabile, tale per cui una decisione riflessiva possa trasformarsi in un riflesso.
Uno degli elementi di fascino dell’approccio simbolico risiedeva nell’immaginare un mondo ordinato in modo pulito, gerarchico e categoriale – qualcosa che facilitava flussi costanti di finanziamento da parte di fonti militari, inclini a questo tipo di visioni. Questo immaginario è stato in parte abbandonato. Tuttavia, lo stile più emergente e “caotico” della genealogia che dalle prime reti neurali conduce, ad esempio, a tecniche come il deep learning, possiede oggi un proprio tipo di carisma finanziario, ben rappresentato, ad esempio, dal motto di Facebook: Move fast and break things. Di conseguenza, anziché mirare a una visione sistematica di un problema prima di affrontarlo, molte iniziative aziendali contemporanee cercano di addestrare i propri computer riprogrammando la realtà stessa. Sono gli esseri umani, le strutture sociali e gli attori economici dominanti ad essere istruiti per adattarsi a nuove regole.
Un elemento chiave per la creazione di un deepfake convincente (in cui, ad esempio, immagini simulate del volto di una persona vengono sovrapposte al corpo di un’altra) è l’utilizzo di materiale sorgente con una risoluzione sufficientemente alta per il supporto di destinazione. Ciò richiede che il dataset utilizzato per l’apprendimento sia abbastanza ampio da permettere alla rete neurale di eseguire la mappatura necessaria per generare, in output, le espressioni facciali richieste.
Attualmente, ad esempio, è difficile produrre deepfake video di buona qualità di personaggi storici. Questo perché non esistono abbastanza filmati con una risoluzione adeguata e perché tali materiali sorgente sono piuttosto rari. È necessario estrapolare elementi da questi filmati per poterli mappare su riprese contemporanee, evitando che le tracce lasciate dai diversi tipi di elaborazione risultino rilevabili. Al contrario, coloro che compaiono frequentemente nei media contemporanei contribuiscono a un dataset in continua espansione, fatto di ore o giorni di filmati, che li rende più facilmente riproducibili in forma di deepfake. Ogni nuovo angolo o espressione facciale rende possibile un’ulteriore proliferazione.
Esiste anche un problema inverso, ma correlato. Spesso, gli eventi oggetto d’investigazione coinvolgono entità rare, come sistemi d’arma insoliti. Le armi e le munizioni vietate sono difficili da trovare come rappresentazioni online. Le immagini di questi oggetti – ad esempio, bombe chimiche particolarmente rare ma cruciali da individuare – sono quantitativamente insufficienti per addestrare una rete neurale, poiché esistono pochissimi esemplari reperibili, se non nessuno. Le immagini che effettivamente esistono sono spesso di bassa risoluzione – talvolta perché le immagini dei conflitti vengono controllate nell’ambito delle operazioni militari.
Abbiamo incontrato questo problema in forme diverse in due investigazioni. La prima riguarda l’indagine open-source condotta da Forensic Architecture sulla battaglia di Ilovaisk del 2014, nell’Ucraina orientale. Alla Russia veniva imputata l’invasione del territorio ucraino e il sostegno militare ai separatisti, ma Mosca aveva sempre negato tali accuse . I tentativi di analizzare decine di migliaia di filmati caricati online alla ricerca di prove si sono scontrati con il problema del lavoro, del tempo e delle risorse necessarie. Poiché gran parte del materiale che i ricercatori si trovano a esaminare risulta irrilevante, Forensic Architecture ha cercato di capire se parte di quel processo potesse essere automatizzata, risparmiando così tempo prezioso. Abbiamo utilizzato classificatori di visione artificiale, addestrandoli a riconoscere un modello specifico di carro armato, il T-72B3, utilizzato esclusivamente dalla Russia .
Sono stati selezionati video pubblici su YouTube in base a un insieme di termini di ricerca e a un intervallo di date rilevante per la battaglia. Il software scaricava e analizzava questi video, fotogramma per fotogramma, segnalando poi quelli che potevano contenere carri armati. Evidenziava un fotogramma statico e informava il ricercatore che vi era, ad esempio, una probabilità del 64% o del 28% che contenesse un carro armato. Insieme alla raccolta manuale di prove open-source, abbiamo identificato 150 episodi distinti di presenza militare russa, supportati da migliaia di fonti. Il caso rappresenta il primo esempio di prove presentate davanti alla Corte Europea dei Diritti dell’Uomo basate, in parte, su tecniche di machine learning.
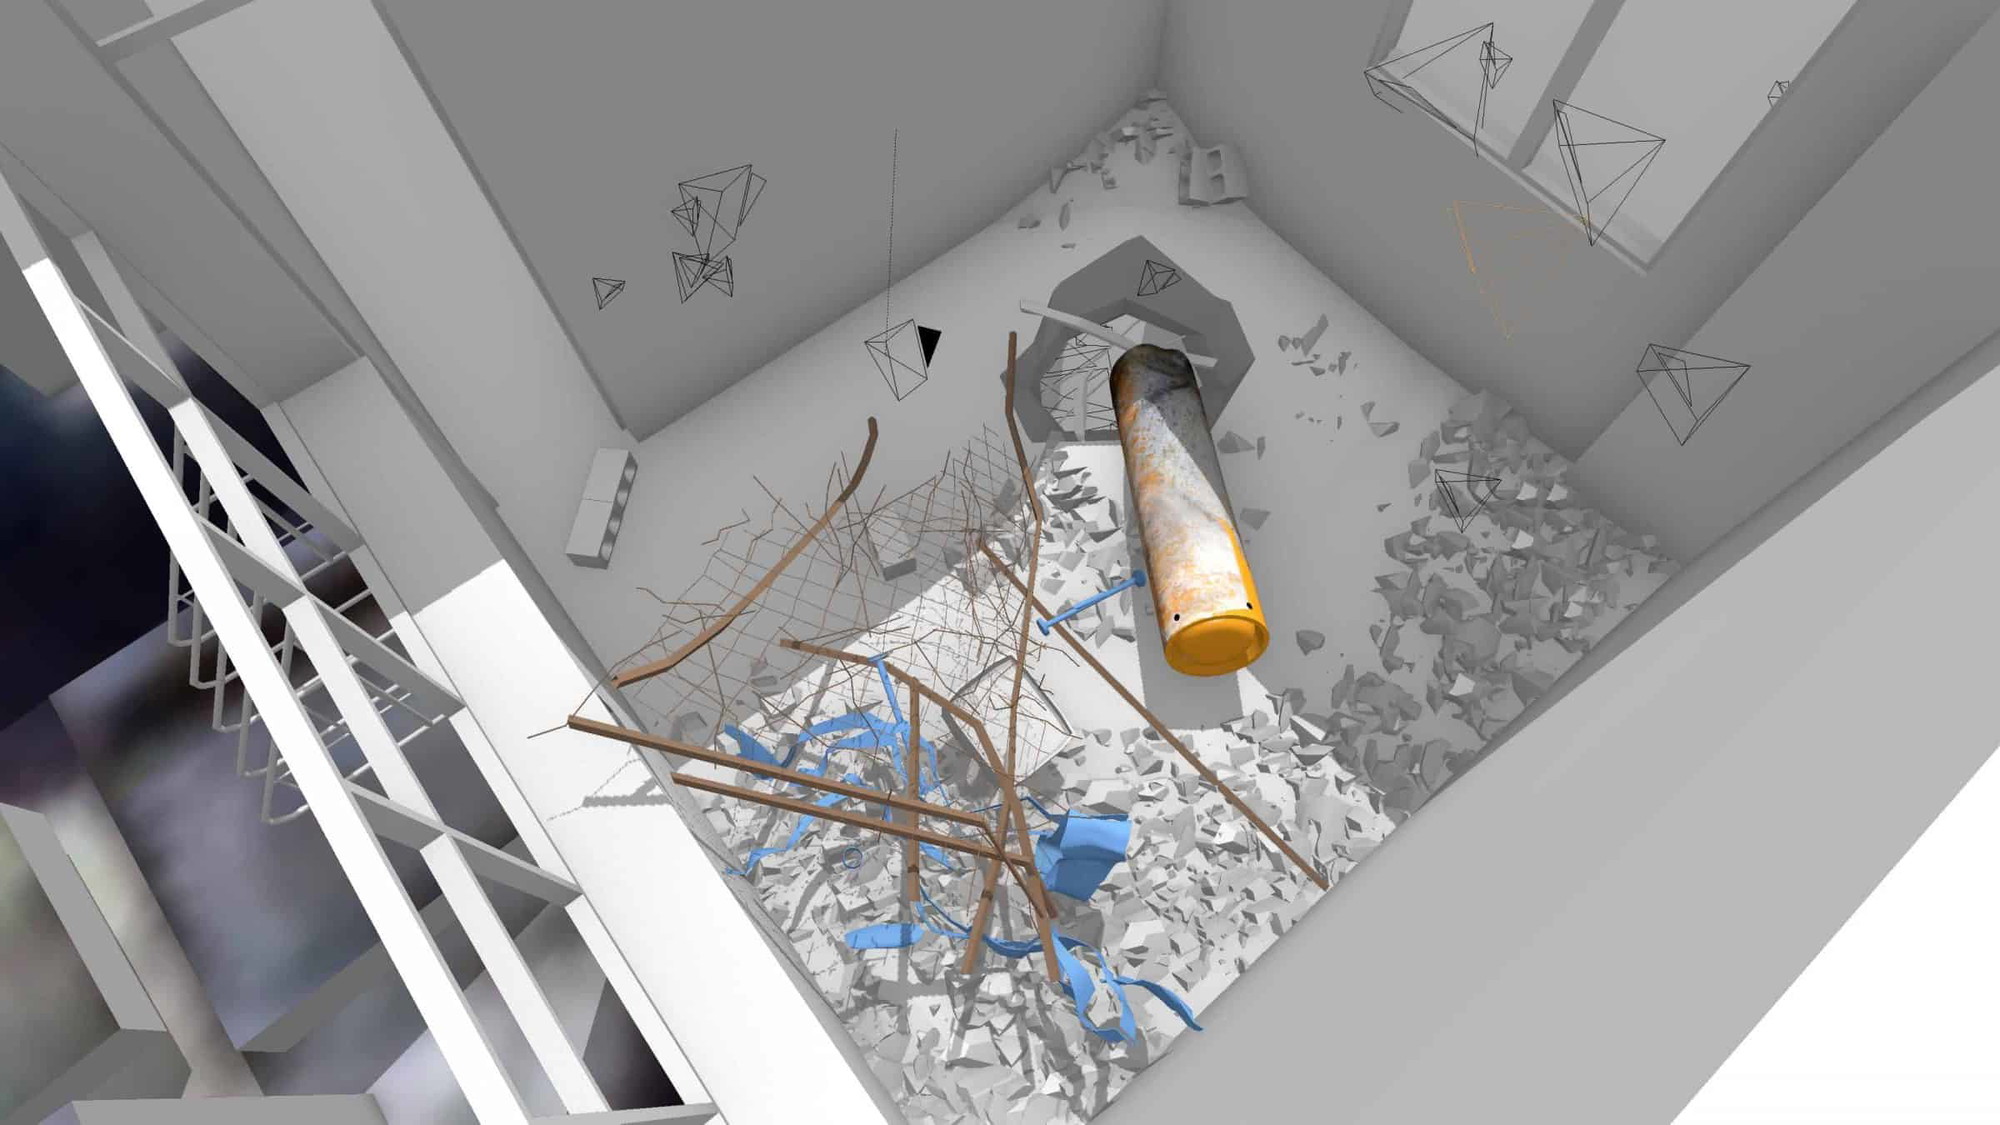
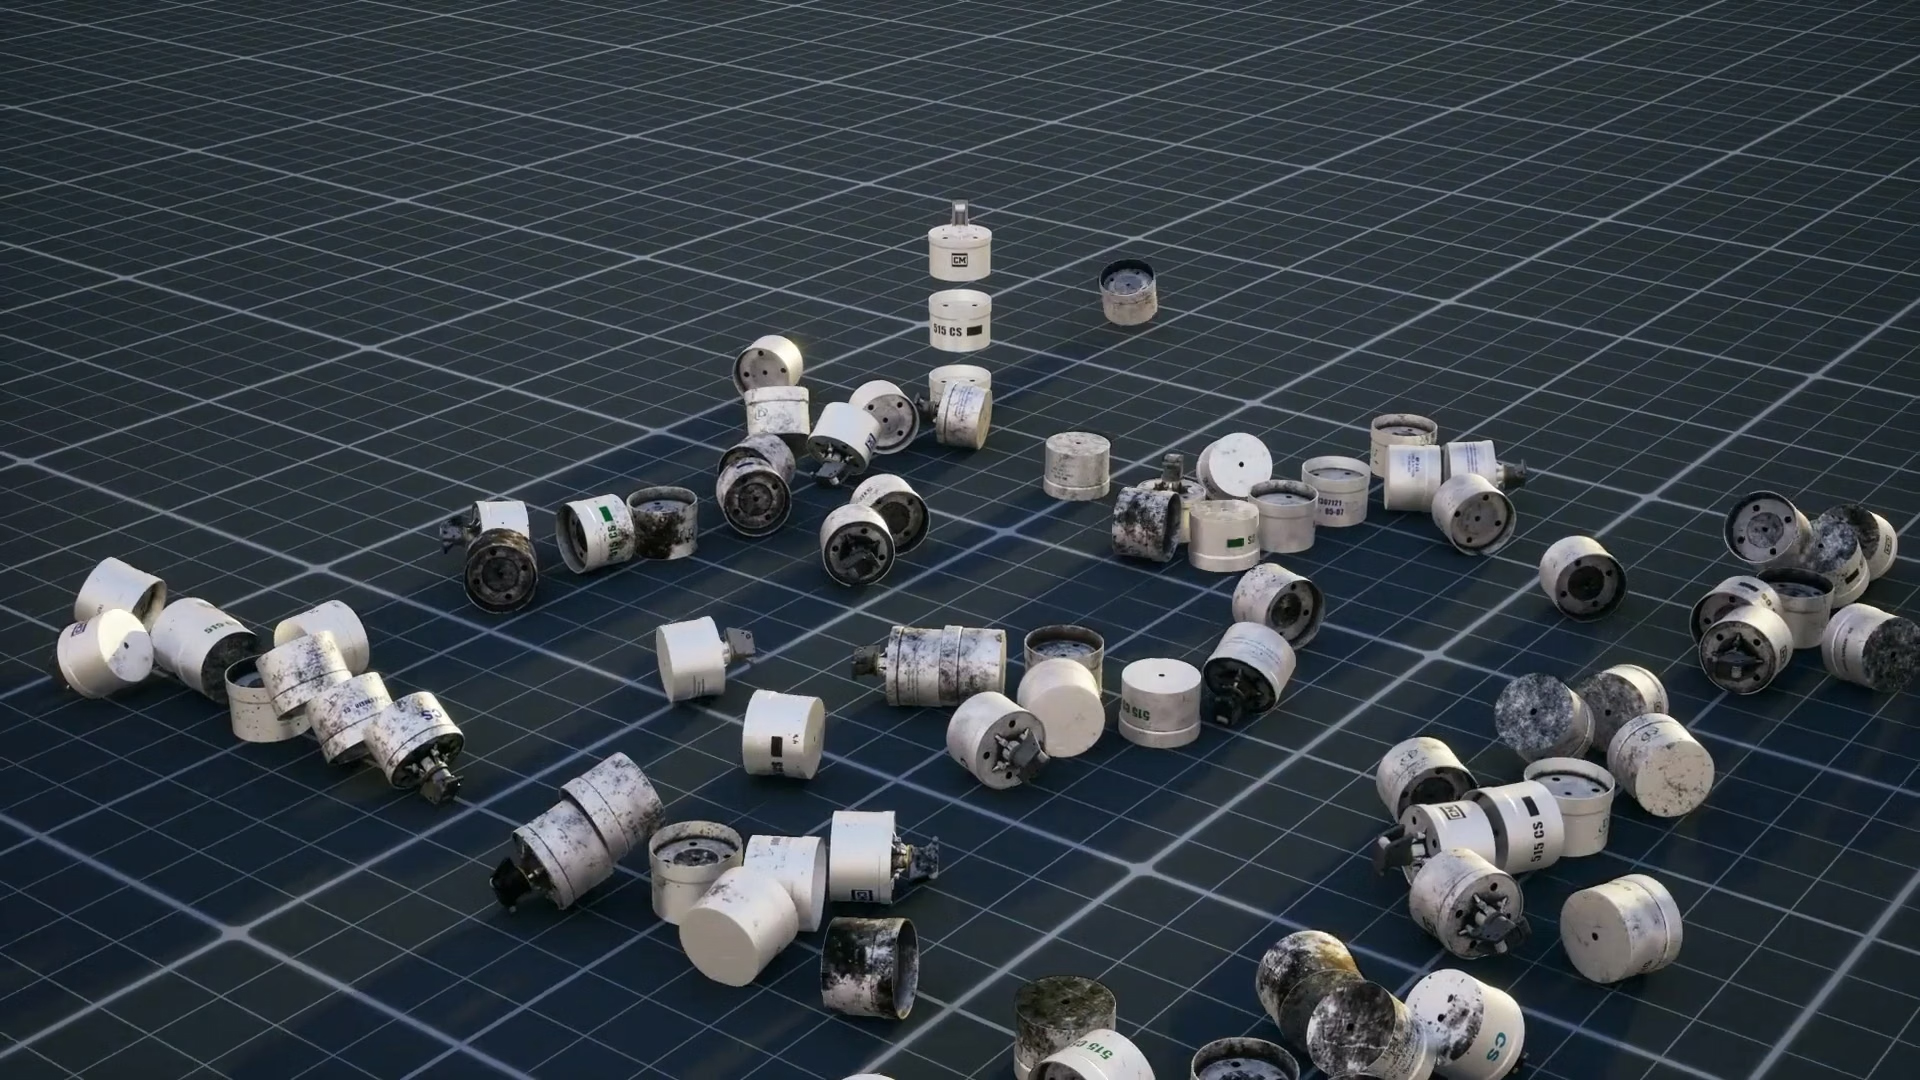
In un altro caso, per affrontare il problema della scarsità di dati visivi e al contempo utilizzare il machine learning per risparmiare lavoro, Forensic Architecture ha sperimentato l’addestramento di classificatori su “dati sintetici". I dati sintetici vengono creati quando non vi è abbastanza materiale "rintracciabile in rete" – ossia nei canali aperti online – per addestrare una rete. In questi casi, si possono utilizzare dati che riproducono fedelmente ciò che si sta cercando, al fine di addestrare il sistema a riconoscere oggetti simili online. A partire da un accurato modello tridimensionale, si possono generare immagini digitali fotorealistiche e ad alta definizione di un oggetto, fornendo così alla rete neurale dati sufficienti per l’addestramento e il perfezionamento della sua capacità di rilevamento.
Il progetto Triple Chaser è stato una risposta all’invito rivolto a Forensic Architecture per partecipare alla Whitney Biennial del 2019. Si tratta di una mostra che si tiene presso il Whitney Museum di New York, e attorno alla quale era sorta una controversia: Warren B. Kanders, un venditore d’armi, ricopriva la carica di vicepresidente del consiglio direttivo del museo. Collaborando con la regista Laura Poitras e il suo collettivo Praxis Films, Forensic Architecture ha addestrato dei classificatori di visione artificiale per rilevare filmati contenenti un tipo specifico di granata lacrimogena. Questo tipo, marchiato Triple Chaser, è prodotto dalla Safariland, l’azienda di Kanders, ed è utilizzato dalla polizia e dall’esercito in diversi paesi per reprimere con violenza le proteste e il dissenso. Immagini video o fotografiche di questo lacrimogeno compaiono occasionalmente tra i milioni di immagini condivise online in tutto il mondo.
L’addestramento di un classificatore di visione artificiale affinché identifichi in modo affidabile un oggetto specifico richiede di norma centinaia, se non migliaia, di immagini di quell’oggetto ripreso da molteplici angolazioni. Tuttavia, le immagini del lacrimogeno Triple Chaser sono relativamente rare. Per colmare questa lacuna, è stato costruito un modello digitale del lacrimogeno ed elaborato graficamente da molteplici prospettive. Queste, a loro volta, sono state collocate in migliaia di ambienti generati arbitrariamente o in ambienti fotorealistici “sintetici", ricreando le situazioni in cui i lacrimogeni vengono documentati nelle immagini generate dagli utenti. In questo modo, le immagini sintetiche create da Forensic Architecture hanno permesso alle reti neurali, addestrate su di esse, di cercare immagini dei lacrimogeni reali in uso. Questo software è tuttora in fase di sviluppo, ma è anche operativo, monitorando Internet, in modo che, quando le munizioni Safariland vengono impiegate contro i civili e ne vengono scattate immagini, queste possano essere segnalate.
Il carro armato e il lacrimogeno Triple Chaser sono al centro di ciò che Forensic Architecture definisce uno “zoo di modelli”, un numero crescente di classificatori sintetici basati su rendering digitali fotorealistici di modelli 3D di oggetti. Questi includono altri lacrimogeni, veicoli militari e della polizia, munizioni vietate, bombe chimiche: un catalogo di alcune tra le armi più raccapriccianti utilizzate dagli stati nei conflitti odierni. Questa collezione è stata creata sia perché esistono pochissime immagini di questi oggetti, ma anche perché il processo di raccolta e annotazione di tali immagini può essere estremamente oneroso in termini di lavoro . Creare uno "zoo" e rendere i contenuti accessibili in open-source, mira a fornire ad altri ricercatori i mezzi per addestrare i propri classificatori.
L’impiego del machine learning e dell’intelligenza artificiale nelle investigazioni sui diritti umani si rivela utile. Inoltre, controllare il processo di addestramento e poter correlare le variazioni negli input con gli output osservabili offre anche l’opportunità di analisi interna degli stessi sistemi di machine learning, per comprendere meglio i processi computazionali che li sostengono, processi che altrimenti risultano spesso opachi e non sottoposti a controllo. È la natura sottratta a responsabilità di molte implementazioni dell’AI a costituire una preoccupazione urgente per la società civile. Analizzare dall’interno l’algoritmo significa scrutare dentro la black box che, in misura crescente, sorveglia i nostri ambienti condivisi e tenta di definire la nostra posizione sociale, economica e politica. Nel perseguire metodologie basate sul machine learning, Forensic Architecture si trova così a investigare due condizioni simultanee: i luoghi della violenza e della repressione, dove le prove fisiche e fotografiche vengono contestate, e il campo computazionale dell’algoritmo, nel tentativo di decostruire e chiamare a rendere conto gli stessi strumenti di analisi.
Nel processo di analisi interna dell’algoritmo, Forensic Architecture ha iniziato a sperimentare con l’uso di variazioni estreme nei pattern, negli sfondi e nella forma degli oggetti modellati, per garantire che l’algoritmo migliorasse significativamente la propria capacità di identificare l’oggetto negli ambienti più comuni in cui esso viene fotografato o filmato.
Abbiamo appreso che i classificatori di machine learning che utilizzano render di modelli 3D, o dati di sintesi, possono ottenere prestazioni migliori quando esempi di addestramento includono variazioni estreme dell’oggetto modellato. Oltre alle variazioni sintetiche realistiche, abbiamo texturizzato i modelli delle armi che cercavamo con pattern e immagini casuali. Le variazioni estreme affinano le soglie della percezione e della riconoscibilità da parte della macchina, migliorando l’estetizzazione del classificatore rispetto alla forma, ai contorni e ai margini. Quanto più distintivi erano i tratti, tanto più efficace risultava il riconoscimento.
Questa scoperta solleva questioni importanti riguardo alla cultura algoritmica in generale. Per migliorare la propria capacità predittiva, potrebbe infatti essere nell’interesse di chi sviluppa classificatori per la predizione del comportamento, come le piattaforme di social media, riprodurre ed esasperare le estremizzazioni nello spazio dei dati in cui cercano di formulare previsioni. In altre parole, Facebook, Twitter e altri risultano più efficaci nel prevedere il comportamento degli utenti se questi sono estremamente differenti, e in modo evidente. Questo solleva una questione importante: mentre presumibilmente dichiarano di combattere per eradicare i comportamenti politici e sociali estremi online, le piattaforme di social media sono in realtà progettate per esacerbarli, dal momento che ciò rende i loro algoritmi predittivi più efficaci?
Nel contesto del machine learning, immagini e video sono considerati dati ad alta dimensionalità. Quando i classificatori setacciano insiemi di immagini, il rumore può spesso rappresentare un problema: qualcosa che appare significativo ma non lo è, oppure che ostacola il riconoscimento di ciò che è realmente rilevante. I problemi, in questo caso, sono ombre, occlusioni, distorsioni prospettiche, effetti di luce come i riflessi, e così via. Anche l’ambiguità può costituire una forma di rumore: quando la stessa forma può corrispondere a due oggetti molto diversi.
La dimensione informativa di un problema può emergere anche lungo le linee della custodia o della conoscenza dell’informazione, della sua elaborazione da parte di determinati dispositivi; oppure, tra le altre cose, attraverso la mappatura dei fenomeni in relazione alla loro percezione mediante specifici filtri, procedure, grammatiche d’azione e sensori.
Come alcuni dei suoi evangelisti potrebbero aver trascurato di menzionare, il machine learning non restituisce un blocco integro e non scalfito di calcoli pienamente sintetizzati. È attraversato da numerose linee di frattura, che derivano dalla sua relazione intrinseca con ciò che calcola e con le modalità attraverso cui lo fa. L’acuto libro di Adrian Mackenzie, Machine Learners, riconosce le «frizioni, i blocchi e i compromessi che spesso influenzano la pratica dei dati» . Questo non per assolvere il machine learning umanizzandone le fratture fondamentali, ma per riconoscere le condizioni estetiche e operative di tali sistemi. Come afferma Mackenzie, lavorare con i dati richiede un continuo movimento avanti e indietro tra domanda, ipotesi, dati, articolazione dell’informazione attraverso molteplici traduzioni mediatiche, e altri fattori.
Si potrebbe sostenere che, in un senso scientifico ideale, tutti questi fattori dovrebbero essere controllati. Le ramificazioni di un tale controllo – e, di conseguenza, la difficoltà di condurre un’indagine politica e pratica sul machine learning – sono considerevoli. Come osserva Mackenzie, esiste una pragmatica multiforme del machine learning che è essenziale prendere in considerazione, e che di per sé costituisce una forma di apprendimento.
E vi sono ulteriori complicazioni. Gli artisti hanno spesso lavorato sulle estetiche del glitch, del rumore, dell’interferenza, e così via. Questi elementi fanno parte della sostanza materiale idiomatica del computing. Tuttavia, come hanno spesso osservato archeologi e curatori dei media digitali, i dati archiviati su piattaforme centralizzate, o altrove, possono spesso andare perduti . In effetti, i processi stessi progettati per generare questi dati possono essere modificati più volte nell’arco di una sola giornata. Tali cambiamenti non sono sempre così rapidi, ma nel caso delle grandi digital enclosures sono spesso coperti da segreti commerciali. Così, sebbene queste piattaforme producano specifiche forme di accessibilità pubblica dei dati, il loro funzionamento rimane solo marginalmente pubblico. Questi mutamenti possono avvenire in base a un’oscillazione di enfasi in un piano aziendale, o a una variazione nel trattamento di specifiche tipologie di dati (ad esempio, dati considerati inaccessibili al pubblico in determinati territori) , oppure possono variare o arrestarsi in funzione di calcoli legati al valore percepito nel rivolgersi a determinati obiettivi, segmentazioni di utenti e altri fattori. Tali fattori complicano, ma al tempo stesso motivano, l’indagine programmatica sulla governance digitale attraverso l’investigazione macchinica delle macchine.
In un certo senso, una parte di ciò che fa il machine learning è virtualizzare e accelerare la condizione dell’ufficio, della burocrazia statale e degli archivi, come quelli della polizia o dei servizi di intelligence. Entrambi implicano molte linee d’indagine portate avanti in parallelo, valutate e continuamente focalizzate nel tempo, fino a giungere a una conclusione o a una classificazione. Oltre a essere legato al funzionamento della burocrazia, che del resto costituisce una delle radici fondamentali del computing, questo approccio è efficace perché consente di stabilire una distribuzione statistica più completa. Si possono effettuare molte migliaia, se non milioni, di indagini o test.
Ma si può anche dire che questa virtualizzazione della procedura d’ufficio liberi l’indagine, permettendole di adottare le prospettive più libere ed esplorative, proprie dell’occhio. Se il lavoro su larga scala e sistemico può essere automatizzato, allora le capacità estetiche umane possono concentrarsi su ciò che sanno fare meglio. Possiamo forse aspettarci l’emergere di ibridi innovativi tra indagine programmatica e curiosità motivata e ficcanaso. In effetti, l’OSInt pone le basi per nuove forme di investigazione collettiva che potrebbero svilupparsi a partire da tali ibridazioni.
La possibilità di testare i dati con un sensorio computazionale che – nei casi migliori – sia disallineato rispetto alle convenzioni dell’addestramento estetico umano, inclusi il ragionamento e le abitudini percettive, consente l’attivazione di un insieme più ampio di capacità estetiche. In questo senso, il machine learning rappresenta un modo per espandere l’ambito e la natura dell’apprendimento che un'investigazione necessariamente comporta.
[Testo pubblicato in M. Fuller e E. Weizman, Estetiche investigative. Brescia: Krisis Publishing, 2025. Titolo originale: "Machinic Investigation", in M. Fuller e E. Weizman, Invetigative Aesthetics. Londra: Verso Books, 2021]